우리는 Google에서 TPU를 사랑하지만, GPU도 훌륭하다. 이 장에서는 GPU의 세계를 깊이 파고든다 — 각 칩이 어떻게 동작하는지, 칩들이 어떻게 네트워크로 묶이는지, 그리고 그것이 특히 TPU와 비교해 LLM에 어떤 의미를 갖는지. NVIDIA, AMD, Intel 등 다양한 GPU 아키텍처가 있지만 여기서는 NVIDIA GPU에 집중한다. 이 장은 2장과 5장 위에 쌓아 올린 내용이므로 먼저 읽고 오기를 권한다.
GPU란 무엇인가?
현대의 ML GPU(예: H100, B200)는 기본적으로, 행렬 곱셈에 특화된 연산 코어들(Streaming Multiprocessor, 줄여서 SM)이 빠른 메모리 뭉치(HBM)에 연결된 구조다. 다이어그램으로 보면 다음과 같다:
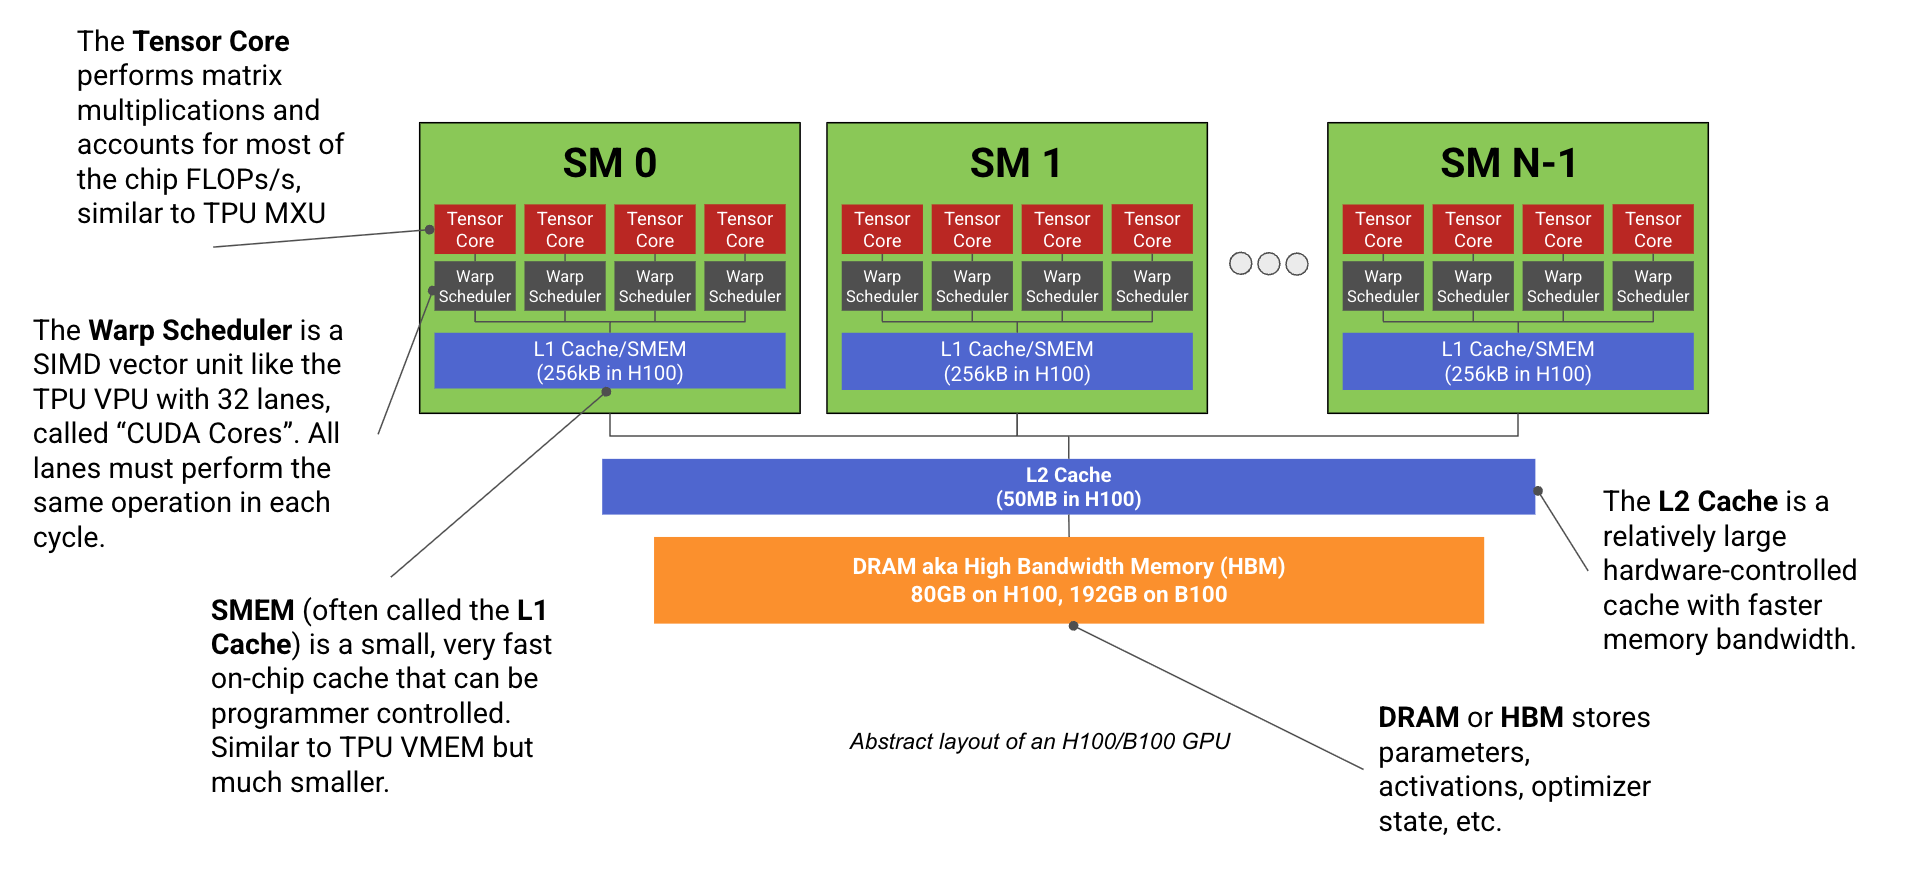
각 SM은 TPU의 Tensor Core처럼 전용 행렬 곱셈 코어(공교롭게도 이것 역시 Tensor Core라고 불린다1), 벡터 연산 유닛(Warp Scheduler라고 부른다2), 그리고 빠른 온칩 캐시(SMEM)를 가진다. 독립적인 “Tensor Core”가 많아야 2개인 TPU와 달리, 현대 GPU는 100개가 넘는 SM을 가진다(H100은 132개). 각 SM은 TPU Tensor Core보다 훨씬 약하지만, 시스템 전체로는 더 유연하다. 각 SM은 사실상 완전히 독립적이어서, GPU는 수백 개의 서로 다른 작업을 동시에 수행할 수 있다.3
H100 SM을 더 자세히 들여다보자:
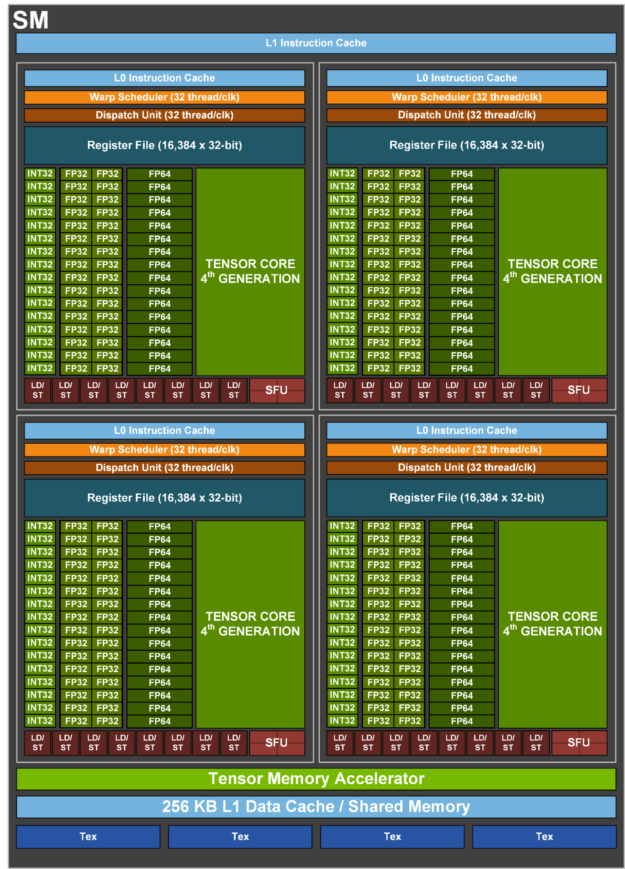
각 SM은 4개의 동일한 사분면으로 나뉘는데, NVIDIA는 이를 SM subpartition이라고 부른다. 각 subpartition은 Tensor Core, 16k개의 32비트 레지스터, 그리고 Warp Scheduler라 불리는 SIMD/SIMT 벡터 연산 유닛을 담고 있으며, 이 유닛의 lane(ALU)을 NVIDIA는 CUDA Core라고 부른다. 각 partition의 핵심 부품은 단연 Tensor Core다. 행렬 곱셈을 수행하며 FLOPs/s의 압도적 대부분을 담당한다. 하지만 눈여겨볼 부품이 그것만은 아니다.
-
CUDA Core: 각 subpartition에는 SIMD/SIMT 벡터 연산을 수행하는 CUDA Core라는 ALU 집합이 있다. 각 ALU는 일반적으로 사이클당 1개의 산술 연산(예: f32.add)을 수행할 수 있다.4 각 subpartition에는 32개의 fp32 코어(그리고 더 적은 수의 int32, fp64 코어)가 있고, 이들은 매 사이클 같은 명령을 실행한다. TPU의 VPU처럼 CUDA core는 ReLU, pointwise 벡터 연산, reduction(합산)을 담당한다.5
-
Tensor Core (TC): 각 subpartition은 자체 Tensor Core를 가지는데, TPU의 MXU 같은 전용 행렬 곱셈 유닛이다. Tensor Core는 GPU FLOPs/s의 압도적 대부분을 차지한다(예: H100은 990 bf16 TC TFLOP/s인데 CUDA core는 겨우 66 TFLOPs/s다).
- 990 bf16 TFLOPs/s를 1.76GHz로 도는 132개의 SM으로 나누면, 각 H100 TC는 사이클당
7.5e12 / 1.76e9 / 4 ~ 1024bf16 FLOPs, 대략 8x8x8 matmul을 수행할 수 있다.6 - TPU처럼 GPU도 더 낮은 정밀도의 matmul을 더 높은 처리량으로 수행할 수 있다(예: H100의 fp8 FLOPs/s는 fp16의 2배). 저정밀도 학습·서빙은 눈에 띄게 빨라질 수 있다.
- Volta 이후 각 GPU 세대는 이전 세대보다 TC 크기를 키워 왔다(이 주제에 관한 좋은 글). B200에 이르러 TC가 너무 커져 입력이 SMEM에 더 이상 들어가지 않게 되었고, 그래서 B200은 TMEM이라는 새 메모리 공간을 도입한다.7
- 990 bf16 TFLOPs/s를 1.76GHz로 도는 132개의 SM으로 나누면, 각 H100 TC는 사이클당
CUDA core는 TPU의 VPU보다 유연하다: GPU의 CUDA core는 (V100 이후) SIMT(Single Instruction Multiple Threads) 프로그래밍 모델을 쓰는데, TPU는 SIMD(Single Instruction Multiple Data) 모델이다. TPU VPU의 ALU처럼, 한 subpartition 안의 CUDA core들은 매 사이클 같은 연산을 실행해야 한다(예: 한 코어가 두 float를 더하고 있다면 그 subpartition의 다른 모든 CUDA core도 그렇게 해야 한다). 그러나 VPU와 달리 각 CUDA core(CUDA 프로그래밍 모델에서는 “thread”)는 자기만의 instruction pointer를 가지며 독립적으로 프로그래밍 될 수 있다. 같은 warp 안의 두 thread에게 서로 다른 연산이 지시되면, 사실상 두 연산 모두 를 수행하되 분기한 연산이 필요 없는 코어들을 마스킹 처리한다.
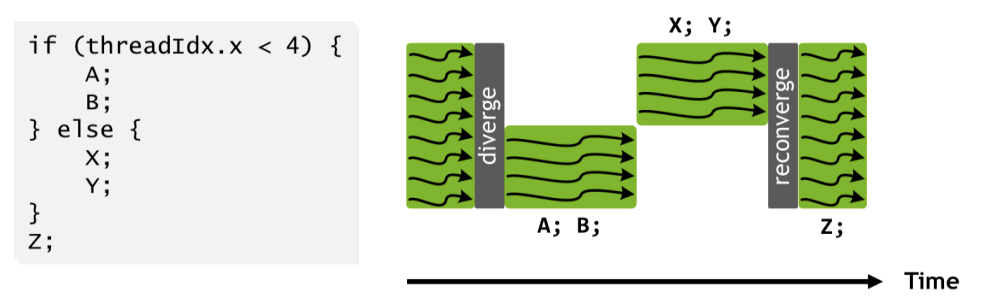
이 덕분에 thread 수준의 유연한 프로그래밍이 가능하지만, warp가 너무 자주 분기하면 성능이 소리 없이 떨어지는 대가를 치른다. thread는 접근할 수 있는 메모리 면에서도 더 유연하다. VPU는 연속된 메모리 블록에만 연산할 수 있지만, CUDA core는 공유 레지스터의 개별 float에 접근하고 thread별 상태를 유지할 수 있다.
CUDA core 스케줄링도 더 유연하다: SM은 멀티스레드 CPU와 약간 비슷하게 동작한다. 여러 프로그램(warp)을 동시에 “스케줄”할 수 있지만(SM당 최대 64개), 각 Warp Scheduler 는 한 클록 사이클에 단 하나의 프로그램만 실행한다.8 Warp Scheduler는 메모리 로드 같은 I/O 작업을 숨기기 위해 활성 warp 사이를 자동으로 전환한다. 이에 비하면 TPU는 대체로 단일 스레드다.
메모리
연산 유닛 외에도 GPU에는 메모리 계층이 있다. 가장 큰 것이 HBM(GPU 주 메모리)이고, 그다음으로 일련의 더 작은 캐시들(L2, L1/SMEM, TMEM, 레지스터 메모리)이 이어진다.
-
레지스터: 각 subpartition은 자체 register file을 가지며, H100/B200에서는 16,384개의 32비트 워드(SM당
4 * 16384 * 4 = 256kiB)를 CUDA core가 접근할 수 있다.- 각 CUDA core는 한 번에 최대 256개의 레지스터에만 접근할 수 있다. 그래서 SM당 최대 64개의 “resident warp”를 스케줄할 수 있어도, 각 thread가 256개의 레지스터를 쓴다면 한 번에 8개(
256 * 1024 / (4 * 32 * 256))밖에 들어가지 않는다.
- 각 CUDA core는 한 번에 최대 256개의 레지스터에만 접근할 수 있다. 그래서 SM당 최대 64개의 “resident warp”를 스케줄할 수 있어도, 각 thread가 256개의 레지스터를 쓴다면 한 번에 8개(
-
SMEM (L1 캐시): 각 SM은 SMEM이라는 256kB 온칩 캐시를 가지며, 프로그래머가 “shared memory”로 직접 제어하거나 하드웨어가 온칩 캐시로 사용할 수 있다. SMEM은 activation 저장과 TC matmul의 입력 공급에 쓰인다.
-
L2 캐시: 모든 SM은 약 50MB의 비교적 큰 L2 캐시를 공유하며9, 주 메모리 접근을 줄이는 데 쓴다.
- 크기는 TPU의 VMEM과 비슷하지만 훨씬 느리고 프로그래머가 제어할 수 없다. 그래서 L2 캐시가 잘 활용되도록 프로그래머가 메모리 접근 패턴을 손봐야 하는, 일종의 “유령 같은 원격 작용(spooky action at a distance)“이 생긴다.10
- NVIDIA는 자사 칩의 L2 bandwidth를 공개하지 않지만, 측정에 따르면 약 5.5TB/s다. HBM bandwidth의 약 1.6배지만 full-duplex이므로 실효 양방향 bandwidth는 3배에 가깝다. 이에 비해 TPU의 VMEM은 2배 크고 bandwidth도 훨씬 크다(약 40TB/s).
-
HBM: GPU의 주 메모리로, 모델 weight, gradient, activation 등을 저장한다.
- HBM 크기는 Volta의 32GB에서 Blackwell(B200)의 192GB까지 크게 늘었다.
- HBM에서 CUDA·Tensor Core로 가는 bandwidth를 HBM bandwidth 또는 memory bandwidth라고 부르며, H100에서 약 3.35TB/s, B200에서 약 9TB/s다.
GPU 스펙 요약
최근 모델들의 GPU 스펙 요약이다. SM 수, 클록 속도, FLOPs는 같은 GPU라도 변형(variant)에 따라 조금씩 다르다. 먼저 메모리 용량 수치다:
| GPU | 세대 | 클록 속도 | SMs/chip | SM당 SMEM 용량 | chip당 L2 용량 | chip당 HBM 용량 |
|---|---|---|---|---|---|---|
| V100 | Volta | 1.25GHz/1.38GHz | 80 | 96kB | 6MB | 32GB |
| A100 | Ampere | 1.10GHz/1.41GHz | 108 | 192kB | 40MB | 80GB |
| H100 | Hopper | 1.59GHz/1.98GHz | 132 | 256kB | 50MB | 80GB |
| H200 | Hopper | 1.59GHz/1.98GHz | 132 | 256kB | 50MB | 141GB |
| B200 | Blackwell | ? | 148 | 256kB | 126MB | 192GB |
모든 세대가 SM당 256kB의 레지스터 메모리를 가진다. Blackwell은 여기에 SM당 256kB의 TMEM을 추가한다. 다음은 칩별 FLOPs와 bandwidth 수치다:
| GPU | 세대 | chip당 HBM BW | chip당 FLOPs/s (bf16/fp16) | chip당 FLOPs/s (fp8/int8) | chip당 FLOPs/s (fp4) |
|---|---|---|---|---|---|
| V100 | Volta | 9.0e11 | — | — | — |
| A100 | Ampere | 2.0e12 | 3.1e14 | 6.2e14 | — |
| H100 | Hopper | 3.4e12 | 9.9e14 | 2.0e15 | — |
| H200 | Hopper | 4.8e12 | 9.9e14 | 2.0e15 | — |
| B200 | Blackwell | 8.0e12 | 2.3e15 | 4.5e15 | 9.0e15 |
B100은 대량 생산되지 않았으므로 제외했다.11 NVIDIA GPU는 TPU만큼 표준화되어 있지 않아, 일부 스펙은 GPU의 정확한 버전에 따라 조금씩 달라진다.
GPU와 TPU 부품을 비교하는 유용한 치트 시트다:
| GPU | TPU | 무엇인가? |
|---|---|---|
| Streaming Multiprocessor (SM) | Tensor Core | 다른 유닛들을 담는 핵심 “셀” |
| Warp Scheduler | VPU | SIMD 벡터 연산 유닛 |
| CUDA Core | VPU ALU | SIMD ALU |
| SMEM (L1 캐시) | VMEM | 빠른 온칩 캐시 메모리 |
| Tensor Core | MXU | 행렬 곱셈 유닛 |
| HBM (일명 GMEM) | HBM | 고대역폭 대용량 메모리 |
칩 수준에서 본 GPU vs. TPU
GPU는 비디오 게임 렌더링에서 출발했지만, 2010년대에 딥러닝이 도약한 뒤로는 점점 더 전용 행렬 곱셈 기계처럼 — 다시 말해 점점 더 TPU처럼 — 행동하기 시작했다.12 어느 정도는 이 역사가 현대 GPU가 지금의 모습을 하고 있는 이유를 설명해 준다. GPU는 순전히 LLM이나 ML 모델만을 위해서가 아니라 범용 가속기로 설계되었고, 하드웨어는 축복이자 저주가 될 수 있는 수준의 “범용성”을 지향한다. GPU는 새 작업에 적용했을 때 “그냥 되는” 경우가 훨씬 많고, TPU에 비해 좋은 컴파일러에 훨씬 덜 기댄다. 하지만 바로 그 때문에 추론하기도, roofline 성능을 뽑아내기도 훨씬 어렵다. 너무 많은 컴파일러 기능이 병목을 일으킬 수 있기 때문이다.
GPU는 더 모듈화되어 있다. TPU는 1~2개의 큰 Tensor Core를 갖는 반면, GPU는 수백 개의 작은 SM을 가진다. 마찬가지로 TPU의 각 TC는 독립적으로 프로그래밍 가능한 8x128 유닛 4개(총 4096개의 ALU)로 구성된 하나의 큰 VPU를 갖지만, H100은 132 * 4 = 528개의 독립 SIMD 유닛을 갖고 각각이 32-wide다(총 16k ALU). 이 점을 부각하는 GPU 대 TPU 1:1 비교표다:
| GPU | TPU | H100 개수 | TPU v5p 개수 |
|---|---|---|---|
| SM (streaming multiprocessor) | Tensor Core | 132 | 2 |
| Warp Scheduler | VPU 슬롯 | 528 | 8 |
| SMEM (L1 캐시) | VMEM | 32MB | 128MB |
| 레지스터 | 벡터 레지스터 (VRegs) | 32MB | 256kB |
| Tensor Core | MXU | 528 | 8 |
이 모듈성의 차이 덕분에 TPU는 만들기 훨씬 싸고 이해하기 단순하지만, 그만큼 컴파일러가 옳은 일을 해야 한다는 부담이 커진다. TPU는 제어 스레드가 하나뿐이고 VPU 폭 전체에 걸친 벡터화된 명령만 지원하므로, 컴파일러가 모든 메모리 로드와 MXU/VPU 작업을 stall이 없도록 수동으로 pipeline해야 한다. GPU 프로그래머는 그냥 수십 개의 서로 다른 kernel을 띄우면 되고, 각각이 완전히 독립적인 SM에서 돈다. 그 대신 그 kernel들은 L2 캐시를 서로 짓밟거나(thrashing) 메모리 로드를 모으지(coalesce) 못해 끔찍한 성능을 낼 수도 있다. 하드웨어가 런타임의 너무 많은 부분을 통제하기 때문에 뒤에서 무슨 일이 벌어지는지 추론하기 어려워진다. 그 결과 TPU는 대체로 더 적은 노력으로 peak roofline 성능에 더 가까이 간다.
역사적으로 개별 GPU는 비슷한 TPU보다 강력하고 비싸다: H200 한 장은 TPU v5p의 거의 2배 FLOPs/s와 1.5배 HBM을 가진다. 그러면서 Google Cloud 정가는 H200이 시간당 약 10달러, TPU v5p가 약 4달러다. TPU는 일반적으로 여러 칩을 네트워크로 묶는 데 GPU보다 더 크게 의존한다.
TPU는 빠른 캐시 메모리가 훨씬 많다. TPU의 VMEM은 GPU의 SMEM(+TMEM)보다 훨씬 크고, 이 메모리에 weight와 activation을 저장해 두면 극도로 빠르게 로드해 쓸 수 있다. 모델 weight를 VMEM에 상주시키거나 꾸준히 prefetch할 수 있다면 LLM 추론에서 TPU가 더 빨라지는 이유다.
퀴즈 1: GPU 하드웨어
위 내용을 점검하는 연습 문제들이다. 정답이 달려 있지만, 보기 전에 펜과 종이를 들고 직접 풀어 보는 것이 좋다.
문제 1 [CUDA core]: H100에는 fp32 CUDA core(ALU)가 몇 개 있는가? B200은? TPU v5p의 독립 ALU 수와 비교하면 어떤가?
정답 보기
정답: H100은 132개의 SM에 각각 4개의 subpartition이 있고 subpartition마다 32개의 fp32 CUDA core가 있으므로 132 * 4 * 32 = 16896개의 CUDA core를 가진다. B200은 SM이 148개이므로 총 18944개다. TPU v5p는 (보통 Megacore로 연결된) TensorCore 2개를 갖고, 각각의 VPU는 (8, 128) lane에 lane당 4개의 독립 ALU가 있으므로 2 * 4 * 8 * 128 = 8192개의 ALU다. H100의 벡터 lane 수의 대략 절반이며, 클록 주파수는 대략 비슷하다.
문제 2 [벡터 FLOPs 계산]: H100 한 장은 132개의 SM을 갖고 1.59GHz 클록(boost 시 최대 1.98GHz)으로 동작한다. ALU당 사이클당 벡터 연산 1개를 할 수 있다고 하자. 초당 벡터 fp32 FLOPs는 얼마인가? boost 시에는? matmul FLOPs와 비교하면?
정답 보기
정답: 132 * 4 * 32 * 1.59e9 = 26.9TFLOPs/s. boost 시 33.5 TFLOPs/s다. 스펙 시트에 보고된 값의 절반인데, 엄밀히는 한 사이클에 FMA(fused-multiply-add)를 할 수 있고 이것이 2 FLOPs로 계산되기 때문이다. 다만 대부분의 경우 이는 쓸모가 없다. bfloat16 matmul은 990 TFLOPs/s를 할 수 있으므로, FMA를 무시하면 Tensor Core가 약 30배 더 많은 FLOPs/s를 낸다.
문제 3 [GPU matmul intensity]: H100의 peak fp16 matmul intensity는 얼마인가? B200은? fp8은? 여기서 intensity란 matmul FLOPs/s를 메모리 bandwidth로 나눈 비율을 뜻한다.
정답 보기
정답: H100은 peak 990e12 fp16 FLOPs와 3.35e12 bytes/s의 bandwidth를 가진다. 따라서 임계 intensity는 990e12 / 3.35e12 = 295로, TPU의 240과 꽤 비슷하다. B200은 2250e12 / 8e12 = 281로 매우 비슷하다. TPU와 마찬가지로, matmul에서 compute-bound가 되려면 batch size가 280 안팎이어야 한다.
H100과 B200 모두 fp8 FLOPs는 정확히 2배이므로 peak intensity도 각각 590과 562로 2배가 된다. 다만 weight도 fp8로 로드될 가능성이 높다는 점을 감안하면 어떤 의미에서는 그대로라고 볼 수 있다.
문제 4 [Matmul 실행 시간]: 문제 3의 답을 이용해, B200 한 장에서 fp16[64, 4096] * fp16[4096, 8192] matmul이 얼마나 걸릴지 추정해 보라. fp16[512, 4096] * fp16[4096, 8192]는?
정답 보기
위에서 batch size 281 토큰 아래에서는 communication-bound임을 알았다. 따라서 첫 번째는 순전히 bandwidth-bound다. 읽고 쓰는 바이트는 (2*64*4096 + 2*4096*8192 + 2*64*8192=69e6)이고 bandwidth는 8e12 bytes/s이므로 약 69e6 / 8e12 = 8.6us가 걸린다. 실제로는 전체 bandwidth의 일부만 얻을 가능성이 높아 10-12us에 가까울 것이다. batch size를 키우면 완전히 compute-bound가 되므로 T=2*512*4096*8192/2.3e15=15us를 기대한다. 역시 전체 FLOPs의 일부만 나오리라 예상되므로 실제로는 20us에 가까울 수 있다.
문제 5 [L1 캐시 용량]: H100의 총 L1/SMEM 용량은 얼마인가? 레지스터 메모리는? TPU의 VMEM 용량과 비교하면?
정답 보기
정답: SM당 256kB SMEM과 256kB 레지스터 메모리가 있으므로 각각 약 33MB(132 * 256kB)다. 합치면 총 약 66MB. 현대 TPU VMEM 120MB의 절반 정도인데, TPU의 레지스터 메모리는 전부 합쳐 256kB뿐이다! TPU의 VMEM latency는 SMEM latency보다 낮으며, TPU에서 레지스터 메모리가 그리 중요하지 않은 이유 중 하나다(VMEM으로의 spill/fill이 싸다).
문제 6 [B200 클록 주파수 계산]: NVIDIA는 여기서 B200이 80TFLOPs/s의 벡터 fp32 연산을 할 수 있다고 보고한다. 각 CUDA core가 FMA(fused multiply add) 연산으로 사이클당 2 FLOPs를 수행할 수 있다고 할 때, peak 클록을 추정해 보라.
정답 보기
정답: CUDA core가 148 * 4 * 32 = 18944개이므로 사이클당 18944 * 2 = 37888 FLOPs를 할 수 있다. 따라서 80e12 / 37888 = 2.1GHz로, 높지만 그럴듯한 peak 클록 속도다. B200은 대체로 수랭식이라 더 높은 클록도 무리가 아니다.
문제 7 [H100 덧셈 실행 시간 추정]: 위 수치들을 이용해, H100 한 장에서 두 fp32[N] 벡터를 더하는 데 걸리는 시간을 계산하라. 와 를 모두 계산하라. 이 연산의 arithmetic intensity는 얼마인가? 가능하다면 N = 1024와 N=1024 * 1024 * 1024에 대해 PyTorch나 JAX에서도 직접 돌려 보라. 결과가 어떻게 비교되는가?
정답 보기
정답: 먼저, 두 fp32[N] 벡터의 덧셈은 N FLOPs를 수행하고, 4 * N * 2 바이트를 로드하고 4 * N 바이트를 다시 써야 하므로 총 3 * 4 * N = 12N 바이트다. 비율을 구하면 총 FLOPs / 총 바이트 = N / 12N = 1 / 12로, 꽤 처참하다.
위에서 계산했듯 FMA를 무시하면 boost 시 약 33.5 TFLOPs/s를 낼 수 있다. 모든 CUDA core가 쓰일 때 얘기다. N = 1024라면 많아야 1024개의 CUDA core, 즉 8개의 SM밖에 쓸 수 없어 더 오래 걸린다(compute-bound라고 가정하면 대략 16배). 메모리 bandwidth는 3.35e12 bytes/s다. 따라서 peak 하드웨어 intensity는 33.5e12 / 3.35e12 = 10이다.13 그러니 끔찍하게 comms-bound가 된다. 실행 시간은 그냥
N = 65,536이면 약 0.23us다. 실제 JAX에서는 약 1.5us가 나오는데, 이 구간에서는 latency에 심하게 묶일 것으로 예상되므로 괜찮은 결과다. N = 1024 * 1024 * 1024이면 roofline이 약 3.84ms이고 실측은 4.1ms다. 훌륭하다!
네트워킹
네트워킹은 GPU와 TPU가 가장 크게 갈라지는 영역 중 하나다. 앞서 봤듯 TPU는 2D 또는 3D torus로 연결되며, 각 TPU는 이웃하고만 연결된다. 두 TPU 사이의 메시지는 중간의 모든 TPU를 거쳐야 하고, mesh 위에서는 균일한 통신 패턴만 쓸 수밖에 없다. 어떤 면에서는 불편하지만, 그 덕에 TPU당 링크 수가 일정하고 bandwidth 손실 없이 임의로 큰 TPU “pod”로 확장할 수 있다.
반면 GPU는 더 전통적인 계층적 트리 기반 스위칭 네트워크를 쓴다. 8개의 GPU 집합(GB200은 최대 72개14)인 node가 NVLink라는 고대역폭 인터커넥트로 서로 1 hop 안에 연결되고, 이 node들이 GPU마다 붙은 NIC을 통해 더 낮은 bandwidth의 InfiniBand(IB) 또는 Ethernet 네트워크로 더 큰 단위(SU, Scalable Unit)로 묶인다. 이들은 다시 상위 스위치들로 임의의 크기까지 연결될 수 있다.
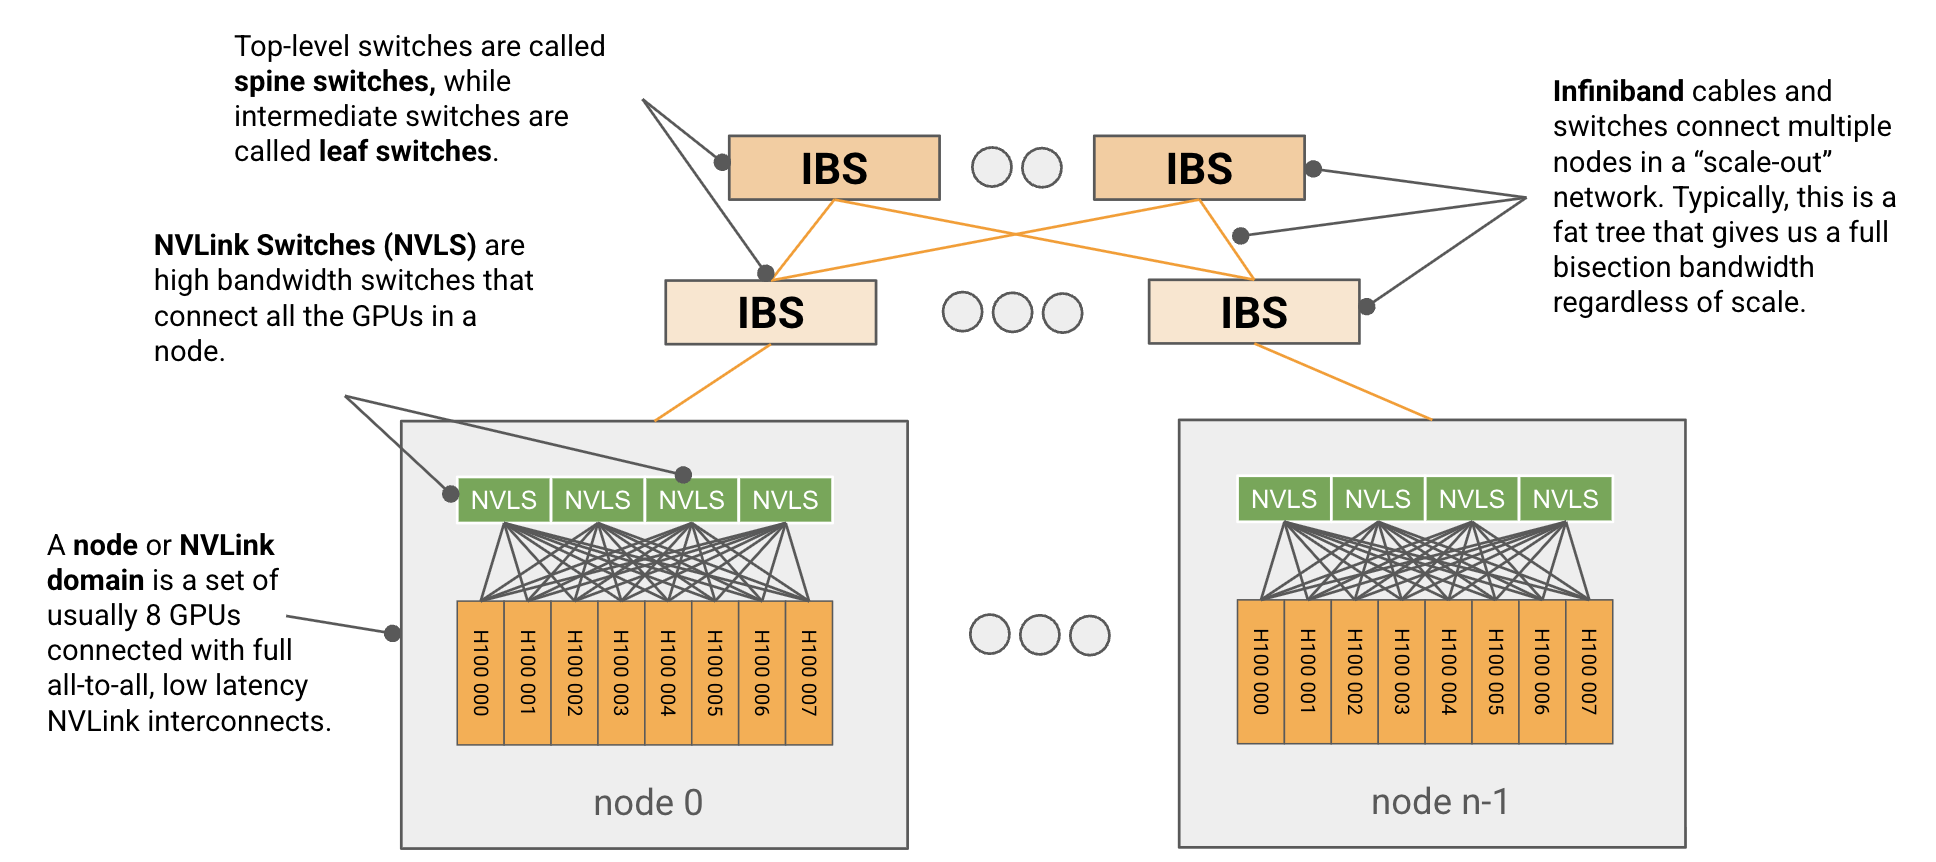
node 수준
GPU node는 보통 8개의 GPU(GB200은 최대 72개)로 이루어진 작은 단위로, all-to-all·full-bandwidth·저지연 NVLink 인터커넥트로 연결된다.15 각 node에는 로컬 GPU들 사이에서 패킷을 스위칭하는 고대역폭 NVSwitch가 여러 개 있다. node 수준 토폴로지 자체는 node당 스위치 수를 포함해 시간이 지나며 꽤 바뀌어 왔는데, H100의 경우 node당 4개의 NVSwitch가 있고 GPU들이 5 + 4 + 4 + 5 링크 패턴으로 연결된다:
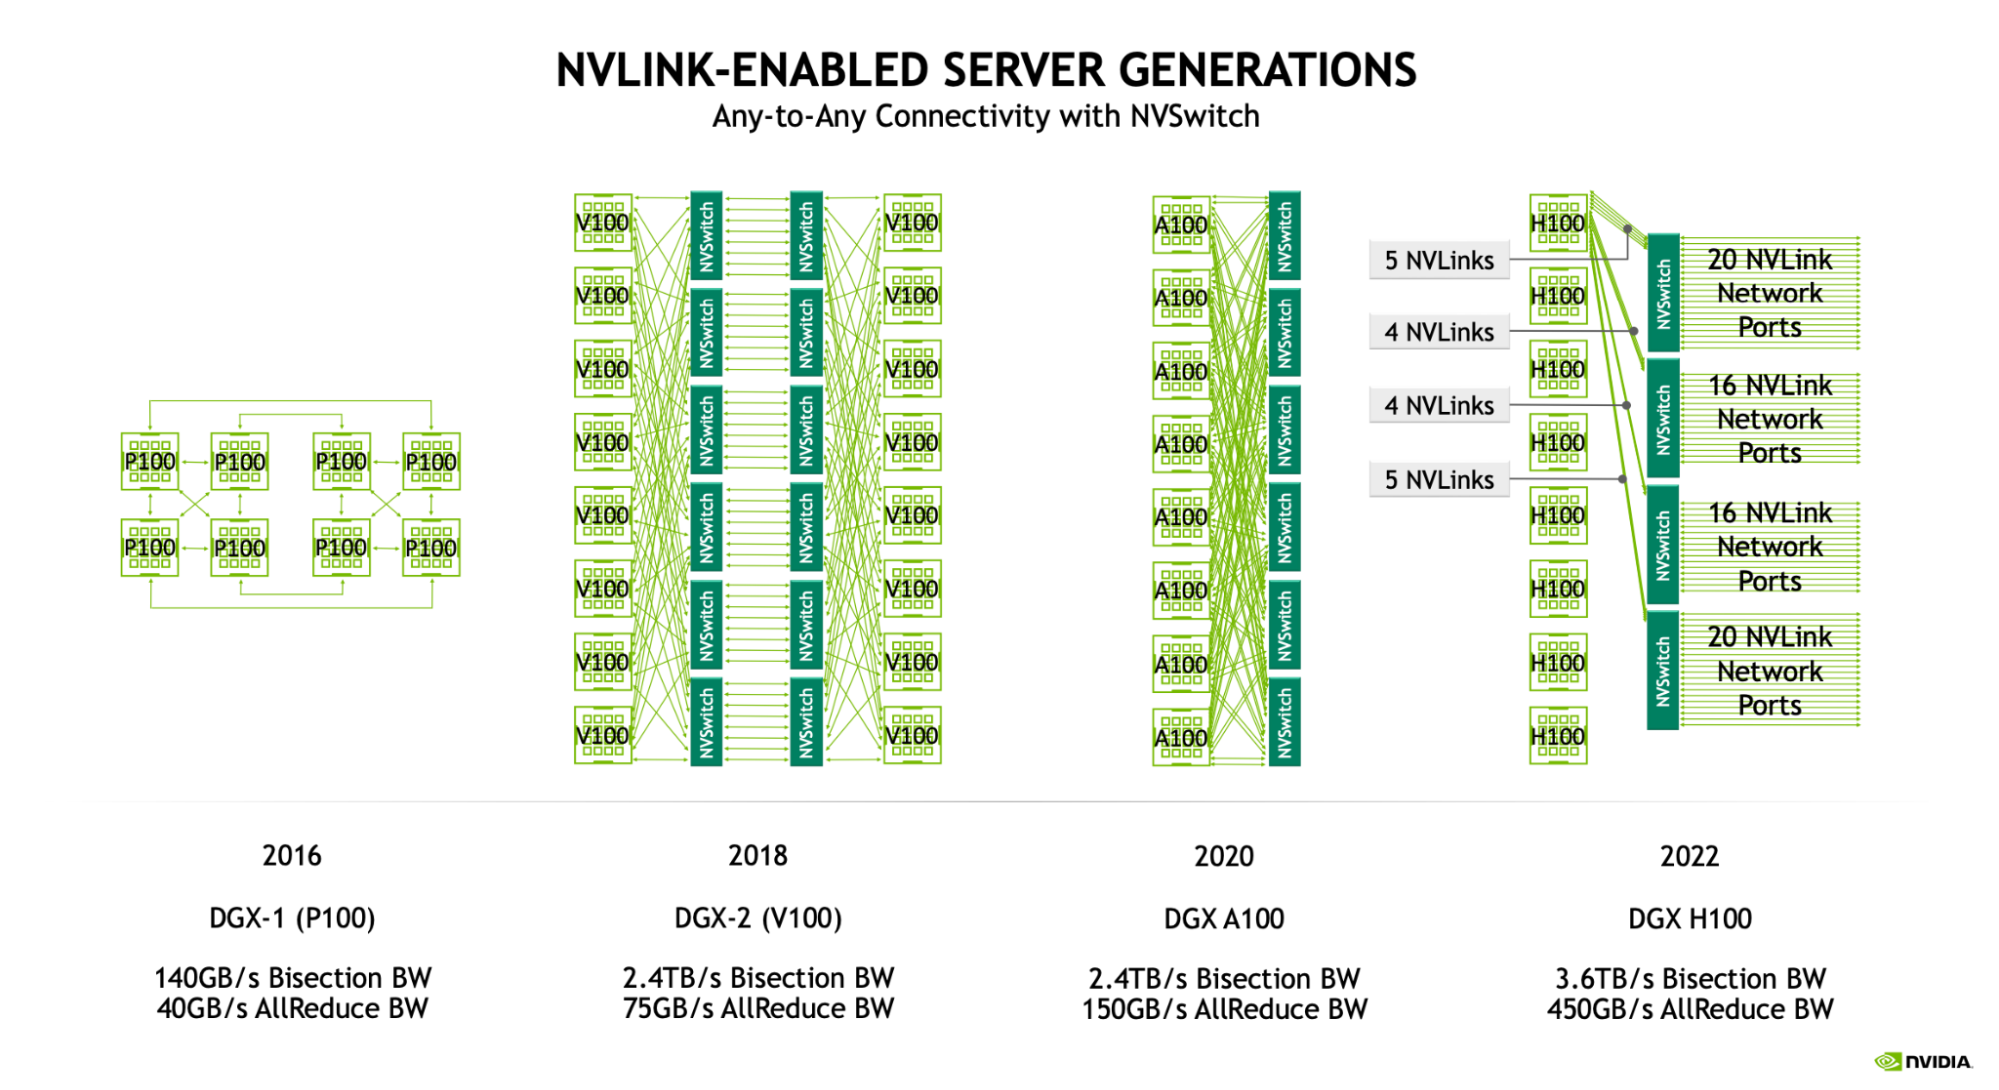
Hopper 세대(NVLink 4.0)에서 각 NVLink 링크는 25GB/s의 full-duplex16 bandwidth를 가지며(B200은 50GB/s), 각 GPU에서 네트워크로 18 * 25=450GB/s의 full-duplex bandwidth가 나온다. 거대한 NVSwitch는 NVLink 포트를 최대 64개 갖고 있어, 스위치 4개짜리 8xH100 node는 최대 64 * 25e9 * 4=6.4TB/s의 bandwidth를 처리할 수 있다. 이 수치들이 GPU 세대에 따라 어떻게 변해 왔는지 요약하면:
| NVLink 세대 | NVSwitch 세대 | GPU 세대 | NVLink Bandwidth (GB/s, full-duplex) | GPU당 NVLink 포트 | node의 GPU-to-GPU bandwidth (GB/s full-duplex) | node 크기 (NVLink 도메인) | node당 NVSwitch |
|---|---|---|---|---|---|---|---|
| 3.0 | 2.0 | Ampere | 25 | 12 | 300 | 8 | 6 |
| 4.0 | 3.0 | Hopper | 25 | 18 | 450 | 8 | 4 |
| 5.0 | 4.0 | Blackwell | 50 | 18 | 900 | 8/72 | 2/18 |
Blackwell(B200)의 node는 GPU 8개다. GB200NVL72는 GPU 72개의 더 큰 NVLink 도메인을 지원한다. 표에는 8-GPU와 72-GPU 시스템 모두의 값을 적었다.
퀴즈 2: GPU node
네트워킹에 관한 문답을 더 풀어 보자. 실제 통신 패턴을 손으로 따라가게 만들기 때문에 특히 유용하다고 생각한다.
문제 1 [H100 node의 총 bandwidth]: 스위치 4개짜리 8xH100 node에서 node당 총 bandwidth는 얼마인가? 힌트: NVLink bandwidth와 NVSwitch bandwidth를 모두 고려하라.
정답 보기
정답: Gen4 NVSwitch 4개가 있고 각각 64 * 25e9=1.6TB/s의 단방향 bandwidth를 가진다. 그러면 스위치 수준에서는 4 * 1.6e12=6.4e12의 bandwidth다. 그러나 각 GPU는 단방향 450GB/s밖에 처리하지 못하므로 최대 450e9 * 8 = 3.6TB/s다. 이쪽이 더 작으므로 peak bandwidth는 3.6TB/s다.
문제 2 [Bisection bandwidth]: bisection bandwidth란 네트워크를 임의로 균등하게 둘로 나눴을 때 그 사이에 존재하는 최소 bandwidth로 정의된다. 즉 네트워크를 같은 크기의 두 절반으로 쪼개면 두 절반 사이를 얼마나 많은 bandwidth가 오갈 수 있는가? 8x H100 node의 bisection bandwidth를 계산할 수 있는가? 힌트: bisection bandwidth는 보통 양방향 흐름을 포함한다.
정답 보기
정답: 어떻게 균등 분할하든 각 절반에 GPU 4개가 있고, 각각 반대편 절반으로 4 * 450GB/s를 egress할 수 있다. 양방향 흐름을 합치면 분할면을 가로지르는 바이트는 8 * 450GB/s, 즉 3.6TB/s의 bisection bandwidth다. NVIDIA가 여기 등에서 보고하는 값과 같다.
문제 3 [AllGather 비용]: B 바이트짜리 배열이 있을 때, 8xH100 node에서 (throughput-bound) AllGather는 얼마나 걸리는가? bf16[DX, F], D=4096, F=65,536에 대해 계산해 보라. 답하기 전에 TPU collective 섹션을 읽어 두면 좋다. 여기서 한 번 생각해 보되, collective는 바로 다음에 훨씬 자세히 다룬다.
정답 보기
정답: 각 GPU는 450GB/s를 egress할 수 있고, 각 GPU는 바이트를 갖고 있다(N=8, node 크기). 각 node가 자기 바이트를 나머지 개의 node에 차례로 보낸다고 상상하면, 총 (N - 1)번의 턴이 있고 각 턴은 이므로 이다. 근사하면 , 즉 다.
주어진 배열은 B = 4096 * 65536 * 2 = 536e6 바이트이므로 총 시간은 536e6 * (8 - 1) / (8 * 450e9) = 1.04ms(근사로는 536e6 / 450e9 = 1.19ms)다. latency-bound일 수 있어 실제로는 이보다 오래 걸릴 수 있다(실측 약 1.5ms).
node 수준 너머
node 수준을 넘어가면 GPU 네트워크의 토폴로지는 덜 표준화되어 있다. NVIDIA는 단일 node보다 큰 GPU 집합을 InfiniBand로 연결하는 참조 DGX SuperPod 아키텍처를 공개하지만, 고객과 데이터센터 사업자는 필요에 맞게 얼마든지 바꿀 수 있다.17
다음은 참조 1024-GPU H100 시스템의 다이어그램이다. 맨 아랫줄의 각 상자는 GPU 8개, 400Gbps CX7 NIC 8개(GPU당 1개), NVSwitch 4개를 가진 8xH100 node 하나다.
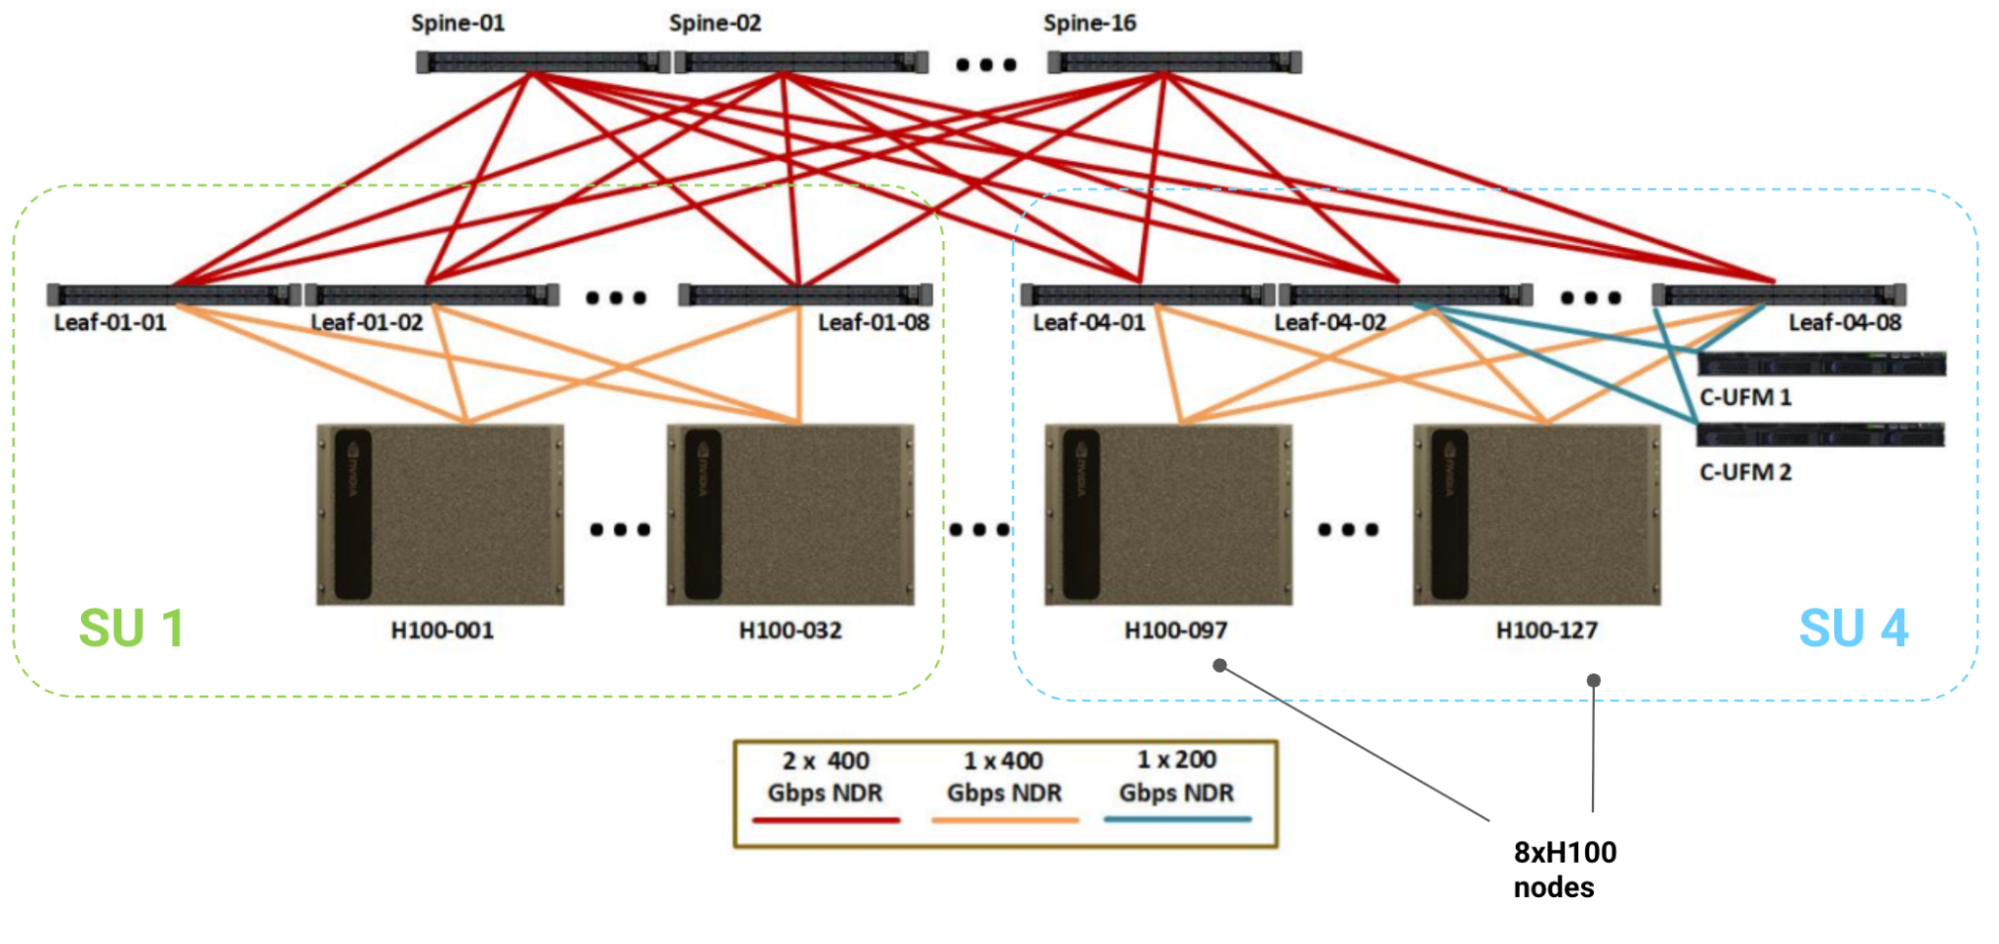
Scalable Unit: node 32개의 집합을 “Scalable Unit”(SU)이라고 부르며, 8개의 leaf InfiniBand 스위치 아래에 놓인다. 이 SU는 GPU 256개, node당 NVSwitch 4개, InfiniBand leaf 스위치 8개를 가진다. 그림의 모든 케이블은 InfiniBand NDR(50GB/s full-duplex)이고 스위치는 64포트 NDR IB 스위치(포트당 역시 50GB/s)다. IB 스위치가 NVSwitch의 2배 bandwidth(400 Gbps 링크 64포트)를 가진다는 점에 주목.
SuperPod: 전체 SuperPod는 이런 SU 4개를 최상위 “spine” IB 스위치 16개로 연결한다. 그러면 GPU 1024개에 node 수준 NVSwitch 512개, leaf IB 스위치 32개, spine IB 스위치 16개 — 총 512 + 32 + 16 = 560개의 스위치다. leaf 스위치는 node 32개 단위로 node들과 연결되므로 GPU 256개 집합마다 leaf 스위치 8개가 있다. 모든 leaf 스위치는 모든 spine 스위치와 연결된다.
bandwidth는 얼마나 되는가? InfiniBand 네트워크(“scale-out 네트워크”라고 부른다)의 전체 토폴로지는 fat tree로, 케이블과 스위치가 node 수준 위에서 full bisection bandwidth(여기서는 400GB/s)를 보장한다. node들을 절반으로 나누면 각 node는 동시에 반대편 파티션의 node로 400GB/s를 egress할 수 있다. 더 중요하게는, scale-out 네트워크에서 AllReduce bandwidth가 대략 일정하다는 말이다! 실제 구현이 그렇지 않을 수는 있지만, scale-out 네트워크의 임의 개수 node에 대해 — 모든 node를 포함하는 ring을 만들 수 있으므로 — ring reduction을 한다고 상상해도 된다.
| 계층 | GPU 수 | 단위당 스위치 수 | 스위치 종류 | 단위당 Bandwidth (TB/s, full-duplex) | GPU-to-GPU Bandwidth (GB/s, full-duplex) | Fat Tree Bandwidth (GB/s, full-duplex) |
|---|---|---|---|---|---|---|
| Node | 8 | 4 | NVL | 3.6 | 450 | 450 |
| Leaf | 256 | 8 | IB | 12.8 | 50 | 400 |
| Spine | 1024 | 16 | IB | 51.2 | 50 | 400 |
비교하자면 TPU v5p는 링크당 약 90GB/s의 egress bandwidth, 3D torus의 모든 axis를 합치면 540GB/s를 가진다. 점대점(point-to-point)이 아니어서 제한적이고 균일한 통신 패턴에만 쓸 수 있지만, 그래도 임의로 큰 토폴로지(적어도 TPU 8960개까지)로 확장 가능한 훨씬 높은 TPU-to-TPU bandwidth를 제공한다.
GPU 스위칭 패브릭은 이론상 스위치나 간접 계층을 더 얹어 임의의 크기로 확장할 수 있다. 대신 latency가 늘고 값비싼 네트워크 스위치가 추가된다.
요점(Takeaway): H100 node 안에서는 GPU마다 450GB/s의 full fat tree bandwidth를 갖지만, node를 넘어가면 node 간 400GB/s로 떨어진다. 이것이 통신 프리미티브에 결정적으로 작용한다.
GB200 NVL72: NVIDIA는 최근 GPU 72개를 GPU-to-GPU 900GB/s의 단일 NVLink 도메인으로 묶는 GB200 NVL72 GPU 클러스터를 생산하기 시작했다. 이 도메인들은 비례해서 더 높은(9배) IB fat tree bandwidth로 더 큰 SuperPod로 연결될 수 있다. 그 토폴로지의 다이어그램이다:
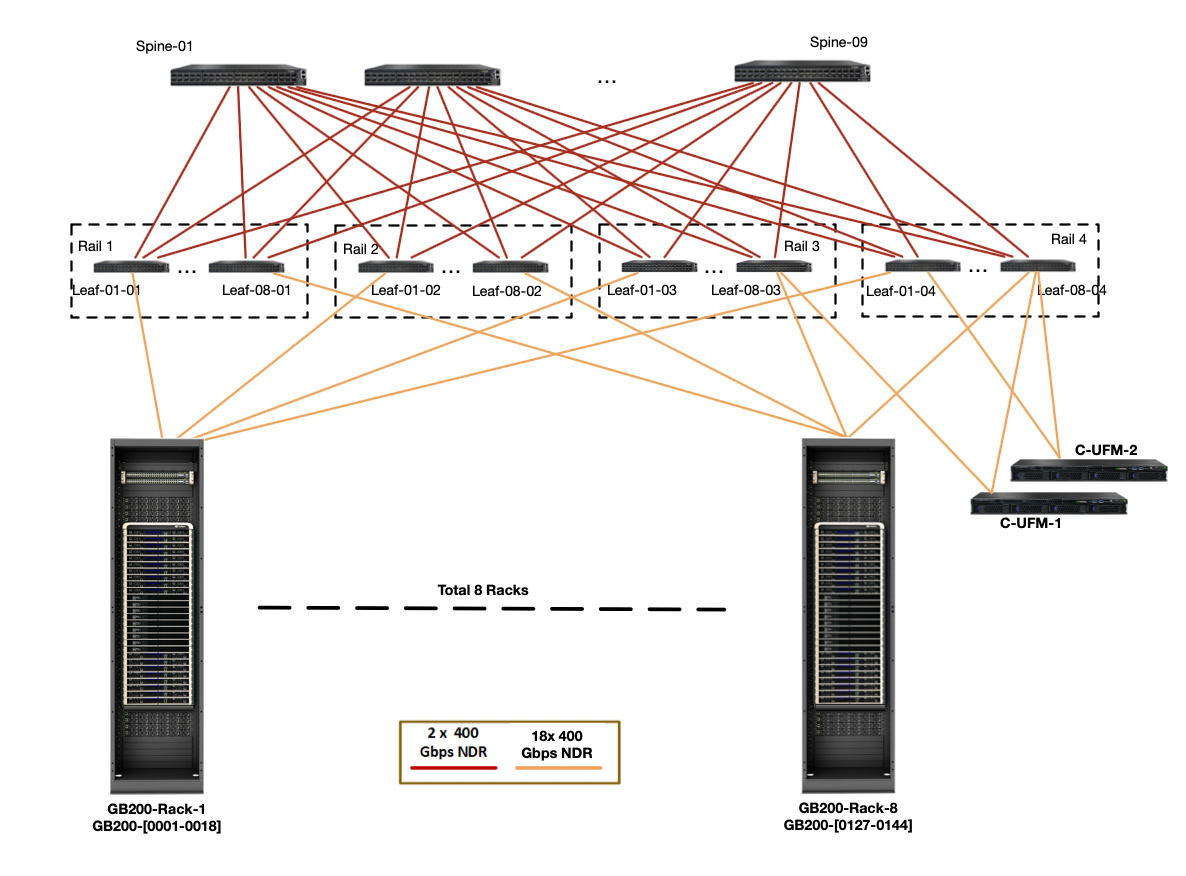
단일 node의 egress bandwidth(위 그림의 주황 선)를 세어 보면 leaf 계층으로 4 * 18 * 400 / 8 = 3.6TB/s가 나오는데, H100의 9배다(node가 담는 GPU 수도 정확히 9배다). 임계 node egress bandwidth가 훨씬, 훨씬 높아지고, node 간 collective bandwidth가 node 내부보다 오히려 낮아질 수도 있다. 자세한 논의는 아래 부록 A를 보라.
| Node 종류 | node당 GPU | GPU egress bandwidth | Node egress bandwidth |
|---|---|---|---|
| H100 | 8 | 450e9 | 400e9 |
| B200 | 8 | 900e9 | 400e9 |
| GB200 NVL72 | 72 | 900e9 | 3600e9 |
요점(Takeaway): GB200 NVL72 SuperPod는 node 크기와 node egress bandwidth를 극적으로 키워 roofline을 크게 바꾼다.
퀴즈 3: node 수준 너머
문제 1 [Fat tree 토폴로지]: 위의 DGX H100 다이어그램을 이용해 1024-GPU pod 전체의 node 수준 bisection bandwidth를 계산하라. 각 링크의 bandwidth가 full bisection bandwidth를 보장하도록 선택되었음을 보여라. 힌트: 링크 bandwidth와 스위치 bandwidth를 모두 계산할 것.
정답 보기
정답: 구성 요소별로 해 보자:
- 먼저 각 node는 8개의 400Gbps NDR IB 케이블로 leaf 스위치에 연결되므로 node당
8 * 400 / 8 = 400 GB/s의 leaf 방향 bandwidth를 가진다. leaf 스위치는 8개이고 각각 3.2TB/s(400 GBps 링크 64개)지만, SU에서 들어오는 ingress로는 64개 포트 중 32개만 쓸 수 있으므로 node 32개에 대해32 * 400 / 8 = 12.8TB/s, 역시 정확히 400GB/s다. - 그다음 spine 수준에서는 각 SU를 spine에 연결하는
8 * 16 * 2개의 400Gbps NDR IB 케이블이 있어 SU당8 * 16 * 2 * 400 / 8 = 12.8 TB/s의 bandwidth를 가진다. 역시 node당 400GB/s다. spine 스위치는 16개이고 각각 3.2TB/s이므로16 * 3.2 = 51.2 TB/s, 128개 node로 나누면 또 400GB/s다.
따라서 node들을 어떤 식으로 이등분하든 그 사이에 node당 400GB/s가 있다. 모든 구성 요소가 fat tree를 보장하는 데 딱 필요한 만큼의 bandwidth를 가진다.
문제 2 [더 큰 DGX pod로 확장]: 1024개가 아니라 2048개의 GPU로 학습하고 싶다고 하자. 위 DGX 토폴로지를 어떻게 고치는 것이 가장 단순하고 좋은 방법일까? 4096개라면? 힌트: 정답이 하나로 정해진 건 아니지만 비용을 낮게 유지하려고 해 보라. 링크 용량을 염두에 두라. 이 문서가 도움이 될 수 있다.
정답 보기
정답: 한 가지 방법은 SU 구조(스위치 8개 아래 node 32개)를 그대로 두고, SU를 더 만들고 최상위 스위치를 더 다는 것이다. spine 스위치가 2배 필요하므로 SU 8개에 spine 스위치 32개면 bandwidth가 충분하다.
한 가지 문제는 leaf 스위치당 포트가 64개뿐이고 위 다이어그램에서 이미 전부 쓰고 있다는 점이다. 대신 spine당 2x가 아니라 1x 400 Gbps NDR 케이블을 쓰면 총 bandwidth는 같으면서 포트를 아낄 수 있다.
4096 GPU에서는 실제로 포트가 바닥나므로 간접 계층을 하나 더, 즉 계층 구조에 한 단계를 추가해야 한다. NVIDIA는 이를 “core 스위치”라고 부르며, spine 스위치 128개와 core 스위치 64개로 4096 GPU 클러스터를 구성한다. 계산해 보면 bandwidth가 충분함을 보일 수 있다.
GPU에서 collective는 어떻게 동작하는가?
GPU는 TPU와 똑같은 collective를 전부 수행할 수 있다: ReduceScatter, AllGather, AllReduce, AllToAll. TPU와 달리 이들의 동작 방식은 node 수준(NVLink 위)에서 수행되는지 그 위(InfiniBand 위)에서 수행되는지에 따라 달라진다. 이 collective들은 NVIDIA의 NVSHMEM과 NCCL(“니켈”이라고 읽는다) 라이브러리에 구현되어 있다. NCCL은 여기에 오픈소스로 공개되어 있다. NCCL은 latency 요구사항과 토폴로지에 따라 다양한 구현을 골라 쓰지만(상세), 여기서부터는 스위치드 트리 패브릭 위에서의 이론적 최적 모델을 논의한다.
node 내부 collective
AllGather 또는 ReduceScatter: node 수준의 AllGather나 ReduceScatter는 TPU와 똑같이 ring을 따라 수행하면 되고, 매 hop마다 GPU-to-GPU bandwidth 전체를 쓸 수 있다. GPU를 임의 순서로 늘어놓고 배열의 조각을 ring을 따라 full GPU-to-GPU bandwidth로 보낸다.18 각 hop의 비용은 이므로 전체 비용은
TPU와 정확히 같다는 점을 눈치챘을 것이다. AllReduce는 평소처럼 RS + AG를 합쳐 2배의 비용으로 할 수 있다.
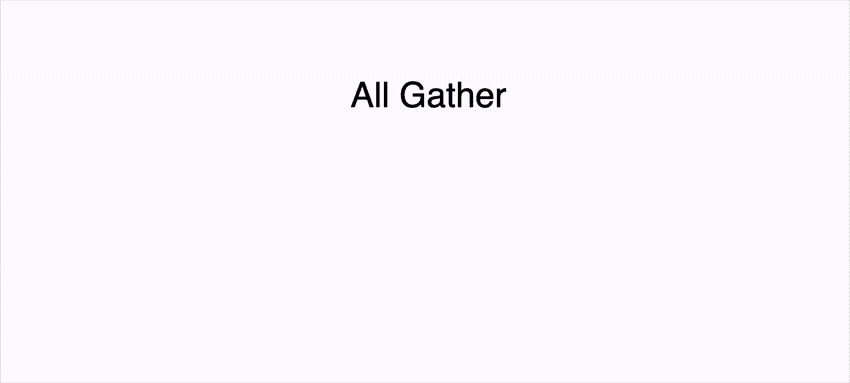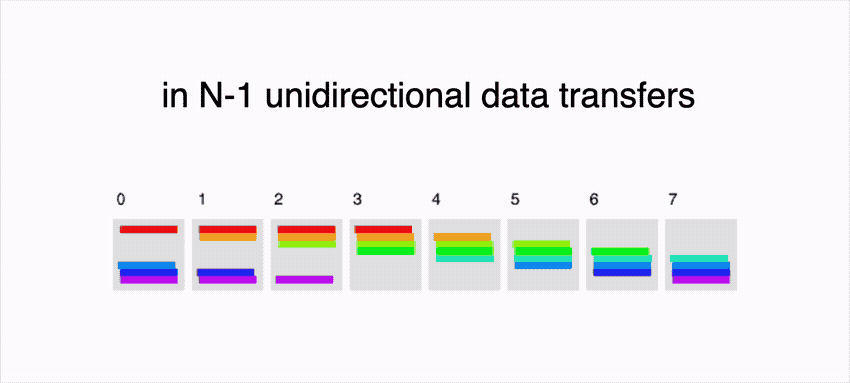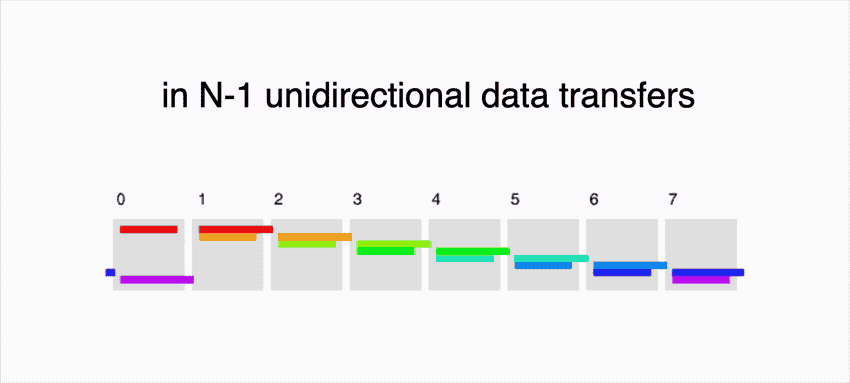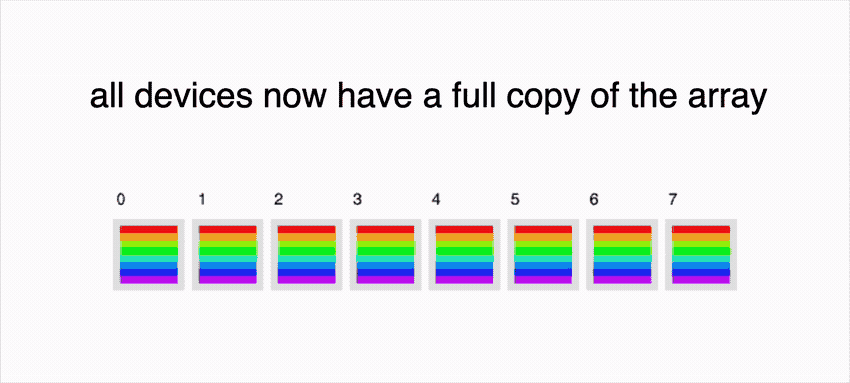
latency가 걱정된다면(예: 배열이 아주 작을 때) tree reduction을 할 수 있다. 2개, 4개, 8개 쌍으로 차례차례 AllReduce하면 hop이 번 대신 번이 된다. 다만 총 비용은 그대로다.
요점(Takeaway): 단일 node 안에서 B 바이트짜리 배열을 AllGather 또는 ReduceScatter하는 비용은 약 이다. 이론적으로 H100에서는 약 , B200에서는 다. AllReduce는 in-network reduction이 켜져 있지 않는 한 이 비용의 2배다.
Pop Quiz 1 [AllGather 시간]: 450 GB/s full-duplex bandwidth의 8xH100 node에서 AllGather(bf16[BX, F])는 얼마나 걸리는가? , 라고 하자.
정답 보기
정답: 총 바이트이고 단방향 bandwidth는 450e9다. 대략 , 더 정확히는 가 걸린다. 주어진 값을 넣으면 대략 , 더 정확히는 다.
AllToAll: node 안의 GPU들은 all-to-all로 연결되어 있어 AllToAll이, 말 그대로, 꽤 쉽다. 각 GPU가 목적지로 바로 보내면 된다. node 안에서 B 바이트에 대해, 각 GPU는 바이트를 갖고 개의 대상 node에 바이트씩 보내므로 총
비용이 인 TPU와 비교해 보라. 단일 node 안에서는 이론상 실행 시간이 2배 빨라진다( vs. ).
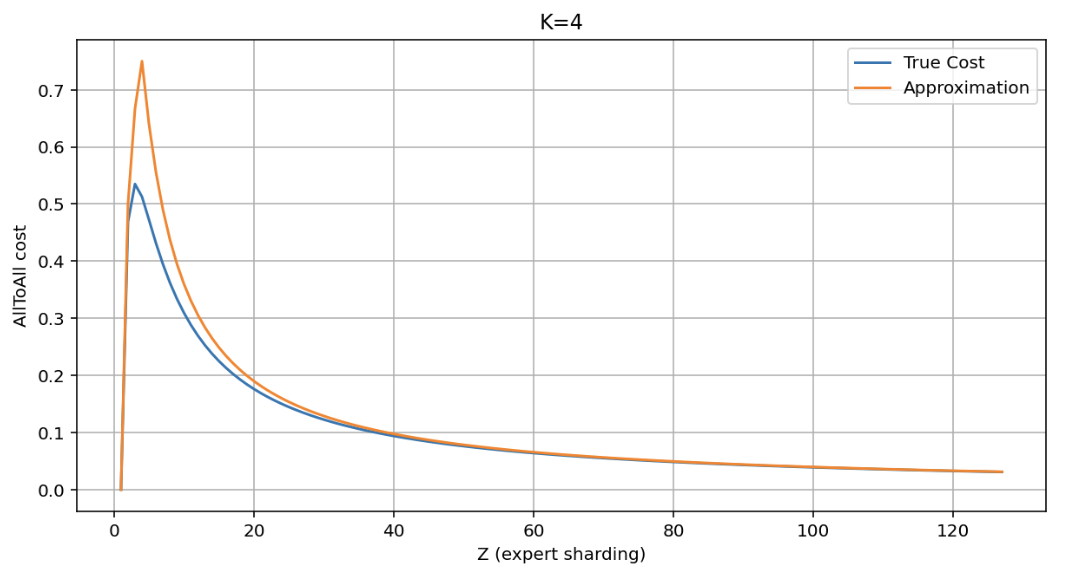
Mixture of Expert(MoE) 모델에서는 sparse 또는 ragged AllToAll을 자주 쓴다. 출력 차원의 개 shard 중 최대 개만 0이 아님을 보장하는 경우로, 에서 각 axis의 개 엔트리 중 최대 개만 0이 아니게 된다. 이때 비용은 배로 줄어 총 약 이다. MoE에서는 0이 아닌 값들을 독립적으로 무작위 선택하는 경우가 많아 개보다 적게 나올 수도 있으므로, 근사적으로 이다.19
Pop Quiz 2 [AllToAll 시간]: 450 GB/s 단방향 bandwidth의 8xH100 node에서 AllToAllX->N(bf16[BX, N])는 얼마나 걸리는가? 8개 중 4개 엔트리만 0이 아님을 안다면?
정답 보기
정답: 여기서 는 배열의 batch 차원이므로 전체 배열 크기는 바이트다. 위에서 dense한 경우의 비용은 , 대략 임을 안다. 엔트리의 만 패딩이 아님을 안다면 만 보내면 되므로 전체 비용의 대략 절반이다.
요점(Takeaway): 단일 node 안에서 GPU의 바이트 배열에 대한 AllToAll 비용은 약 이다. ragged(top-) AllToAll이라면 로 더 줄어든다.
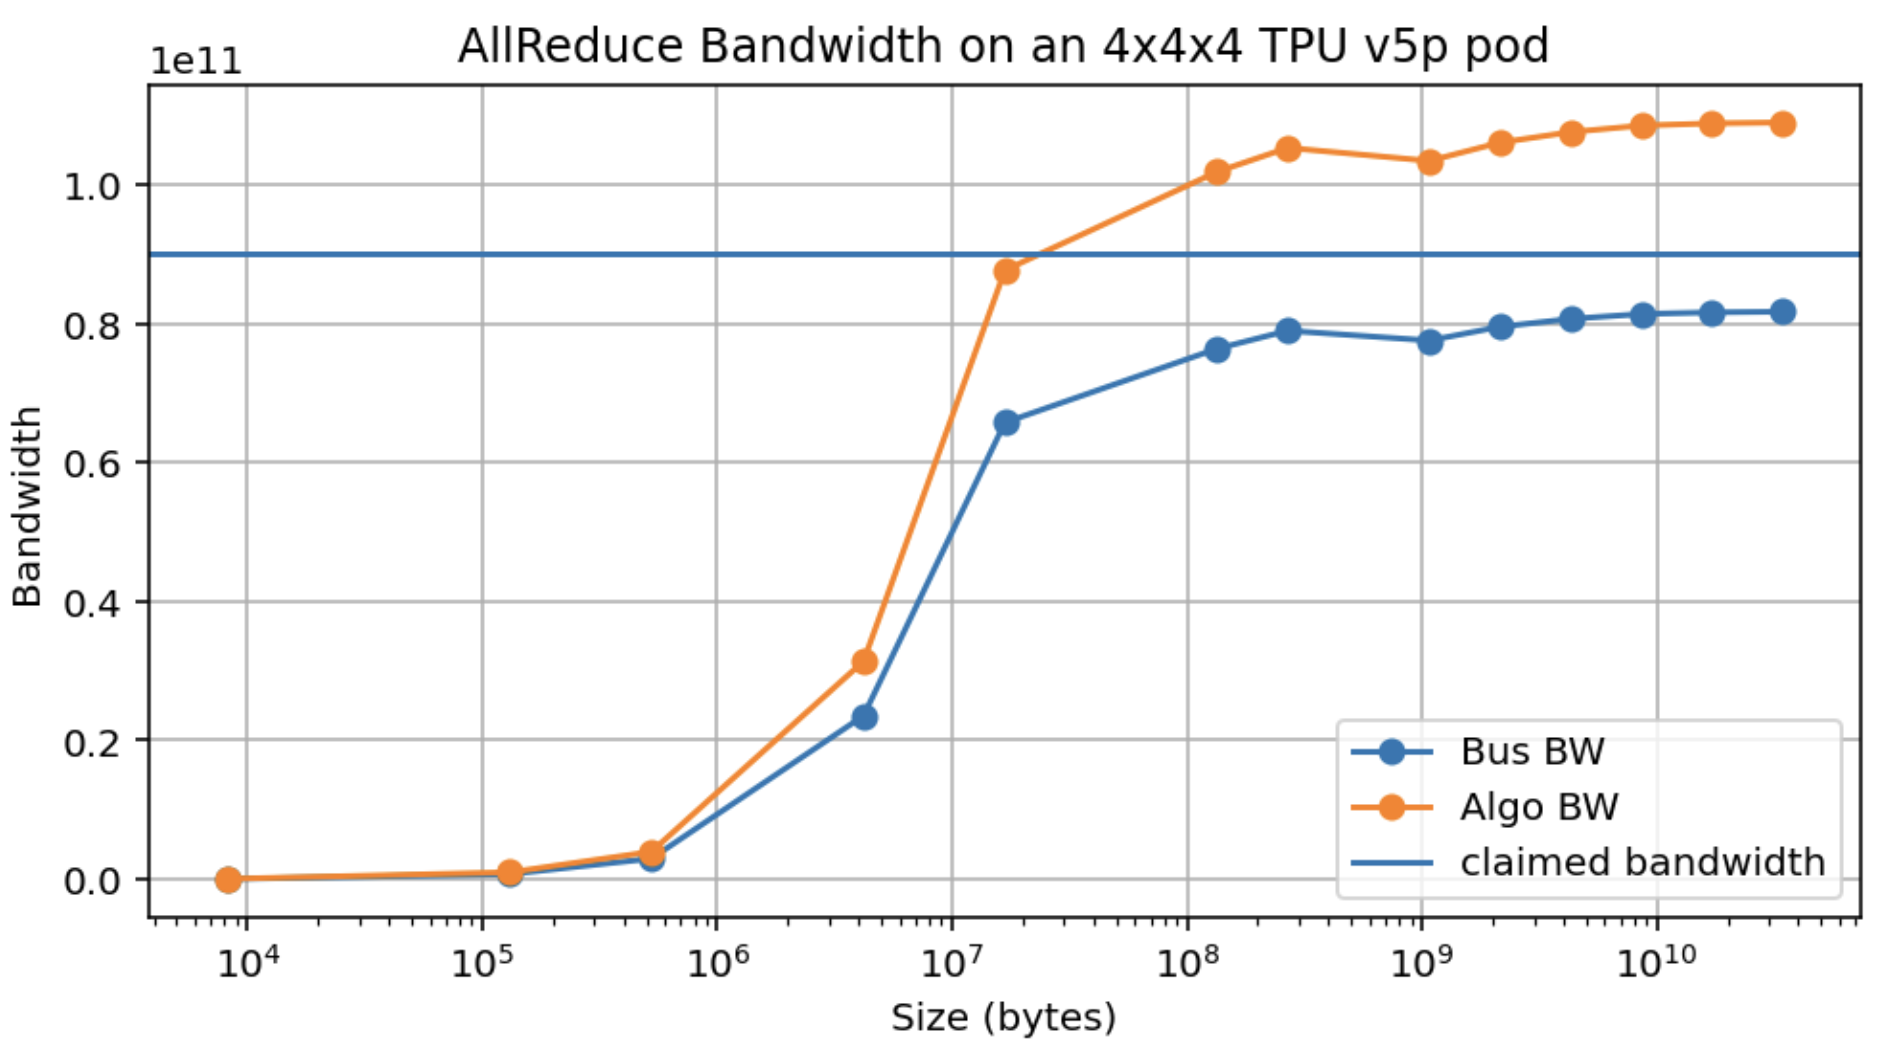
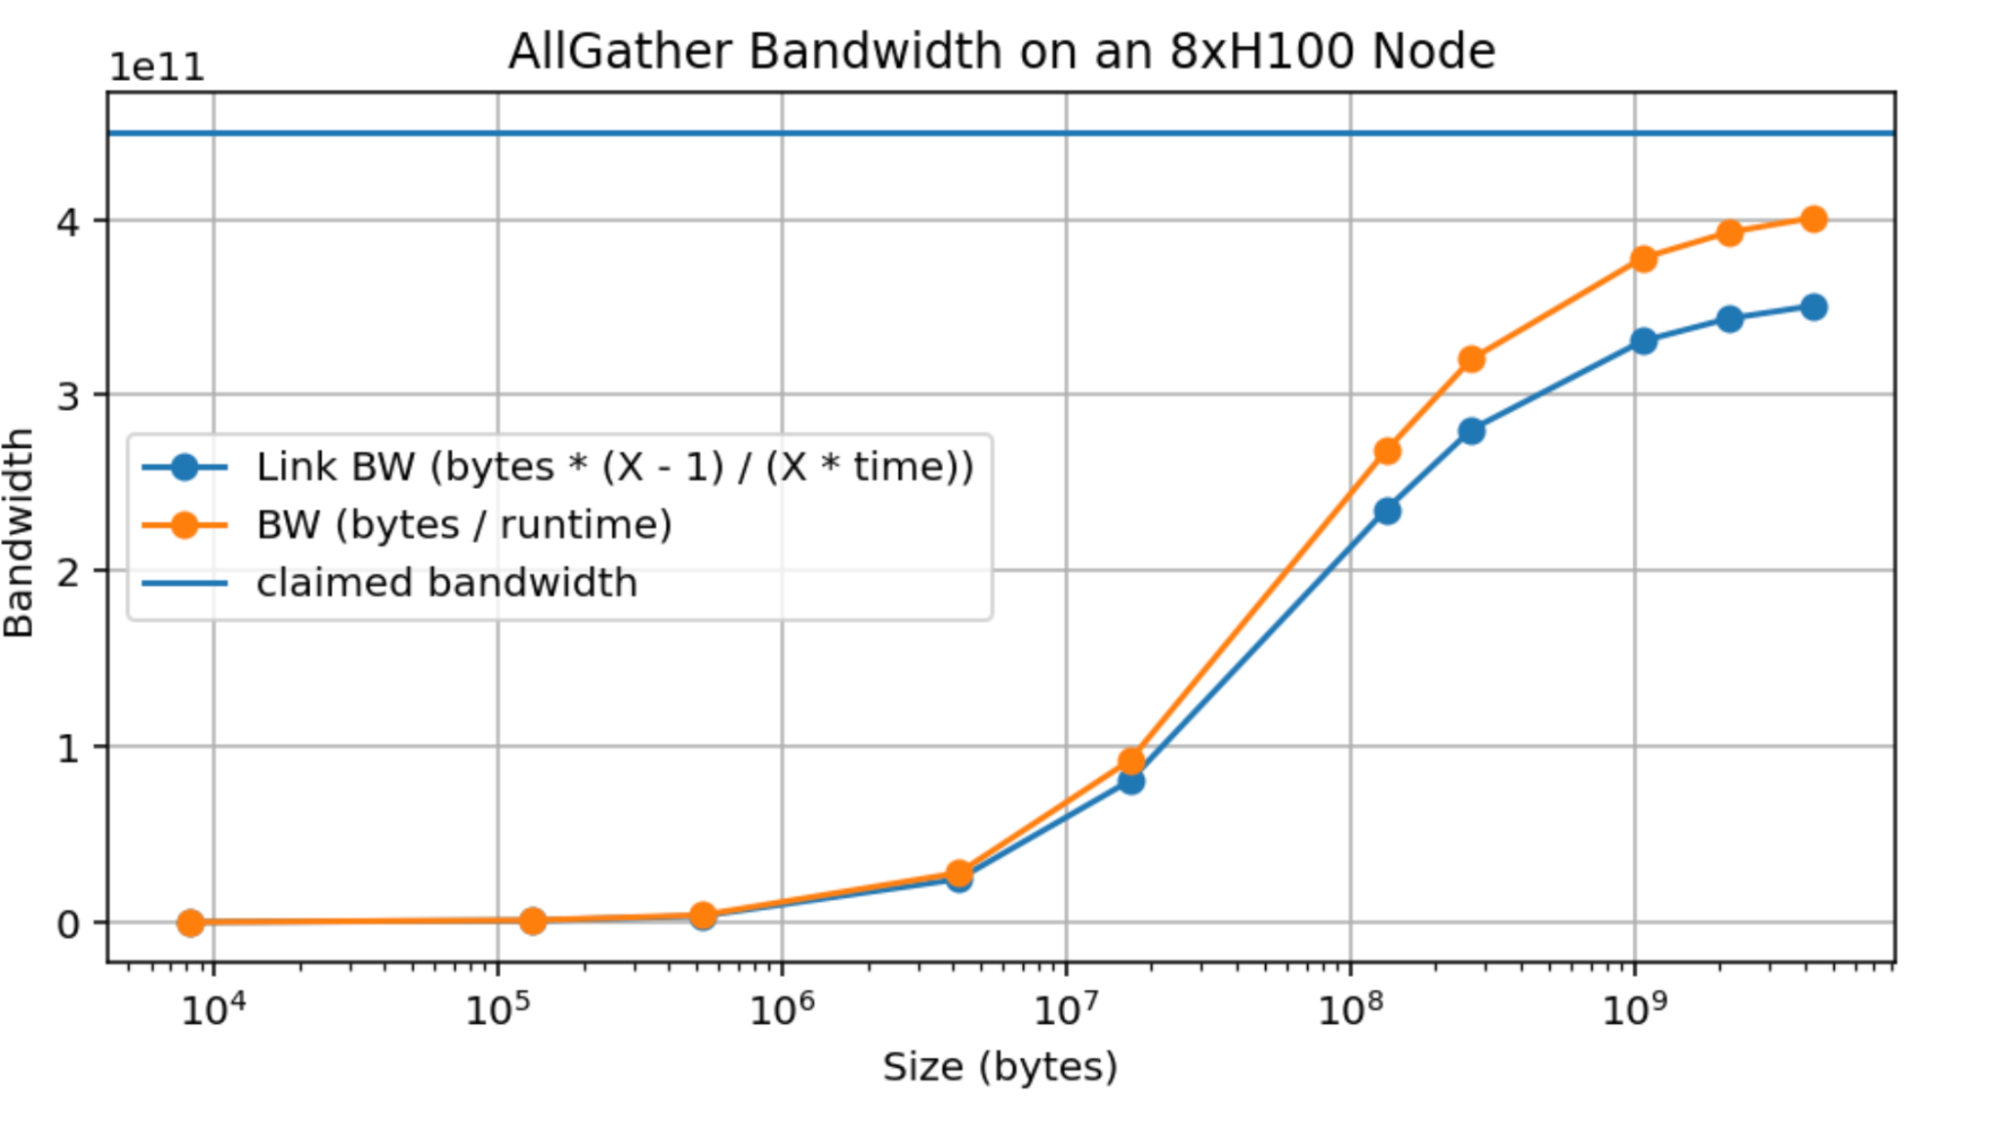
실측: 다음은 8xH100 node에서의 AllReduce bandwidth 실측이다. Algo BW는 측정된 bandwidth(bytes / 실행 시간)이고, Bus BW는 로 계산되며 이론상 실제 링크 bandwidth의 척도다. 450GB/s에는 못 미치지만 그런대로 가까운 370GB/s 근처까지는 도달하는데, 그것도 장치당 약 10GB나 되는 크기에서다. 이 추정치들은 이론적으로는 맞지만, 실현하려면 큰 메시지가 필요하다.
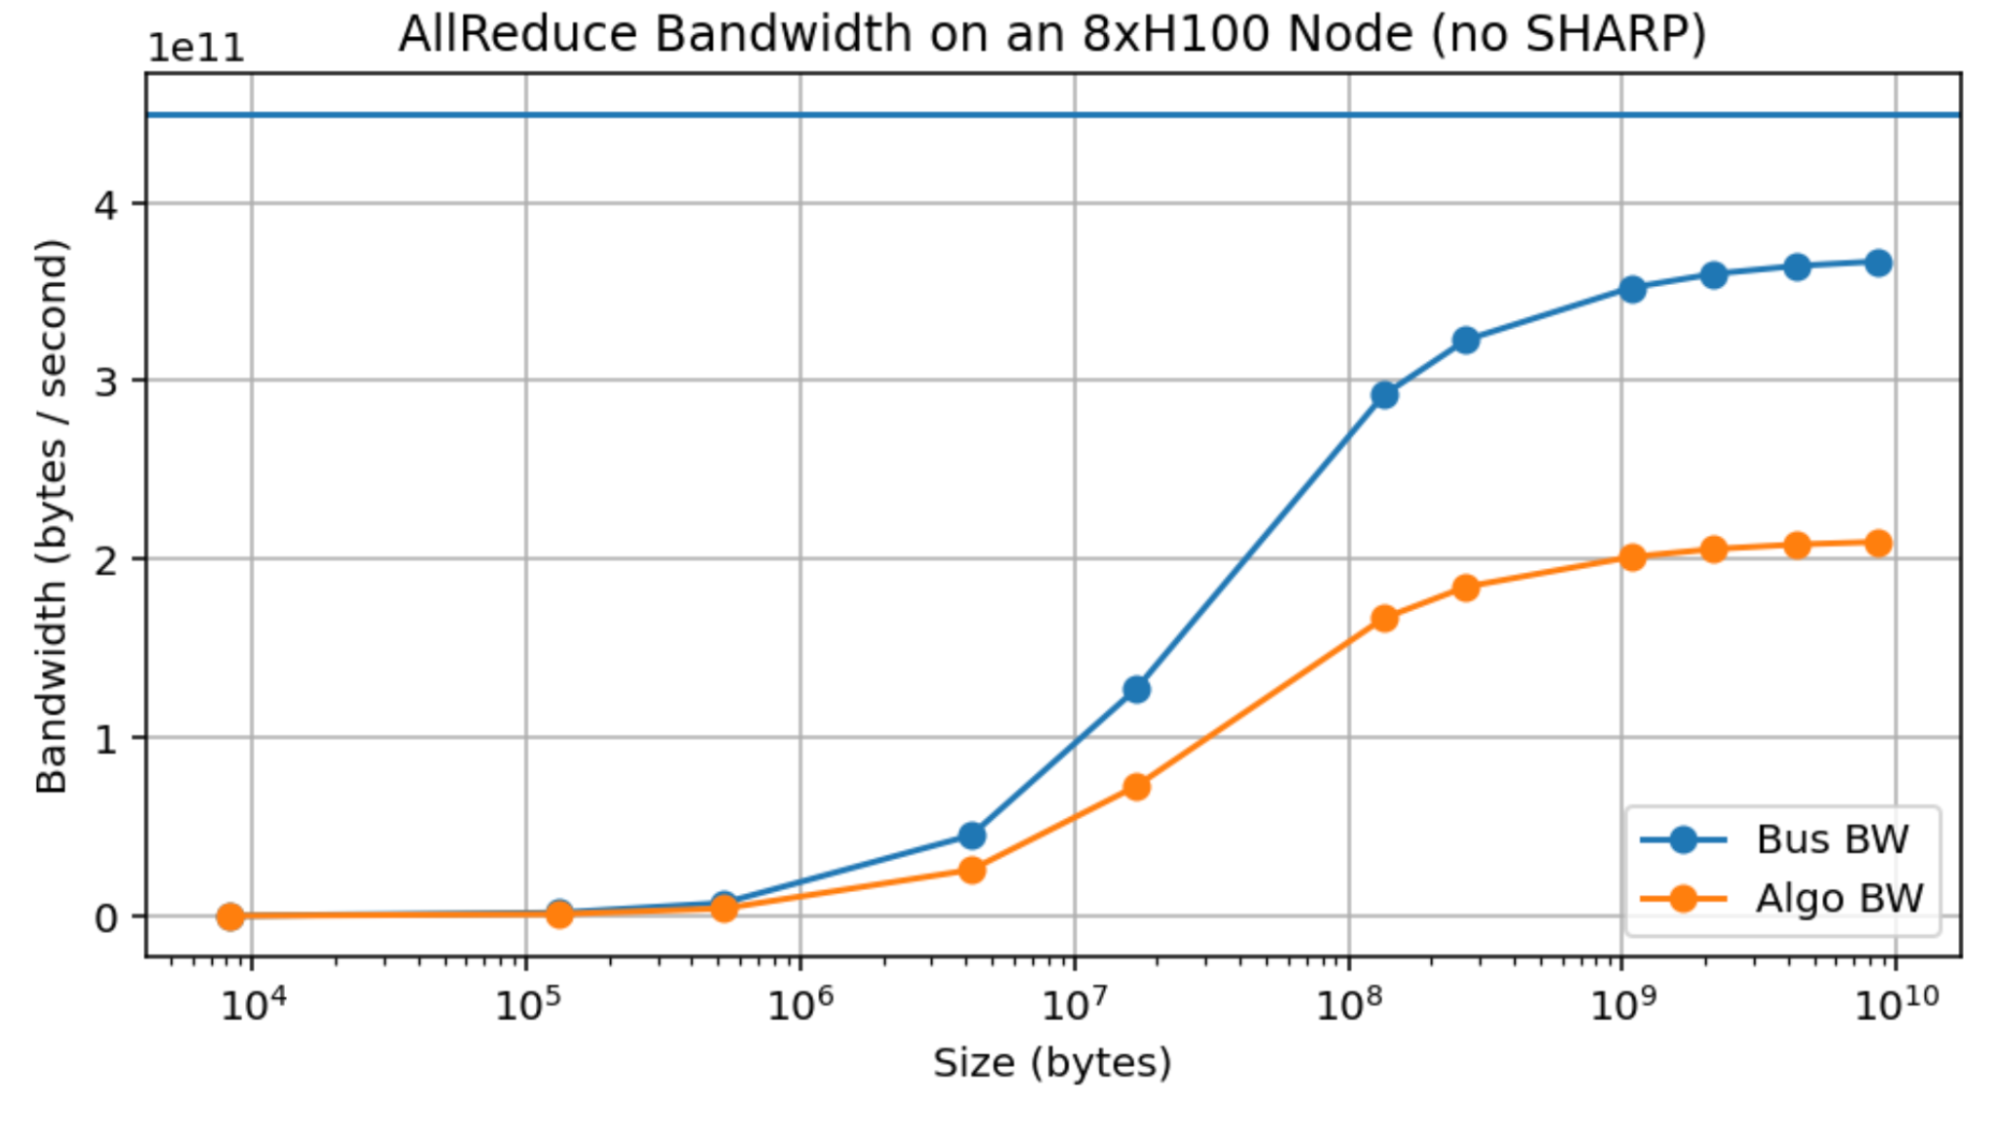
그림: SHARP를 끈 8xH100 node의 AllReduce 처리량. 파란 곡선은 실측으로부터 으로 계산한 경험적 링크 bandwidth다. 거대한 10GB 배열로도 공칭 bandwidth 450GB/s에 그다지 가까워지지 못한다는 점에 주목하라.
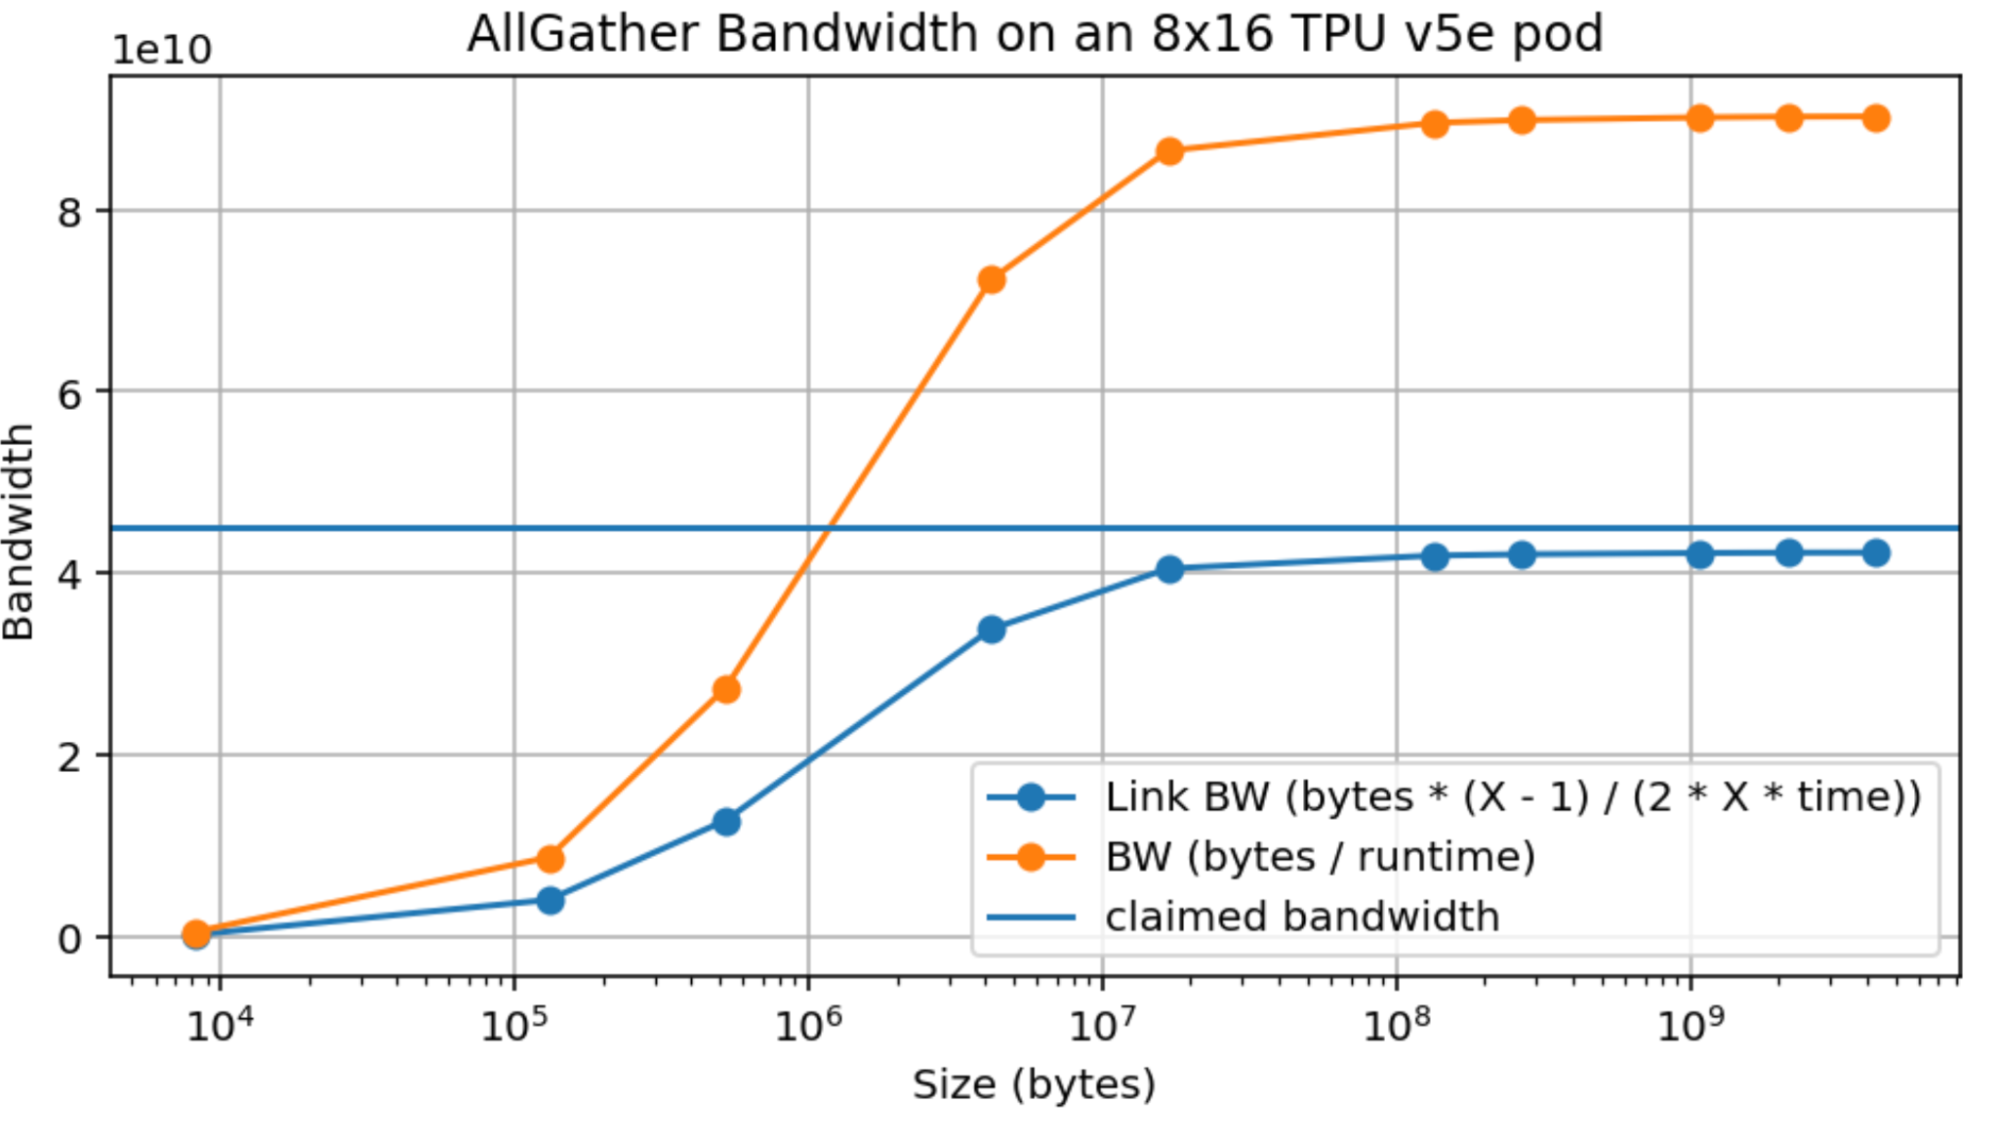
실질적인 문제다. 세울 수 있는 이론적 주장을 의미 있게 복잡하게 만들기 때문이다. 예컨대 그럭저럭 큰 배열 — LLaMA-3 70B의 MLP(크기 bf16[8192, 28672], 8-way 모델 sharding 시 bf16[8192, 3584] = 58MB) — 에 대한 AllReduce조차 peak 450GB/s 대비 약 150GB/s밖에 내지 못한다. 이에 비해 TPU는 훨씬 작은 메시지 크기에서 peak bandwidth에 도달한다(부록 B 참조).
요점(Takeaway): NVIDIA는 H100 NVLink에서 약 450GB/s의 bandwidth를 주장하지만, 실전에서 370 GB/s를 넘기기는 어렵다. 위의 추정치들을 그에 맞게 보정하라.
In-network reduction: Hopper 세대부터 NVIDIA 스위치는 “SHARP”(Scalable Hierarchical Aggregation and Reduction Protocol)를 지원해 “in-network reduction”이 가능하다. 말하자면 네트워크 스위치 자체가 reduction 연산을 수행하고 그 결과를 여러 대상 GPU로 multiplex, 즉 “MultiCast”할 수 있다:
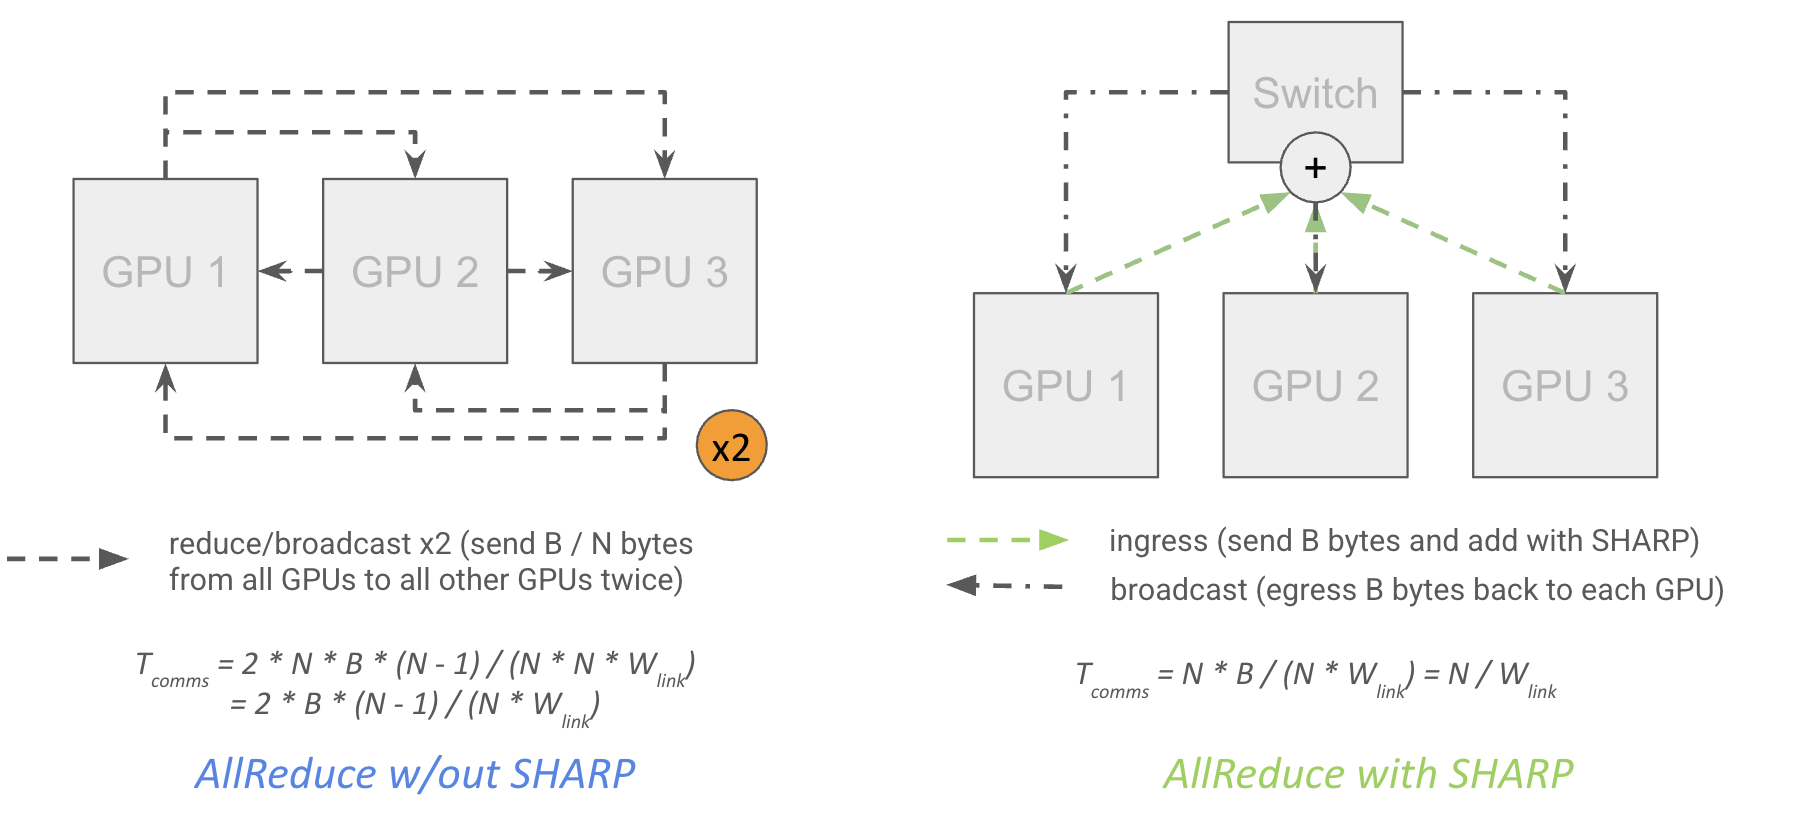
이론적으로는 AllReduce 비용이 거의 절반으로 줄어든다. 각 GPU가 데이터를 최상위 스위치로 보내면 스위치가 스스로 reduction을 수행하고 결과를 각 GPU에 broadcast하므로, 각 GPU를 두 번 egress할 필요가 없어지고 네트워크 latency도 줄어들기 때문이다.
이 식은 인자 없이 정확하다는 점에 주목하라. 각 GPU가 먼저 을 egress하고, 자기 로컬 shard의 부분 reduce 결과를 받고(ingress ), reduction을 마무리한 뒤 다시 을 egress하고, 마지막으로 완전히 reduce된 결과를 ingress()하므로, ingress가 정확히 바이트가 된다.
그러나 실전에서 SHARP를 켰을 때 보이는 bandwidth 증가는 예측치 75%가 아니라 약 30%다. 실효 collective bandwidth를 겨우 약 480GB/s로 끌어올릴 뿐, 2배 근처에도 못 간다.
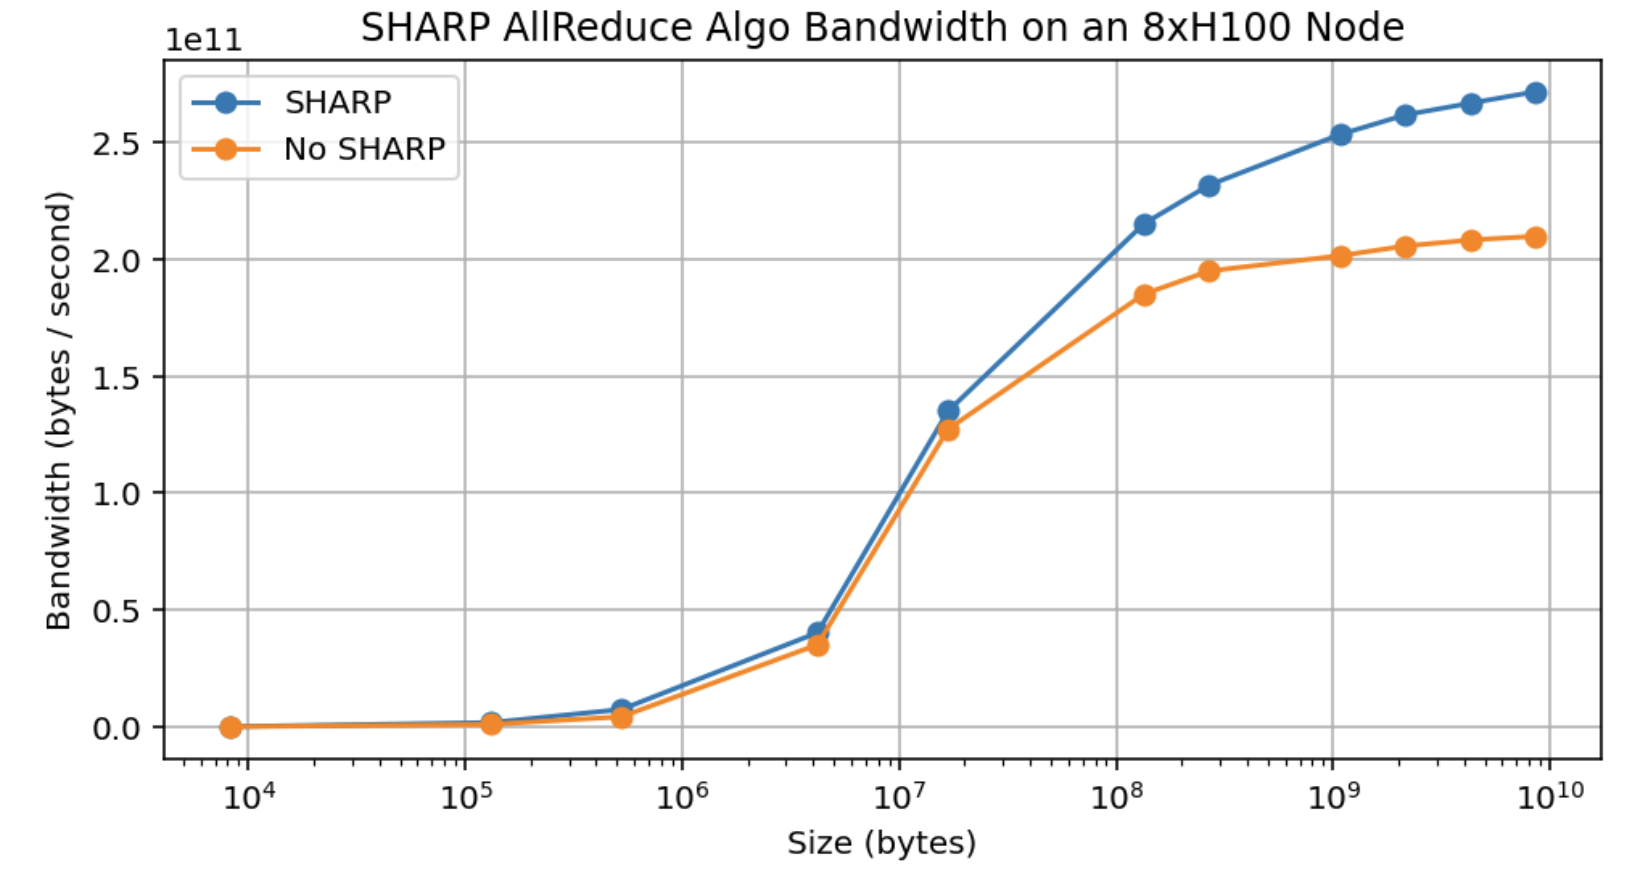
요점(Takeaway): 이론상 NVIDIA SHARP(대부분의 NVIDIA 스위치에서 지원)는 바이트 AllReduce의 비용을 약 에서 로 줄여야 한다. 그러나 실전에서 보이는 bandwidth 개선은 약 30%뿐이다. 순수 AllReduce는 LLM에서 꽤 드물기 때문에 이 기능이 특별히 유용하지는 않다.
node 간 collective
node 수준을 넘어가면 비용이 조금 더 미묘해진다. 트리 위에서 reduction을 할 때는 아래에서 위로 — 먼저 node 안에서, 그다음 leaf 수준에서, 마지막으로 spine 수준에서 — 각 수준마다 통상의 알고리즘으로 reduce한다고 생각하면 된다. 특히 AllReduce의 경우, node 수준에서 AllReduce를 마치고 나면 leaf로는 이 아니라 바이트만 egress하면 되므로 전체적으로 더 적은 데이터를 통신하게 된다.
비용은 얼마나 드는가? 1차 근사로, full bisection bandwidth가 있으므로 AllGather나 ReduceScatter의 비용은 트리 reduction의 세부 사항과 무관하게 버퍼 크기(바이트)를 node egress bandwidth(H100에서 400GB/s)로 나눈 값이 된다.
여기서 egress는 위 H100 네트워크에서 일반적으로 400GB/s다(node마다 8x400Gbps IB 링크 egress). 가장 깔끔한 그림은 클러스터의 모든 node에 걸친 ring reduction을 상상하는 것이다. fat tree 토폴로지 덕분에 임의의 두 node 사이에 egress를 갖는 ring을 항상 구성해 통상의 reduction을 할 수 있다. node 수준 reduction은 전체 bandwidth가 더 크고 latency가 더 좋으므로 (거의) 결코 병목이 되지 않는다. 다만 일반적으로 비용은
더 정밀한 유도 보기
더 정밀하게 말하면, 사실상 네트워크의 각 계층에서 ring reduction을 수행하는 셈이고 이들은 대부분 겹칠 수 있으므로:
여기서 는 depth 의 degree(depth 에서의 자식 수)이고, 는 각 자식을 node 에 연결하는 링크의 bandwidth다.
이를 이용하면 주어진 토폴로지의 가용 AllGather/AllReduce bandwidth를 로 계산할 수 있다. 위의 경우:
- Node: node에 GPU가 8개 있으므로 = 8, Wlink i = 450GB/s. 따라서 AG bandwidth는
450e9 * 8 / (8 - 1) = 514GB/s. - Leaf: SU에 node가 32개 있으므로 = 32, Wlink i = 400GB/s(8x400Gbps IB 링크). 따라서 bandwidth는
400e9 * 32 / (32 - 1) = 413GB/s. - Spine: SU가 4개이므로 = 4, = 12.8TB/s(위의
8 * 16 * 2 * 400Gbps링크에서). bandwidth는12.8e12 * 4 / (4 - 1) = 17.1TB/s.
따라서 전체 AG 또는 RS bandwidth는 leaf 수준의 min(514GB/s, 413GB/s, 17.1TB/s) = 413GB/s이므로, 실전에서는 , 즉 최상위 수준에서도 약 413GB/s의 AllReduce bandwidth를 가진다. SHARP를 쓰는 AllReduce는 인자가 없어 이보다 약간 낮다(약 400GB/s). 그래도 450GB/s와 400GB/s는 근사값으로 쓰기에 충분히 가깝다.
다른 collective들: AllReduce는 SHARP가 켜져 있지 않으면 여전히 위 비용의 2배다. NVIDIA는 SHARP 지원 IB 스위치도 팔지만, 모든 provider가 갖고 있지는 않다. AllToAll은 AllReduce처럼 “계층적”이지 않아서 node를 넘어가면 사정이 꽤 달라진다. 모든 GPU에서 다른 모든 GPU로 데이터를 보내야 한다면 node 수준의 full bisection bandwidth를 활용할 수 없다. 개의 node에 걸친 N-way AllToAll의 비용은
실효 bandwidth가 400GB/s가 아니라 50GB/s인 셈이다. 단일 H100 node 안의 에서 2개 node에 걸치면 가 되어 4배 넘게 나빠진다.
1024-GPU DGX H100 SuperPod 아키텍처의 요약이다:
| 계층 | GPU 수 | Degree (자식 수) | 스위치 Bandwidth (full-duplex, TB/s) | 케이블 Bandwidth (full-duplex, TB/s) | Collective Bandwidth (GB/s) |
|---|---|---|---|---|---|
| Node | 8 | 8 | 6.4 | 3.6 | 450 |
| Leaf (SU) | 256 | 32 | 25.6 | 12.8 | 400 |
| Spine | 1024 | 4 | 51.2 | 51.2 | 400 |
“Collective Bandwidth”는 GPU 또는 node를 egress할 수 있는 실효 bandwidth를 뜻한다. 이기도 하다.
요점(Takeaway): node 수준을 넘어가면 B 바이트에 대한 AllGather나 ReduceScatter의 비용은 대략 이며, H100 DGX SuperPod에서는 다. AllReduce는 SHARP가 없으면 2배 비용이다. 전체 토폴로지는 임의의 두 node 쌍 사이에 일정한 bandwidth를 주도록 설계된 fat tree다.
배열이 다른 axis로 sharding되어 있을 때의 reduction: 다음과 같은 reduction의 비용을 생각해 보자.
배열 자체가 다른 axis 를 따라 sharding된 상태에서 AllReduce하는 경우다. TPU에서는 axis마다 보내는 데이터가 이 되므로 이 연산의 전체 비용이 unsharded 버전 대비 로 줄어든다. GPU에서는 어느 axis가 “안쪽”(intra-node vs. inter-node)인지, 그리고 각 shard가 node 하나보다 큰 범위에 걸치는지에 따라 비용이 달라진다. 가 안쪽 axis이고 배열의 총 바이트가 라면 전체 비용은 실질적으로 분의 1로 줄지만, 가 여러 node에 걸칠 때만 그렇다:
여기서 N은 GPU 수이고 는 역시 node 안의 GPU 수(node의 degree)다. 보다시피 이면 node 수준에서는 이득을 보지만 전체 실행 시간은 대체로 줄지 않고, 이면 걸치는 node 수에 비례한 speedup을 얻는다.
ring reduction을 엄밀하게 따지자면, 트리 AllGatherX(AY { UX })의 일반 규칙은 (Y가 안쪽 axis라고 가정할 때)
여기서 는 트리에서 계층 i 아래의 subnode 크기, 즉 M * N * … 이다. 대략, 더 많은 GPU나 node에 걸칠수록 가용 bandwidth가 커지지만 그 node 안에서만 그렇다.
Pop Quiz 3 [두 axis에 걸친 sharding]: 단일 SU(칩 256개)에서 가 안쪽 axis일 때 를 수행하고 싶다고 하자. , , 의 함수로 얼마나 걸리는가?
정답 보기
정답: Y <= 8인 경우와 Y > 8인 경우로 나뉜다. 이면 여전히 leaf 스위치에 묶이므로 답은 평소처럼 이다. Y > 8이면 위로부터 대략
D = 8192, F = 32,768이면:
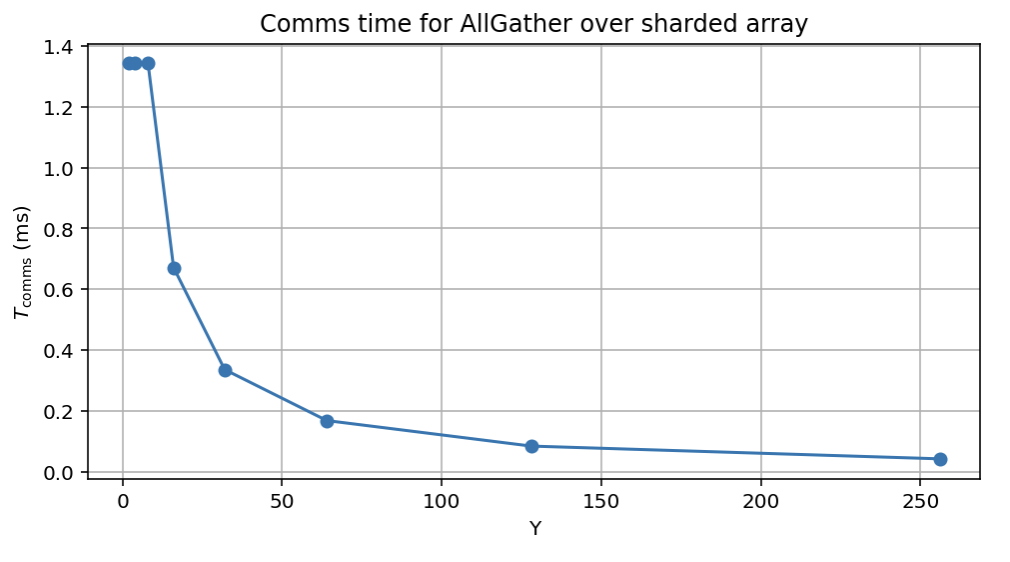
정확히 8-way model parallelism을 하면 node 수준 reduction의 비용은 8분의 1이 되지만 전체 비용은 그대로라는 점에 주목하라. 공짜이긴 하지만 전체 bandwidth 개선에는 도움이 안 된다.
요점(Takeaway): sharding axis가 여러 개일 때, 바깥쪽 reduction의 비용은 안쪽 axis가 걸치는 node 수만큼 나눠져 줄어든다.
퀴즈 4: collective
문제 1 [SU AllGather]: node M개, node당 GPU N개인 단일 SU만 생각하자. AllGather 동안 node 수준 스위치가 ingress·egress하는 바이트는 정확히 얼마인가? 최상위 스위치는?
정답 보기
정답: reduction의 구성 요소를 단계별로 따라가 보자:
- 각 GPU가 바이트를 스위치로 보내므로 총 ingress는 바이트다.
- 바이트 전체를 spine 스위치로 egress한다.
- spine 스위치에서 바이트를 ingress한다.
- 바이트를 번 egress하므로 총 이다.
합계는 ingress , egress 이므로 egress가 병목이 되어야 하고, 총 시간은 가 된다.
spine 스위치 쪽 계산은 오히려 더 단순하다. 바이트가 M번 ingress되고(총 바이트), 이 번 egress되어 총 이 나간다. 이쪽이 훨씬 크므로 비용은 다.
문제 2 [단일 node SHARP AR]: node당 GPU N개인 단일 node를 생각하자. SHARP(in-network reduction)를 쓰는 AllReduce 동안 스위치가 ingress·egress하는 바이트는 정확히 얼마인가?
정답 보기
정답: 앞서와 같이 단계별로 해 보자.
- 각 GPU가 바이트를 보내므로 이 ingress된다.
- partial sum을 누적하고 각 GPU에 바이트를 돌려보내므로 바이트가 egress된다.
- 잔여분(residual)의 partial sum을 로컬에서 수행한 뒤 스위치로 돌려보낸다. 총 바이트 ingress다.
- 모든 shard를 모아 multicast한다. 을 곳으로 보내므로 총 egress다.
따라서 합계는 ingress·egress 각각 바이트다. 이는 전체 처리량이 정확히 라는 것을 뒷받침한다.
문제 3 [node 간 SHARP AR]: GPU N개짜리 단일 node에 sharding된 배열 bf16[DX, FY]를 생각하자. AllReduce(bf16[D, FY] { UX })는 얼마나 걸리는가? in-network reduction을 가정해도 좋다. node가 하나보다 많으면 어떻게 달라지는지 설명하라.
정답 보기
정답: 바로 위 문제의 답을 변형해 볼 수 있다. 기본적으로 먼저 각 GPU에서 바이트를 egress하고, 각 GPU에 를 돌려보내고, 같은 양을 다시 스위치로 보내고, 를 각 GPU에 되돌려보낸다. 합계는 ingress·egress 각각 이므로 총 시간은 , 즉 총 시간이 에 따라 실제로 줄어든다.
단일 node를 넘어가면 위와 대략 같은 reduction을 할 수 있지만, node 수준 스위치를 egress할 때는 가 아니라 B 바이트 전부를 보내야 한다. 각 shard를 따로 유지해야 하기 때문이다.
문제 4 [Spine 수준 AR 비용]: 위와 같은 설정에서 이라고 하자(그래서 AR이 spine 수준에서 일어난다). AllReduce는 얼마나 걸리는가? 역시 in-network reduction을 가정해도 좋다.
정답 보기
정답: 이 경우 spine 수준의 터무니없이 많은 bandwidth를 활용할 수 있다. spine에는 4개 SU에 걸쳐 51.2TB/s, 즉 SU당 12.8TB/s의 bandwidth가 있다. SHARP를 쓰면 짧게는 2 * D * F / 12.8e12초까지 가능하다.
문제 5 [2-way AllGather 비용]: 정확히 2개 node에 걸친 바이트 AllGather의 정밀한 비용을 계산하라. 근사가 아니라 정밀한 비용을 계산할 것. node 내부 비용과 node 간 비용을 모두 고려하라.
정답 보기
정답: node 수준에서는 인 반면, 그 위에서는 실제로 다. 실제 병목은 leaf 수준이 아니라 node 수준 reduction인 것이다! 이것이 2-way Data Parallelism을 쓰는 DeepSeek v3 같은 선택의 동기가 된다.
GPU에서 LLM 스케일링을 위한 roofline
이제 지금까지의 모든 내용이 향하던 곳을 보자: GPU에서 LLM 스케일링의 roofline 이해하기. TPU 학습 챕터를 보완하는 내용이다. 거기서 했듯이, 목표는 서로 다른 병렬화 전략의 총 와 를 보고 어느 지점에서 가 되는지 이해하는 것이다. 이전처럼 다음 연산으로 이루어진 MLP 블록만 고려한다.
여기서 는 토큰 단위의 전역 batch size다(즉 ).
GPU 수준과 node 수준의 실효 bandwidth를 보여주는 위의 표를 다시 가져오자:
| Node 종류 | node당 GPU | GPU egress bandwidth | Node egress bandwidth |
|---|---|---|---|
| H100 | 8 | 450e9 | 400e9 |
| B200 | 8 | 900e9 | 400e9 |
| GB200 NVL72 | 72 | 900e9 | 3600e9 |
참고: GPU와 node egress bandwidth 둘 다 LLM의 roofline을 결정한다. node 수준 안에서 동작하는지 그 위에서 동작하는지에 따라 GPU 또는 node bandwidth를 가리키는 용어로 를 쓰겠다.
TPU에서 했던 것처럼 data parallelism, tensor parallelism, pipeline parallelism, expert parallelism과 이들의 조합에 대해 연산-통신 roofline을 보자. 이 섹션의 나머지에서는 구체적 계산에 H100 roofline을 쓴다. GB200-NVL72도 일반적인 roofline은 같지만 node egress bandwidth가 더 커서, 때로는 scale-out 수준이 아니라 node 수준에서 병목이 걸릴 수 있다.
Data Parallelism
앞서 언급했듯 DP와 ZeRO sharding은 backward pass에서 weight AllReduce 또는 ReduceScatter + AllGather를 수반한다. 두 경우 비용이 같으므로, in-network reduction 없는 순수 data parallelism 또는 FSDP가 compute-bound가 되려면, 크기 X인 axis에 대해 layer당 backward pass에서:
따라서 이려면 , 즉
여기서 는 node 안에서 sharding하는지 node를 넘어 sharding하는지에 따라 GPU 또는 node 수준 egress bandwidth다. 따라서:
- node 안에서는 GPU당 토큰 batch size > 이기만 하면 된다.
- SU 안 또는 spine 수준에서는 BS > .
세 axis를 모두 쓰면 850인 TPU보다 꽤 높은 수치다. 예컨대 16000개의 H100으로 학습한 LLaMA-3라면 최소 40M 토큰의 batch size가 필요하다(참고로 실제로는 16M을 썼다). (H100의 450GB/s 대신) 300GB/s의 더 낮은 bandwidth를 가진 H800 GPU 2048개로 학습한 DeepSeek v3라면 GPU당 토큰, 즉 약 6.7M이 필요하다(실제로는 4M을 썼다).
in-network reduction을 켜고 순수 data parallelism을 쓰면 이론상 AllReduce bandwidth가 2배가 되어 위 수치가 절반이 된다. 그러나 실전 이득은 30%에 가까워서, 보고된 스펙 수치에 도달하기 어렵다는 사실을 벌충하는 정도에 그친다. 게다가 순수 data parallelism은 유용한 경우가 드물어 실전에서는 사실상 중요하지 않다.
MoE 모델: expert가 E개이고 토큰당 expert가 k개인 Mixture of Experts(MoE) 모델에서는 다음으로 늘어난다.
GPU당 토큰 batch size가 배로 부풀어
예컨대 , 인 새 OpenAI OSS 모델이라면 node를 넘어갈 때 32 * 2475 = 79,200으로 늘어난다. 어처구니없이 높은 수치다.
X가 작으면 어떻게 되는가? 예컨대 2-node data parallelism만 한다면 스케일링의 덕을 본다:
여기서 X는 node 수이고 다. 그러면 dense 모델에서는 , 예컨대 로 위 값의 절반이다. 2-way data parallelism이 꽤 자주 보이는 이유다.
요점(Takeaway): H100이나 B200에서 data parallelism과 ZeRO sharding이 compute-bound가 되려면, 완벽한 겹침(overlap)과 FLOPs 활용을 가정할 때 GPU당 약 2500 토큰의 batch size가 필요하다. MoE 모델에서는 총 파라미터 대 활성 파라미터 비율인 배로 늘어난다. data parallelism을 조금만 할 때는 임계 batch size가 줄어든다.
Tensor Parallelism
Tensor parallelism은 activation에 대한 AllGather와 ReduceScatter를 수반하며, 이를 MLP FLOPs와 겹쳐야 한다. forward pass에서:
compute-bound가 되기 위한 규칙은:
node 안에서는 약 , node를 넘어가면 다. LLaMA-3처럼 이면 약 11-way TP다(내림하면 약 8-way, 즉 node 크기만큼). 위에서처럼 정확히 2개 node에 걸치면 2배의 bandwidth를 추가로 얻으므로 일반적으로 16-way tensor parallelism까지 가능하고(), 이론상 최대 19-way model parallelism까지 나온다.
요점(Takeaway): feed-forward 차원 F에 대해 크기 Y인 axis의 tensor parallelism은 이면 communication-bound가 된다. 그래서 대체로 node 내부 TP, 많아야 2-node TP로 제한된다.
Expert Parallelism
이미 언급했듯 Mixture of Expert(MoE) 모델은 FLOPs는 k배만 늘면서 모델 weight는 E배 많아, data parallelism을 눈에 띄게 어렵게 만든다. weight를 expert 차원으로 sharding하면 — 즉 Win[EZ, D, F] — 이를 어느 정도 누그러뜨릴 수 있다. MLP 블록을 수행하려면 activation을 해당 expert로 보내는 AllToAll 2번을 추가해야 한다.
위에서 언급했듯, 여러 node에 걸치는 경우 이 AllToAllZ->k([B, D, k])의 비용은 대략 이므로, 순수 expert parallelism에서는
이면서 이거나, 아니면 이면서 여야 한다(). 결국 expert parallelism이 가능한 영역이 두 개 있다. 하나는 적은 양의 expert parallelism(대략 2-node)과 작은 의 조합이고, 다른 하나는 큰 와 함께 를 얼마든지 키우는 것(E-way expert parallelism까지)이다.
실전에서 두 경우 모두 보인다. DeepSeek v3처럼 F가 매우 작고 비교적 작고 제한된 cross-node expert parallelism을 쓰는 경우, 아니면 F가 큰 모델의 경우 — 이때는 TP와 함께 상당한 cross-node EP를 할 수 있다.
요점(Takeaway): 이면 expert parallelism은 TP와 비슷한(약간 더 낮은) 비용으로 1-2개 node에 걸칠 수 있고, 이면 비교적 낮은 비용으로 상당한 양의 expert parallelism(최대 개 node)을 할 수 있다.
Pipeline Parallelism
Pipeline parallelism은 layer들을 node에 걸쳐 쪼개는데, 통신 비용이 극도로 낮다. 몇 layer마다 작은 microbatch의 activation만 보내면 되기 때문이다. 역사적으로 pipelining은 “pipeline bubble”에 시달렸지만, 새로운 zero-bubble pipelining 기법들 덕에 요즘은 대개 bubble 없이 할 수 있다.
pipelining의 전체 통신 비용은 미미하다. microbatch 개와 개의 stage가 있으면 이고 hop 수는 이므로 대략
로 나누기 때문에 다른 어떤 비용보다도 압도적으로 작다. 다시 말해 통신 관점에서 pipelining은 사실상 공짜다. 그럼 왜 그냥 pipelining만 하지 않을까? 몇 가지 이유가 있다:
(1) 코드 복잡도: pipelining은 다른 접근법만큼 자동 병렬화 프레임워크(XLA의 GSPMD 같은)에 깔끔하게 들어맞지 않는다. pipeline bubble을 숨기려 microbatching을 도입하면 프로그램 구조 자체가 바뀌고, 커스텀 zero-bubble pipeline 스케줄은 forward와 backward pass의 복잡한 interleaving을 요구해 문제를 더 키운다.
(2) pipelining은 data parallelism과 FSDP를 어렵게 만든다: pipelining을 하지 않을 가장 큰 이유는 아마 FSDP·data parallelism과 궁합이 나쁘다는 점일 것이다. 특히 ZeRO-3 sharding이 잘 안 된다. microbatch마다 weight를 AllGather해야 하는데 AllGather 비용을 상각할 토큰이 개뿐이면 성립하지 않기 때문이다. 게다가 backward pass에서는 마지막 microbatch가 해당 stage를 통과할 때까지 gradient를 AllReduce나 ReduceScatter할 수 없어서, 겹치지 못한 통신 시간이 상당히 생긴다.
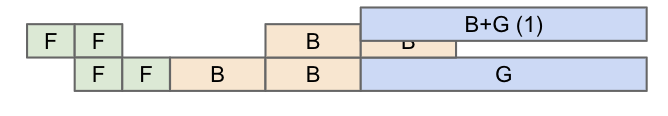
(3) pipeline bubble과 step 불균형: 위의 (나쁜) pipeline 스케줄에서 보듯, 순진한 pipeline 스케줄에서는 상당한 bubble(연산 낭비)이 생기기 쉽다. 위에서 두 번째 stage는 step 0에 놀고, 첫 번째 stage는 step 2에서 3까지 놀고, 두 번째 stage는 마지막 step에 또 논다. 신중한 스케줄링으로 어느 정도 피할 수 있지만, 여전히 bubble이 조금은 남는 경우가 많다. 또 critical path 위에서 activation을 한 stage에서 다음 stage로 넘겨야 해서 오버헤드가 더해질 수 있다:
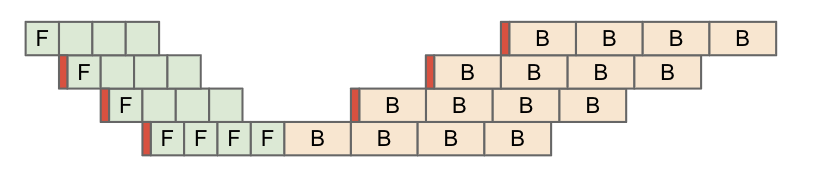
이 문제들 각각에는 우회책이 있지만 구현이 복잡하고 유지보수가 어려운 경향이 있다. 그래도 pipelining은 다른 방법 대비 통신 비용이 낮은 기법으로 남아 있다.
latency에 관한 단서: 앞서 언급했듯 GPU는 꽤 큰 메시지로도 full AllReduce bandwidth를 달성하기 어렵다. 이론상 expert-parallel AllToAll을 여러 node로 확장할 수 있어도 실제로는 전체 bandwidth의 50%도 얻기 힘들 수 있다. 그래서 latency 오버헤드를 줄이기 위해 TP나 EP를 더 적은 수의 node 안에 담아 두려고 한다.
사례
DeepSeek은 어떻게 하는가? 참고로 DeepSeek V3는 2048개의 H800 GPU로 다음과 같이 학습되었다:
- 8개 node에 걸친 64-way Expert Parallelism (EP)
- 16-way Pipeline Parallelism (PP)
- 2-way ZeRO-1 Data Parallelism (DP)
정상 상태(steady state) batch size는 4096 * 15360 = 62,914,560 토큰, GPU당 30k 토큰이었다. 이미 꽤 큰 수치인데, 모델이 매우 sparse해서(k=8, E=256) 상당히 큰 batch size가 필요하다. 64-way EP와 16-way PP로 총 1024-way model parallelism이 되어 AllReduce가 spine 수준에서 수행되고, DP가 2-way뿐이라 실전에서 배의 bandwidth를 얻는다. 마지막 pipeline stage들과 겹치는 최종 data-parallel AllReduce의 비용을 줄이는 데도 도움이 된다.
LLaMA-3는 어떻게 하는가? LLaMA-3는 16k GPU에서 BS 16M 토큰, GPU당 약 1k 토큰으로 학습한다. 구성은:
- node 안에서 8-way Tensor Parallelism (TP)
- 16-way Pipeline Parallelism (PP)
- 128-way ZeRO-1 Data Parallelism
dense 모델이기도 해서 전반적으로 꽤 무난하다. 16-way PP가 data parallel AllReduce의 비용을 16분의 1로 줄여 임계 batch size를 낮추는 데 도움이 된다.
GPU에서 LLM 스케일링 TLDR
한 걸음 물러나 지금까지 배운 것을 총정리해 보자:
- Data parallelism 또는 FSDP(ZeRO-1/3)는 GPU당 약 2500 토큰의 로컬 batch size를 요구한다. 다만 이론상 in-network reduction + 순수 DP로 이를 다소 낮출 수 있다.
- Tensor parallelism은 약 8-way까지 compute-bound지만, 그 이상 확장하면 comms-bound가 되기 전에 bandwidth가 바닥난다. 대체로 단일 NVLink 도메인(즉 단일 node이거나, GPU 최대 72개의 GB200NVL72가 필요)으로 제한된다.
- 여러 node에 걸치는 어떤 형태의 model parallelism이든 FSDP의 비용을 추가로 낮출 수 있다. 그래서 PP + EP + TP를 섞어 여러 node에 걸치게 해서 FSDP 비용을 줄이는 경우가 많다.
- Pipeline parallelism은 zero-bubble pipelining의 코드 복잡도를 감당할 수 있고 data-parallel 병목을 피할 만큼 batch size를 꽤 크게 유지할 수 있다면 잘 작동한다. pipelining은 대개 ZeRO-3를 불가능하게 만들지만(pipeline stage마다 AllGather해야 하므로) 대신 ZeRO-1을 쓸 수 있다.
높은 수준에서, 이것이 GPU에서 큰 모델을 sharding하는 레시피가 된다:
- 비교적 작은 dense 모델이라면, batch size만 받쳐 주면 공격적인 FSDP가 잘 통한다. 필요하면 약간의 pipelining이나 tensor parallelism을 곁들인다.
- 더 큰 dense 모델이라면 1-2 node TP + 다수 node PP + 순수 DP의 조합이 잘 통한다.
- MoE라면 위 규칙이 그대로 적용되지만 expert parallelism도 할 수 있고, 일반적으로 TP보다 선호한다. 이면 다수 node expert parallelism을 왕창 할 수 있지만, 아니라면 대략 2-node EP로 제한된다.
퀴즈 5: LLM roofline
문제 1 [B200 roofline]: B200 DGX SuperPod(GB200 NVL72가 아니다)는 node 안 bandwidth는 2배(900GB/s egress)지만 scale-out 네트워크 bandwidth는 그대로다(400GB/s)(출처). 총 FLOPs는 위 표에 있다. model·data parallel roofline은 어떻게 바뀌는가?
정답 보기
정답: bfloat16 FLOPs/s가 990에서 2250 TFLOPs로 2.25배 늘어난다. bandwidth가 2배이므로 node 안에서 roofline은 대략 그대로다. 예컨대 TP의 임계 intensity는 2250e12 / 900e9 = 2500으로 올라가 한계가 이 되는데, 아주 약간 높아진 것뿐이다(node 크기가 커지지 않는 한 도움도 안 된다).
그러나 node를 넘어가면, bandwidth가 늘지 않았다는 사실이 compute-bound 되기를 오히려 더 어렵게 만든다! 예컨대 data parallelism의 임계 batch size는 2250e12 / 400e9 = 5625로 커진다. 같은 bandwidth로 GPU가 훨씬 많은 FLOPs를 할 수 있게 되었기 때문이다.
72-GPU node를 가진 GB200 SuperPod는 egress bandwidth를 더 추가해 이를 바꾼다(출처).
문제 2 [LLaMA-3 70B를 sharding하는 법]: Adam으로 fp32 optimizer 상태를 유지하며 bfloat16으로 학습하는 LLaMA-3 70B를 생각하자.
- weight와 optimizer를 저장하는 것만으로 최소 몇 개의 H100이 필요한가?
- 4096개의 H100 GPU에서 15T 토큰을 학습한다고 하자. 45% MFU(Model FLOPs Utilization)를 달성했다면 학습에 얼마나 걸리는가?
- LLaMA-3 70B는
F = 28,672이고 약 4M 토큰의 batch size로 학습되었다. comms-bound가 되지 않으면서 할 수 있는 model parallelism의 최대치는? 여기에 순수 DP를 더하면 4k 칩에서 compute-bound를 유지하며 LLaMA-3를 학습할 수 있는가? ZeRO-3라면? 8-way pipelining을 더하면? 참고: 통신 비용과 GPU 메모리 사용량을 모두 고려하라.
정답 보기
- weight에 2바이트, optimizer 상태에 8바이트가 필요하므로 최소 700GB다. DRAM이 80GB이니 최소 9개의 GPU, 올림하면 최소 2개의 8xH100 node가 필요하다. 이렇게 학습하면 한없이 오래 걸리고 gradient checkpoint도 못 담겠지만, 하한은 하한이다.
- 총
6 * 70e9 * 15e12 = 6.3e24 bf16 FLOPs가 필요하다. GPU당990e12FLOPs이므로 45% MFU에서 1.8e18 FLOPs/s다. 따라서 전체는 3.5e6초, 즉 40일이다. - node 안에서는 450GB/s의 bandwidth가 있으므로 한계는 대략
F / 1995 = 28672 / 1995 = 14.372다. 2개 node에 걸치지는 못하므로 현실적으로 8-way model parallelism까지다.- 그러면 512-way DP를 해야 한다. 먼저 메모리가 충분한지 보자. 모델이 8-way로만 sharding되므로
700GB / 8 = 87.5GB / GPU인데, 들어가지 않는다. 따라서 불가! - ZeRO-3와 8-way TP를 쓰면 512-way ZeRO-3다. 모든 것을 공격적으로 sharding하므로 메모리 문제는 없다. GPU당 batch size는
4e6 / 4096 = 976이다. 꽤 낮은 값으로 순수 DP 한계에도 못 미치는데, weight까지 옮겨야 하므로 실제 한계는 그 2배다. 따라서 불가. - 8-way pipelining을 하면 각 model parallel shard가 8개 node에 걸친다. 앞서 보았듯 leaf 수준 AllGather의 비용이 8분의 1로 줄어들므로, 그 지점의 전체 AllReduce/AllGather bandwidth가 400GB/s에서
8 * 400GB/s = 3200GB/s로 올라간다. 그러면 roofline은990e12 / 3200e9 = 309이므로 문제없다! pipelining을 효율적으로 구현하기만 하면 된다.
- 그러면 512-way DP를 해야 한다. 먼저 메모리가 충분한지 보자. 모델이 8-way로만 sharding되므로
문제 3 [Megatron-LM 하이퍼파라미터]: 높은 MFU 수치를 강조하는 Megatron-LM 저장소의 이 그림을 보자.
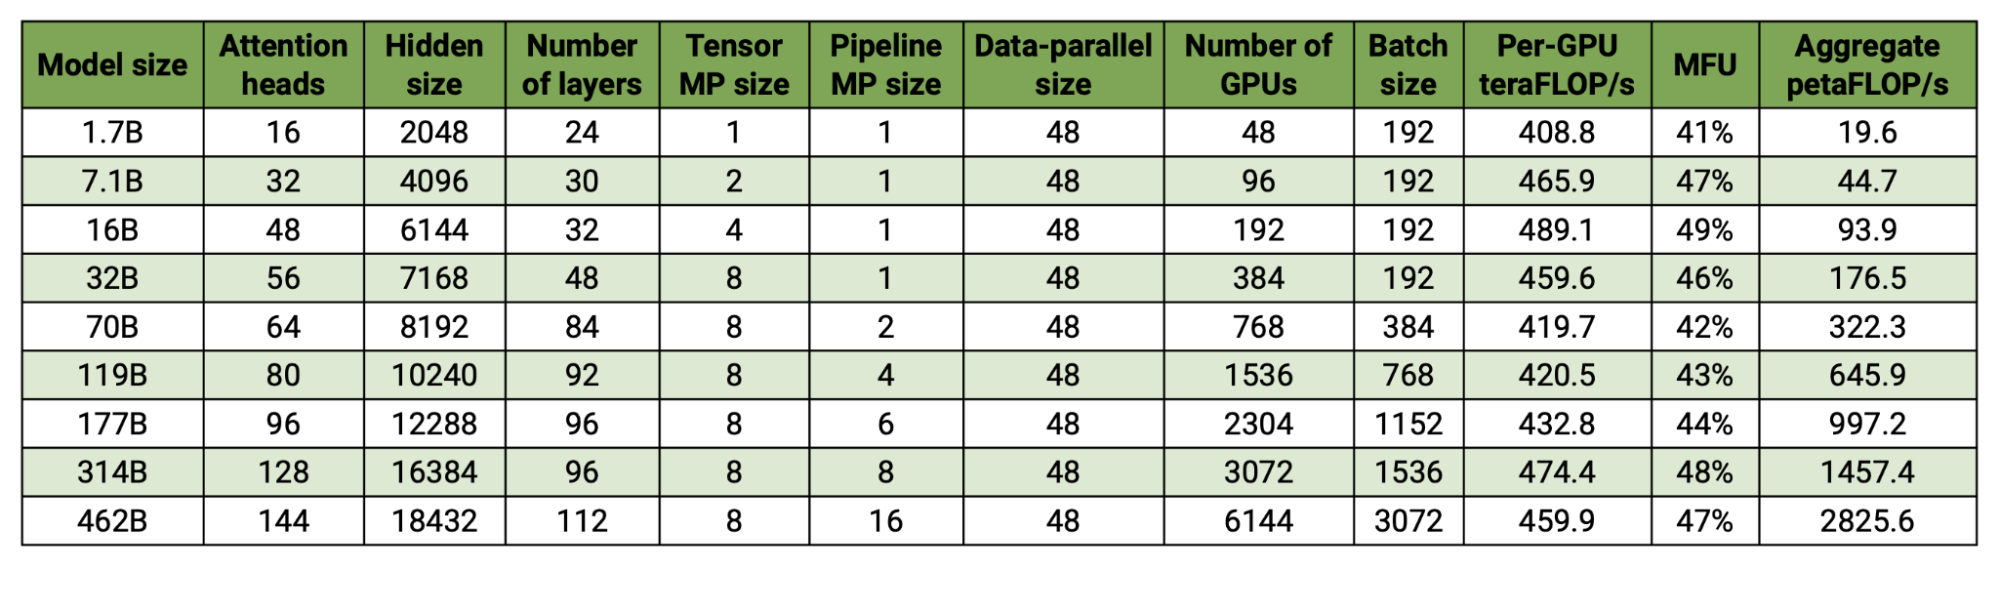
sequence length는 모두 4096이다. 16B, 70B, 314B 모델 각각의 GPU당 토큰 batch size는 얼마인가? data parallelism이 가장 바깥 axis이고 bfloat16 reduction을 가정할 때, 각각이 이론상 compute-bound인지 communication-bound인지, 그리고 더 나은 구성이 있는지 판단하라.
정답 보기
정답: GPU당 batch size부터 보자.
- 16B:
192 * 4096 / 192 = 4096토큰/GPU - 70B:
384 * 4096 / 768 = 2048토큰/GPU - 314B:
1536 * 4096 / 3072 = 2048토큰/GPU
첫 번째를 빼면 전부 배치당 2k 토큰 언저리인데, 공교롭게도 앞서 계산한 FSDP 임계 근처다. spine 수준 reduction 기준으로 2,472 토큰/GPU를 계산했었고, 여기서 대략 그 한계가 작동한다. 다만 70B와 314B는 각각 16-way, 64-way model(PP + TP) sharding을 하므로 spine 수준에서 2배, 8배 더 나은 처리량을 얻고, 따라서 대략 1k와 300 토큰/step에서 compute-bound가 되어야 한다.
감사의 말과 더 읽을거리
이 장은 여러 GPU 전문가들의 도움에 크게 기대었다:
- Adam Paszke는 GPU kernel 프로그래밍의 실상을 설명해 주었다.
- Swapnil Patil은 GPU 네트워킹이 어떻게 동작하는지 처음 알려 주었다.
- Stas Bekman은 GPU의 경험적 현실이 공표된 스펙과 다른 경우가 많다는 점을 짚어 주었다.
- Reiner Pope는 하드웨어 수준에서 GPU와 TPU가 어떻게 비교되는지 명확히 해 주었다.
- Frédéric Bastien은 칩 수준 이야기에 상세한 피드백을 주었다.
- Nouamane Tazi는 GPU에서의 LLM 학습 경험으로 roofline 섹션을 개선해 주었다.
- Sanford Miller는 GPU가 실제로 어떻게 네트워킹되는지, NVIDIA의 스펙이 현장에 배치된 것과 어떻게 다른지 이해하도록 도와주었다.
GPU에 관한 좋은 읽을거리는 많지만, 특히 좋아하는 것들은:
- SemiAnalysis의 NVIDIA Tensor Core 역사: GPU가 비디오 게임 엔진에서 ML 가속기로 변모한 과정을 그린 환상적인 글.
- SemiAnalysis의 Blackwell 성능 분석: NVIDIA GPU의 다음 세대를 이해하는 데 읽을 가치가 있다.
- H100 DGX SuperPod 레퍼런스: 큰 GPU 클러스터가 어떻게 네트워킹되는지에 관한, 건조하지만 유용한 자료. GB200 시스템에 관한 비슷한 문서는 여기.
- NVLink Switch에 관한 Hot Chips 발표: NVLink와 NCCL collective, 특히 in-network reduction에 관한 재미있는 자료.
- DeepSeek-V3 기술 보고서: sharding 구성을 어떻게 골랐는지 기술한, 크고 반쯤 공개된 LLM 학습 보고서의 좋은 예.
- CUDA Matmul 최적화하는 법: GPU의 캐시 일관성을 염두에 두고 CUDA Core로 효율적인 matmul을 구현하는 법을 설명하는 훌륭한 블로그.
- HuggingFace Ultra-Scale Playbook: GPU에서의 LLM 병렬화 가이드로, 이 장에 부분적으로 영감을 주었다.
- Making Deep Learning Go Brrrr From First Principles: LLM roofline과 성능 엔지니어링에 관한, GPU와 PyTorch 중심의 튜토리얼.
- Cornell의 Understanding GPU Architecture 사이트: 이 책과 비슷한 가이드로, GPU와 CPU 내부를 좀 더 구체적으로 비교한다.
부록 A: GB200에서는 무엇이 달라지는가?
Blackwell은 굵직한 네트워킹 변화를 여럿 도입한다. NVLink 5는 전체 NVLink bandwidth가 2배(900GB/s)다. B200은 H100처럼 여전히 8-GPU node지만, GB200 시스템(B200 GPU와 Grace CPU의 조합)은 훨씬 큰 NVLink 도메인을 도입한다(NVL72에서 72개, 이론상 최대 576개). 이 커진 NVLink 도메인은 사실상 node egress bandwidth도 키워, node 수준 위의 collective 비용을 줄인다.
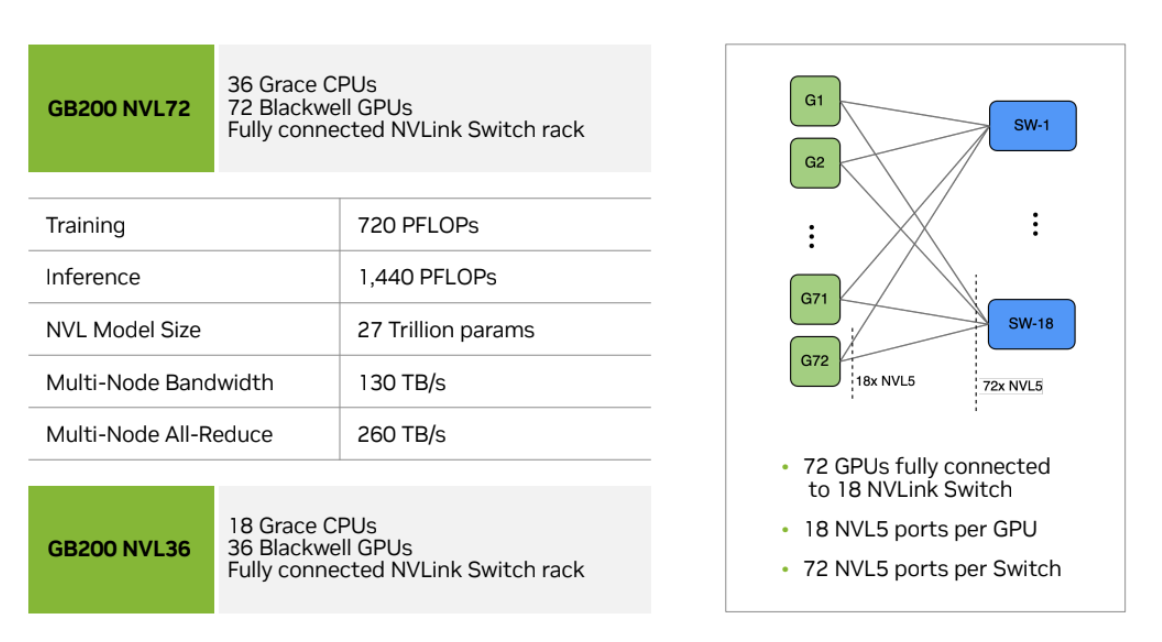
node 안에서는 늘어난 bandwidth(450GB/s에서 900GB/s)가 큰 차이를 만들지 않는다. GPU당 총 FLOPs/s도 2배가 되기 때문이다. roofline은 대체로 그대로지만, NVLink bandwidth가 훨씬 좋아져 Expert Parallelism이 쉬워진다.
node를 넘어가면 더 많은 것이 바뀐다. 여기서 가져온 SuperPod 다이어그램이다.
보다시피 node당 egress bandwidth가 H100의 400GB/s에서 4 * 18 * 400 / 8 = 3.6TB/s로 늘어난다. chip당 FLOPs도 2배가 되므로 실효 node 간 roofline은 약 4배 좋아진다. 이제는 오히려 scale-out 수준이 아니라 node 수준에서 병목이 걸리는지 걱정하기 시작할 수도 있다.
Grace Hopper: NVIDIA는 일정 수의 GPU를 Grace CPU와 짝지은 GH200과 GB200 시스템도 판다. 예컨대 GH200은 H200 1개 + Grace CPU 1개, GB200 시스템은 B200 2개 + Grace CPU 1개다. 이 시스템의 장점은 CPU가 full bandwidth NVLink 연결(NVLink C2C)로 GPU에 연결된다는 것이다. CPU-GPU bandwidth가 매우 높아 파라미터를 호스트 RAM으로 offload하는 데 유용하다. 다시 말해 어떤 GPU든 호스트 메모리에 도달하는 bandwidth가 다른 GPU의 HBM에 도달하는 것과 동일하다.
부록 B: 네트워킹 상세
NVLink 4 스위치의 다이어그램이다. 총 64개의 NVLink4 포트(각각 물리 lane 2개 사용)와 lane 간 스위칭을 담당하는 큰 crossbar가 있다. 대조적으로 TPU는 거울을 동적으로 재구성할 수 있는 광학 스위치를 쓴다.
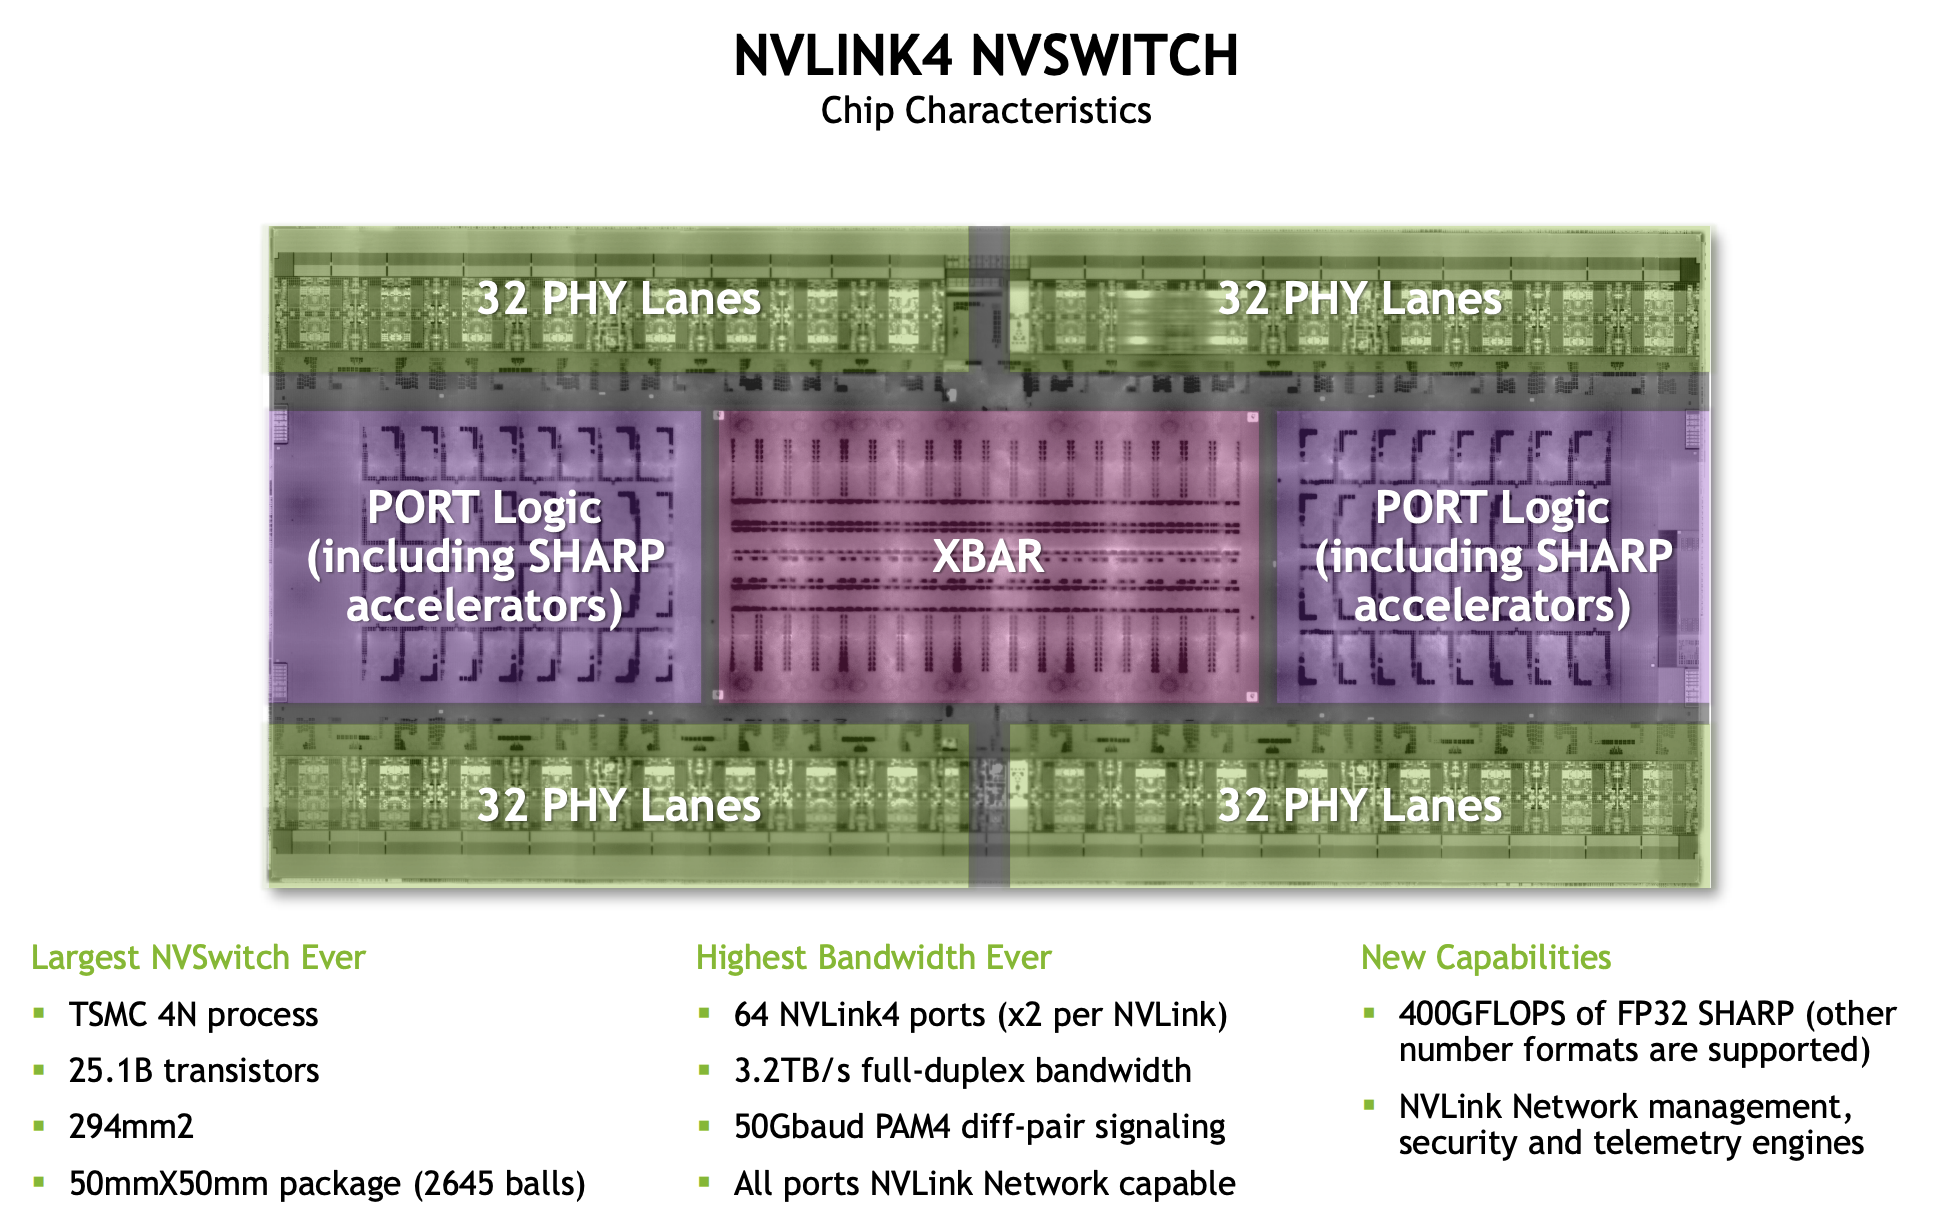
각 계층에서는 가용 링크 bandwidth 또는 총 스위치 bandwidth에 병목이 걸릴 수 있다.
- node 수준: node 수준에는 4 * 1.6TB/s = 6.4TB/s의 NVSwitch bandwidth가 있지만, 8개의 GPU 각각은 스위치로 450GB/s밖에 egress하지 못하므로 실제 peak bandwidth는 node 안에서 450e9 * 8 = 3.6TB/s(full-duplex)다.
- SU/leaf 수준: SU 수준에는 32개 node를 1x400 Gbps InfiniBand로 all-to-all 연결하는 스위치 8개가 있다. node들로부터 8 * 32 * 400 / 8 = 12.8TB/s의 egress bandwidth가 나오고, 스위치 수준도 8 * 1.6TB/s = 12.8TB/s로 정확히 일치한다.
- spine 수준: spine 수준에는 32개의 leaf 스위치를 2x400 Gbps 링크로 연결하는 스위치 16개가 있어 32 * 16 * 400 * 2 / 8 = 51.2TB/s의 egress bandwidth가 나온다. leaf 스위치와 달리 spine 스위치는 64개 포트 전부가 아래를 향하므로 스위치당 64 * 400 / 8 = 3.2TB/s의 트래픽을 옮길 수 있고, 16 * 3.2TB/s = 51.2TB/s로 스위치 수준에서도 정확히 일치한다.
GPU 기준으로는 node 수준에서 450GB/s의 GPU-to-GPU bandwidth, SU와 spine 수준에서는 50GB/s다.
GPU 실측 AR bandwidth:
TPU v5p bandwidth (1 axis):
AllGather bandwidth도 보자:
AllToAll 비용에 관하여:
근사식 를 참값 와 비교해 보자. 가 작은 경우를 빼면 둘은 비슷하다.
Footnotes
-
GPU의 Tensor Core는 SM의 행렬 곱셈 서브유닛이고, TPU의 TensorCore는 MXU, VPU 등을 담는 상위 유닛이다. ↩
-
NVIDIA에는 이것을 부르는 좋은 이름이 없어서, 여러 나쁜 선택지 중 그나마 나은 것으로 이 용어를 쓴다. Warp Scheduler는 본래 CUDA core 집합에 작업을 배분하는 유닛이지만, 여기서는 그 제어 유닛과 그것이 통제하는 코어 집합을 아울러 가리키는 데 쓴다. ↩
-
SM들은 독립적이지만, 용량이 제한된 L2 캐시를 모두가 공유하기 때문에 peak 성능을 위해서는 서로 조율할 수밖에 없는 경우가 많다. ↩
-
최신 GPU들은 엄밀히는 사이클당 두 FLOPs를 수행하는 FMA(Fused-Multiply Add) 명령을 지원하며, NVIDIA는 이 사실을 스펙 수치를 2배로 보고하는 데 가차 없이 활용한다. ↩
-
역사적으로 Tensor Core가 도입되기 전에는 CUDA core가 GPU의 주역이었고 렌더링 — ray-triangle 교차 판정과 shading 포함 — 에 쓰였다. 오늘날의 게이밍 GPU에서도 여전히 렌더링 작업의 대부분을 CUDA core가 담당하고, TensorCore는 업샘플링(DLSS)에 쓰인다. 덕분에 GPU는 더 낮은 해상도로 렌더링한 뒤(픽셀이 적을수록 일이 적다) ML로 업샘플할 수 있다. ↩
-
NVIDIA는 TC 하드웨어 세부 사항을 많이 공개하지 않으므로 이는 확정적 사실이라기보다 추측에 가깝다 — 적어도 TC가 어떻게 구현되었는지에 대해 말해 주는 바는 없다. V100은 TC당 사이클당 256 FLOPs를 수행할 수 있다고 알려져 있다. A100은 512, H100은 1024이고, B200의 세부 사항은 공개되지 않았지만
2250e12 / (148 * 4 * 1.86e9)가 약 2048이므로 TC당 사이클당 약 2048 FLOPs일 가능성이 높다. 몇 가지 추가 세부 사항은 여기서 확인된다. ↩ -
Ampere에서는 Tensor Core를 warp 하나로 먹여 살릴 수 있었지만, Hopper에서는 SM 전체(warpgroup)가 필요하고 Blackwell에서는 SM 2개가 공급한다. Blackwell에서는 matmul이 너무 커져 인자(특히 accumulator)가 레지스터 메모리/SMEM에 들어가지 않게 되었고, 이를 감당하기 위해 TMEM이 추가되었다. ↩
-
특정 SM에 스케줄된 warp들을 “resident”라고 부른다. ↩
-
엄밀히는 L2 캐시가 둘로 나뉘어 있어, H100에서는 SM들의 절반이 각각 25MB에 접근한다. 두 절반을 잇는 링크가 있지만 bandwidth는 더 낮다. ↩
-
L2 캐시가 모든 SM에 공유된다는 사실은, 원칙적으로는 SM들이 독립 유닛임에도 결국 프로그래머가 SM들을 상당히 조율된 방식으로 돌리도록 강제한다. ↩
-
NVIDIA가 B100 세대를 만들긴 했지만 잠깐만 판매·생산되었는데, 알려진 바로는 공칭 스펙에 가깝게 동작하지 못하게 만드는 설계 결함 때문이었다. 발열·전력 문제로 스로틀링 없이 peak FLOPs를 달성하는 데 애를 먹었다. ↩
-
딥러닝 붐 이전의 GPU(“Graphics Processing Unit”)는 말 그대로 그래픽스를 — 주로 비디오 게임을 위해 — 처리했다. 비디오 게임은 물체를 수백만 개의 작은 삼각형으로 표현하고, 게임은 이 삼각형들을 초당 30-60번씩 화면에 표시될 2D 이미지로 렌더링(“rasterize”)한다(이 빈도를 framerate라 부른다). rasterization은 이 삼각형들을 카메라 좌표계로 투영하고 어떤 삼각형이 어떤 픽셀에 겹치는지를 초당 수십억 번 계산하는 일이다. 짐작하겠지만 이는 매우 비싸고, 그나마 시작일 뿐이다. 그다음에는 광선과 교차하는, 어쩌면 반투명한 여러 삼각형의 색을 합성해 각 픽셀에 색을 입혀야 한다. GPU는 이런 연산을 극도로 빠르게 하도록, 그러면서 범용성을 염두에 두고 설계되었다. 서로 다른 GPU 워크로드(“shader”)를 동시에 여럿 돌려야 하고 어느 한 연산이 지배적이지 않기 때문이다. 그 결과 소비자용 그래픽스 중심 GPU도 행렬 곱셈을 할 수는 있지만, 그것이 본업은 아니다. ↩
-
이 intensity가 최근 GPU 세대에 걸쳐 일정하게 유지된다는 점이 눈에 띈다. H100은 33.5 / 3.5이고 B200은 80 / 8이다. 왜 그런지는 분명치 않지만 흥미로운 관찰이다. ↩
-
node라는 용어는 과부하되어 두 가지를 뜻할 수 있다: NVLink 도메인(NVLink 인터커넥트로 완전 연결된 GPU 집합), 또는 단일 CPU 호스트에 연결된 GPU 집합. B200 이전에는 둘이 대개 같았지만, GB200 NVL72에서는 NVLink 도메인에 GPU가 72개인데 호스트당 GPU는 여전히 8개다. 여기서는 node를 NVLink 도메인의 의미로 쓰지만, 논쟁의 여지가 있는 용법이다. ↩
-
NVLink는 저지연에 프로토콜 오버헤드가 작지만 확장성/내결함성을 위해 설계되지는 않은, 일종의 고성능 개조판 PCIe 연결 같은 것이라고 들었다. 반면 InfiniBand는 더 큰 lossy 네트워크를 위해 설계된, Ethernet에 가까운 것이다. ↩
-
여기서 full-duplex란 각 방향으로 25GB/s씩, 두 방향이 서로 독립이라는 뜻이다. 링크 전체로는 총 50GB/s를 보낼 수 있지만 한 방향으로는 최대 25GB/s다. ↩
-
예컨대 Meta는 이 설명과 크게 다른 데이터센터 네트워크에서 LLaMA-3를 학습했다. Ethernet, 3계층 스위치드 패브릭, 그리고 최상위의 oversubscribed 스위치를 썼다. ↩
-
각 GPU가 크기 인 자기 chunk를 나머지 개의 GPU 각각에 보내 총 바이트를 통신한다고 생각해도 되고, 같은 답이 나온다. ↩
-
참 비용은 사실 즉 주사위를 번 굴렸을 때 서로 다른 눈의 기대 개수지만, 주어진 근사와 매우 가깝다. 자세한 내용은 부록을 보라. ↩