How to Scale Your Model · Part 3
Sharded 행렬과 곱셈 방법
Sharded Matrices and How to Multiply Them
큰 ML 모델을 학습할 때는 파라미터나 입력을 여러 가속기에 걸쳐 쪼개야(“shard”) 한다. LLM은 대부분 행렬 곱셈으로 이루어져 있으므로, 이를 이해하는 일은 결국 장치들에 나뉘어 있는 행렬을 곱하는 방법을 이해하는 것으로 귀결된다. 이 장에서는 TPU 통신 primitive의 비용에 기반한 간단한 sharded 행렬 곱셈 이론을 전개한다.
Partitioning 표기법과 collective 연산
LLM을 1만 개의 TPU나 GPU에서 학습할 때도, 추상적으로는 하나의 장치에서 학습할 때와 똑같은 연산을 하고 있다. 다른 점은 배열이 단일 TPU/GPU의 HBM에 들어가지 않는다는 것이고, 그래서 배열을 쪼개야 한다.1 이를 배열을 “sharding” 또는 “partitioning”한다고 말한다. 스케일링의 기술은 연산이 효율적으로 유지되도록 모델을 sharding하는 방법을 알아내는 데 있다.
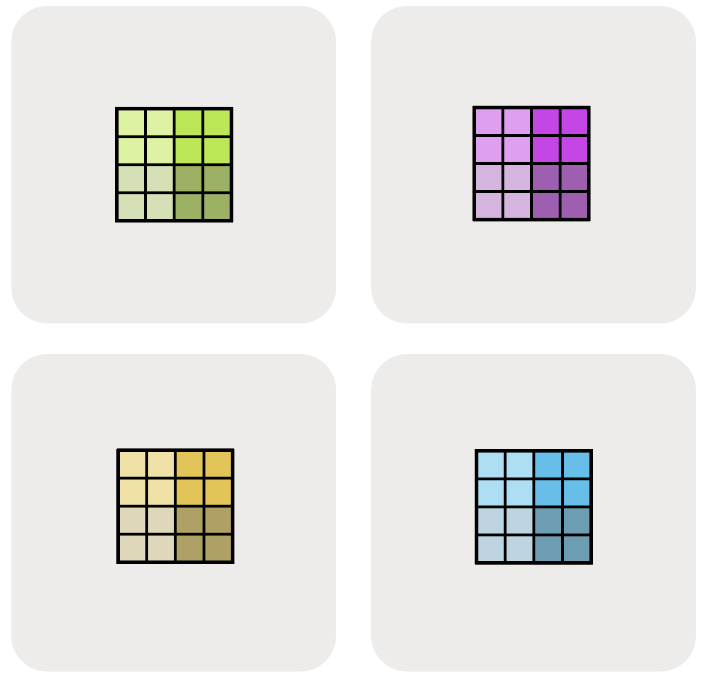
2D 배열 A를 4개의 TPU에 sharding한 예를 보자:
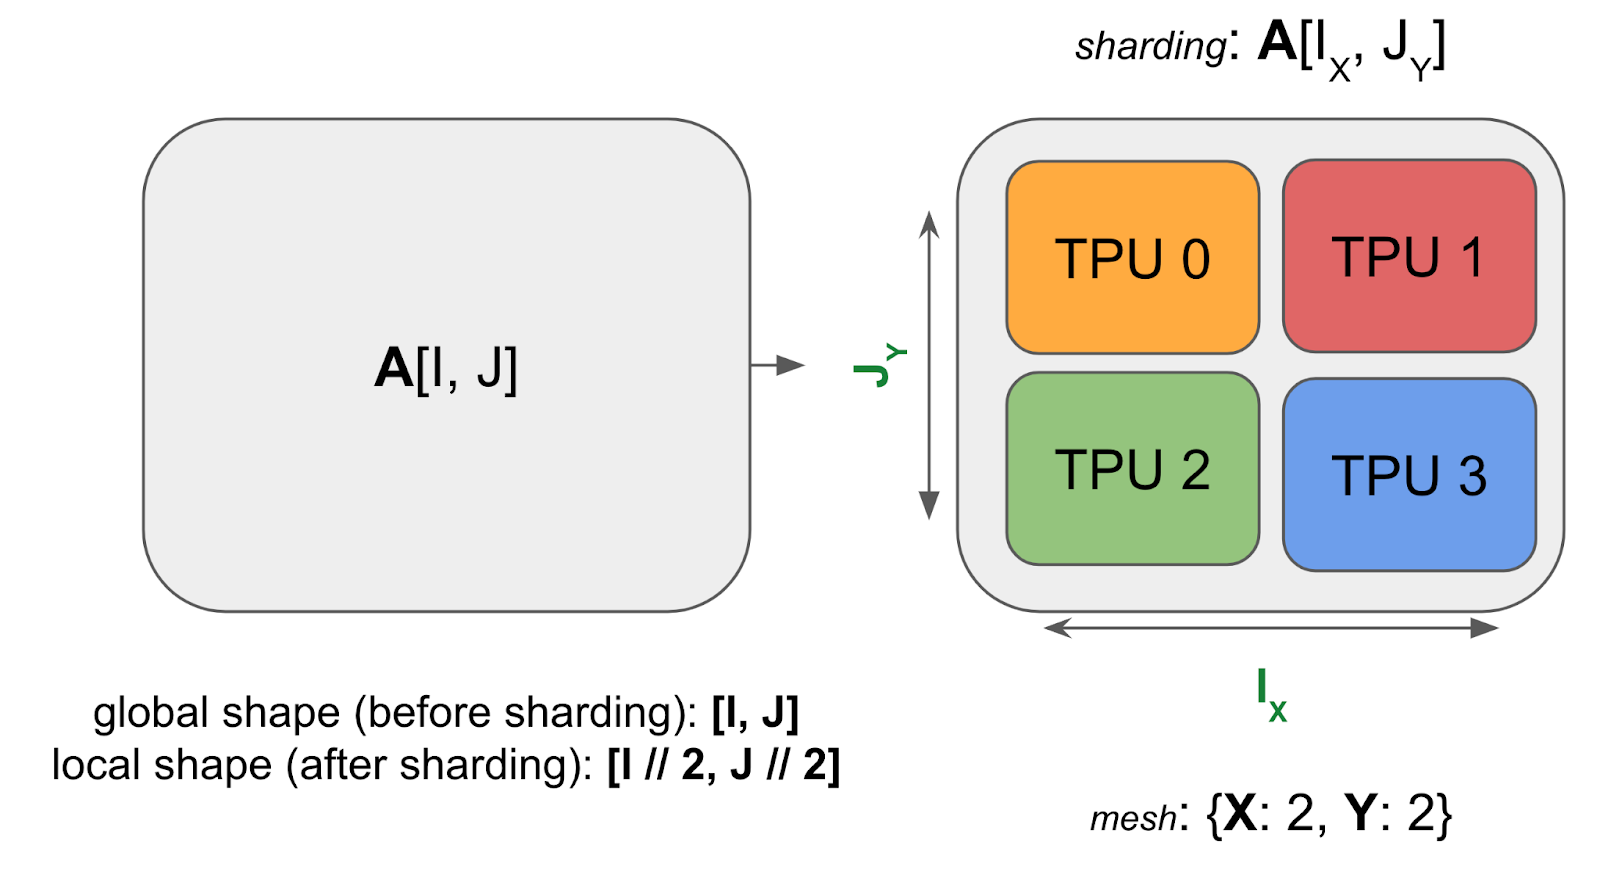
sharding된 배열도 sharding되지 않은 배열과 같은 global shape(또는 logical shape) — 예컨대 (4, 128) — 을 그대로 유지한다는 점에 주목하자. 하지만 동시에 device local shape — 예컨대 (2, 64) — 도 갖는데, 이것이 각 TPU가 실제로 담고 있는 크기(바이트)를 알려 준다(위 그림에서 각 TPU는 전체 배열의 ¼을 담는다). 이제 이를 임의의 배열로 일반화해 보자.
Sharding을 위한 통일된 표기법
텐서가 장치들에 걸쳐 블록 단위로 어떻게 sharding되는지는 named-axis notation(이름 붙은 축 표기법)의 변형으로 기술한다. device mesh라 부르는 2D 또는 3D 장치 그리드의 존재를 가정하고, 각 axis에 mesh axis 이름(예: X, Y, Z)을 붙인다. 그런 다음 배열의 각 이름 붙은 차원이 물리적 mesh axis들에 걸쳐 어떻게 분할되는지를 기술함으로써, 행렬 데이터가 device mesh 위에 어떻게 배치되는지 명시한다. 이 배정을 sharding이라 부른다.
예시 (위 다이어그램): 위 다이어그램의 경우:
- Mesh: 위의 device mesh
Mesh(devices=((0, 1), (2, 3)), axis_names=('X', 'Y'))— 4개의 TPU가 2x2 그리드에 있고 axis 이름은 와 다. - Sharding: — 첫 번째 axis인 를 mesh axis 를 따라, 두 번째 axis인 를 mesh axis 를 따라 shard하라는 뜻이다. 이 sharding은 각 shard가 배열의 을 담는다는 것을 알려 준다.
이 둘을 합치면 배열의 local shape(개별 장치가 담는 shard의 크기)이 임을 알 수 있다. 여기서 는 A의 첫 번째 차원의 크기이고 는 A의 두 번째 차원의 크기다.
Pop Quiz [한 axis에 대한 2D sharding]: sharding이 이고 mesh가 {'X': 8, 'Y': 2}인 배열 fp32[1024, 4096]을 생각하자. 각 장치는 얼마만큼의 데이터를 담는가? H100에서 이 배열을 HBM에서 로드하는 데 시간이 얼마나 걸리는가(칩당 메모리 bandwidth는 3.4e12로 가정)?
정답 보기
는 첫 번째 차원(I)을 X와 Y 하드웨어 axis 모두를 따라 shard한다. 이 예에서 local shape은 이다. 주어진 예의 global shape이 fp32[1024, 4096]이므로 local shape은 fp32[64, 4096]이다.
각 GPU가 4 * 64 * 4096 = 1MiB 바이트를 담고 있으므로 약 1e6 / 3.4e12 = 294ns가 걸린다. 다만 이렇게 작은 크기에서는 각종 오버헤드 때문에 실제로는 이보다 상당히 오래 걸릴 가능성이 크다.
이 sharding들을 시각화하기: 4개 장치에 나뉜 2D 데이터 배열을 보면서 이 sharding들을 시각화해 보자:
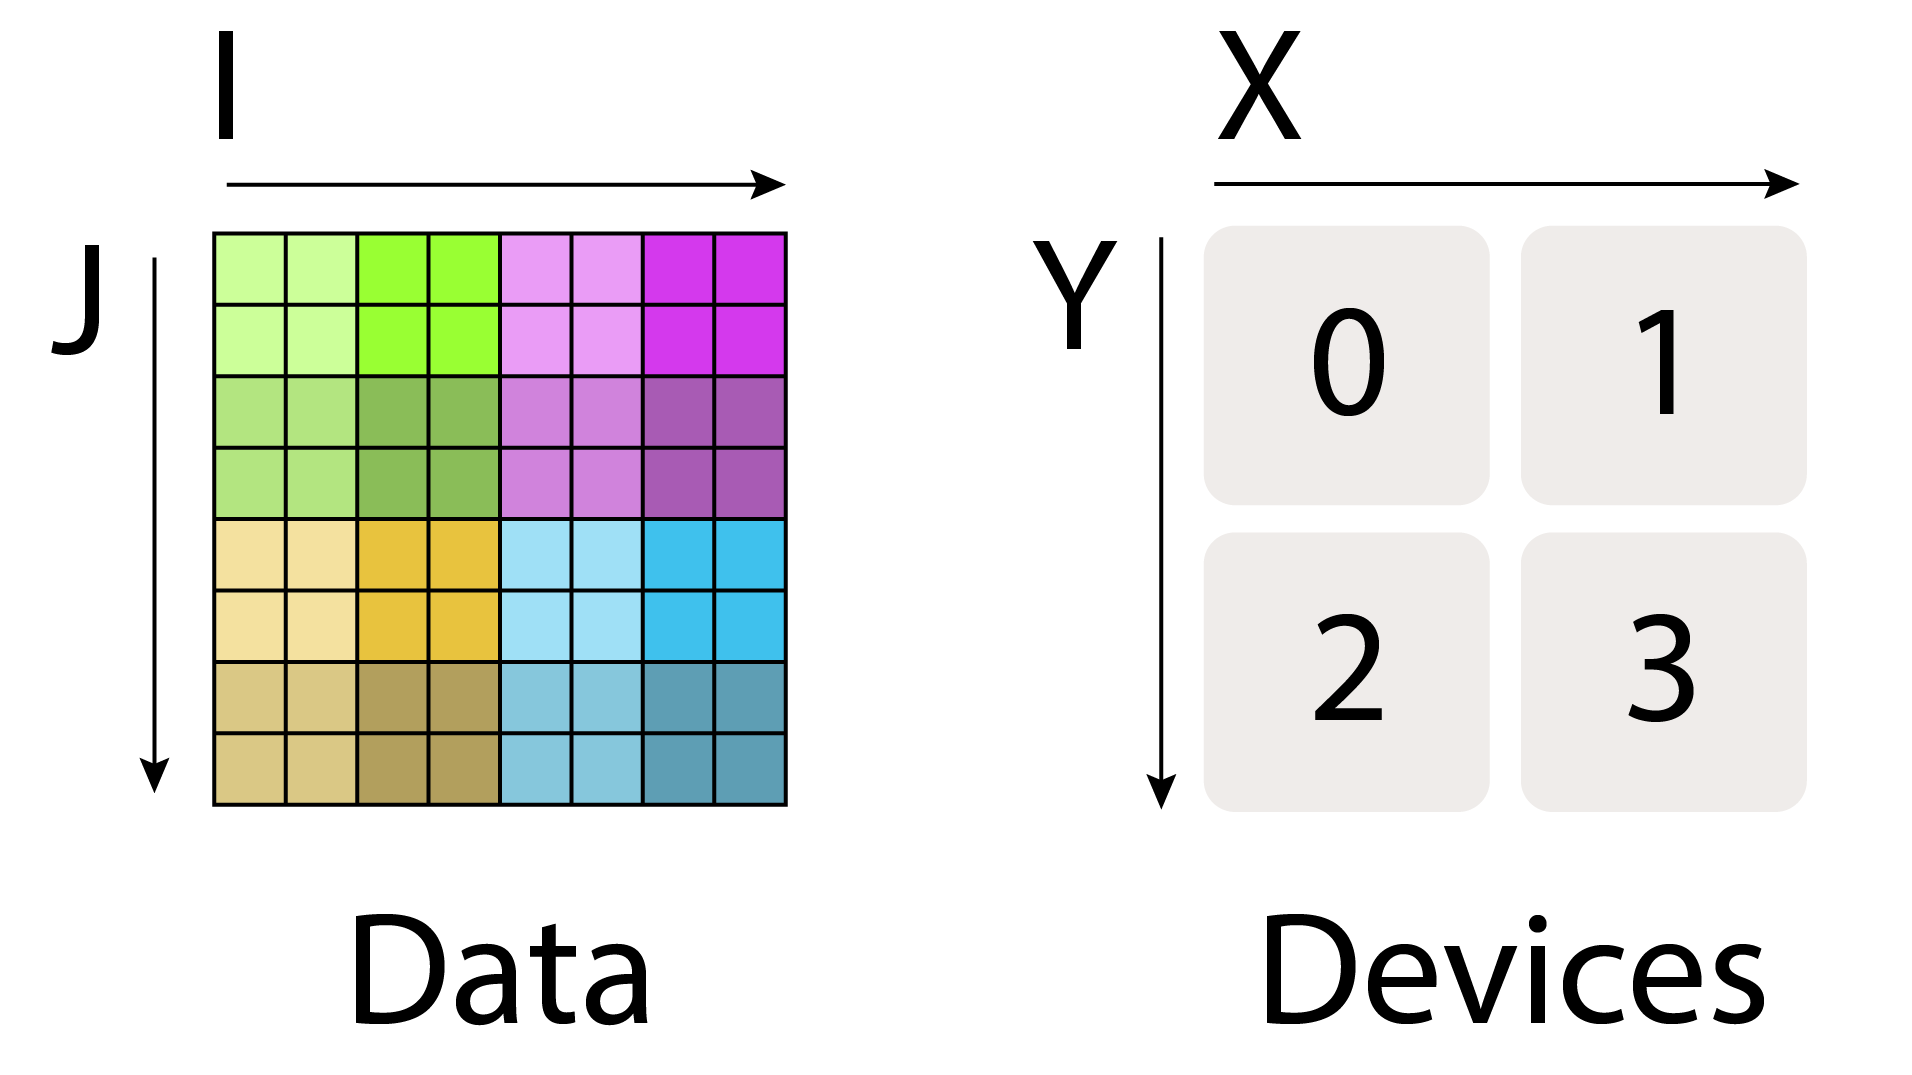
행렬의 fully-replicated(완전 복제) 형태는 sharding 배정 없이 그냥 로 쓴다. 각 장치가 행렬 전체의 완전한 복사본을 담고 있다는 말이다.
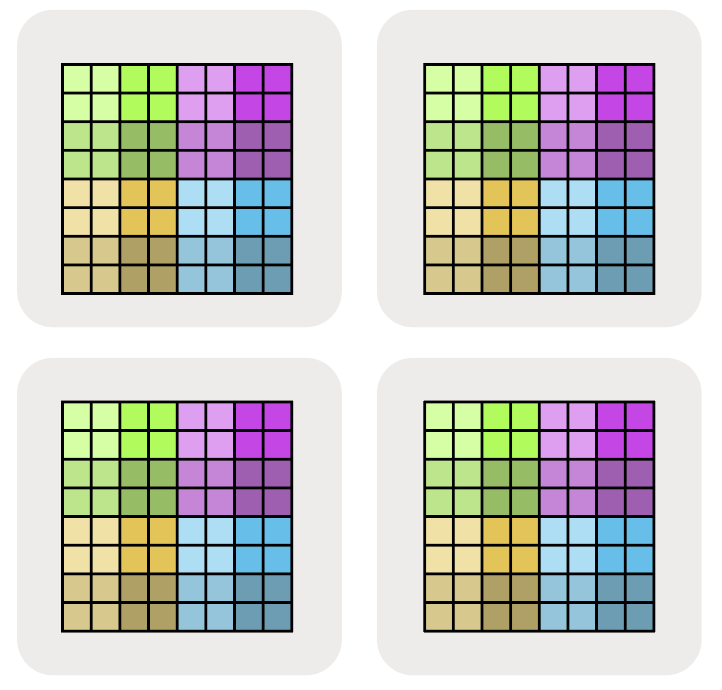
이 차원들 중 하나가 어떤 mesh axis에 걸쳐 분할되었음은 아래첨자 mesh axis로 표시한다. 예컨대 는 I 논리 axis가 X mesh 차원에 걸쳐 분할되었지만 J 차원은 분할되지 않았고, 블록들이 Y mesh axis에 걸쳐 partially-replicated(부분 복제) 상태로 남아 있다는 뜻이다.
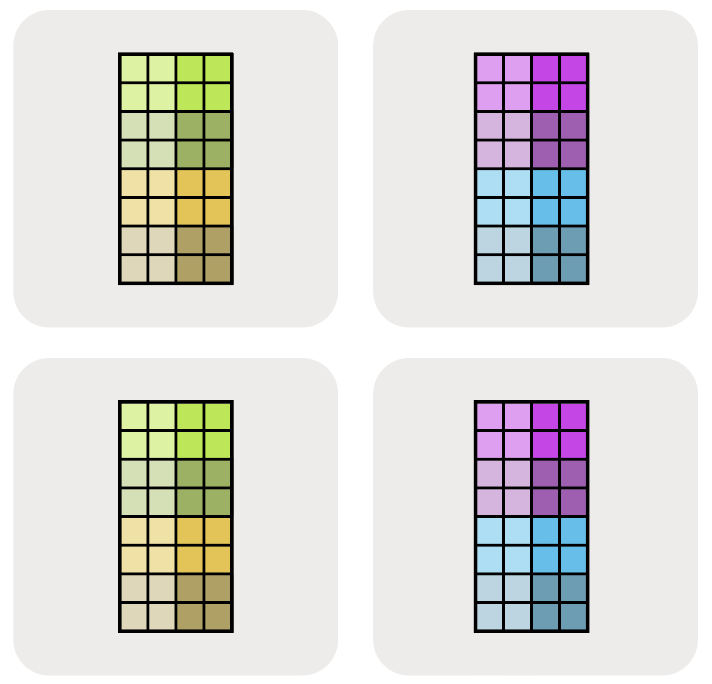
는 I 논리 axis가 X mesh axis에 걸쳐, J 차원이 Y mesh axis에 걸쳐 분할되었음을 뜻한다.
나머지 가능성들은 아래 그림에 그려 두었다:
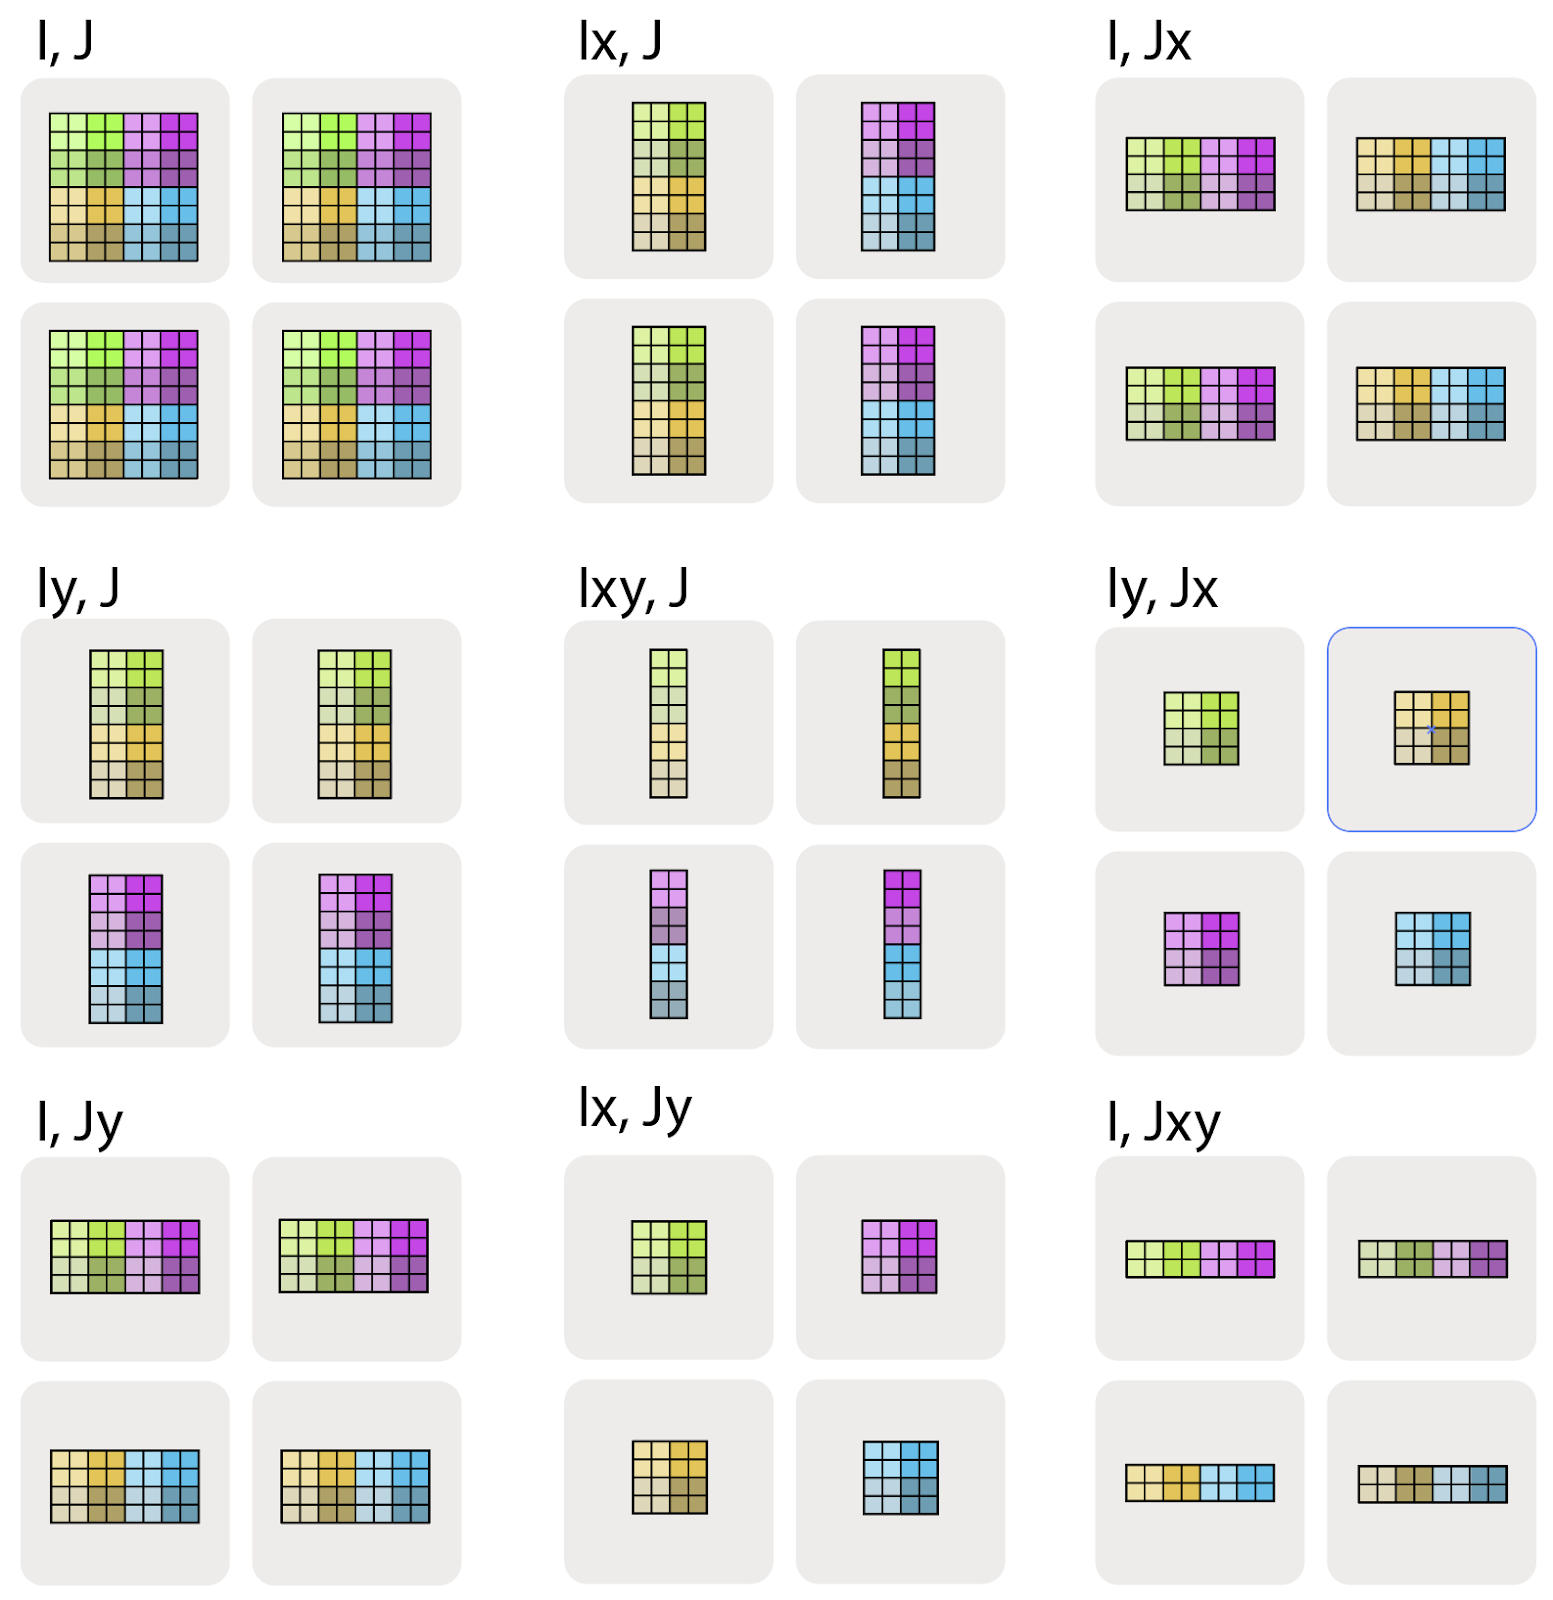
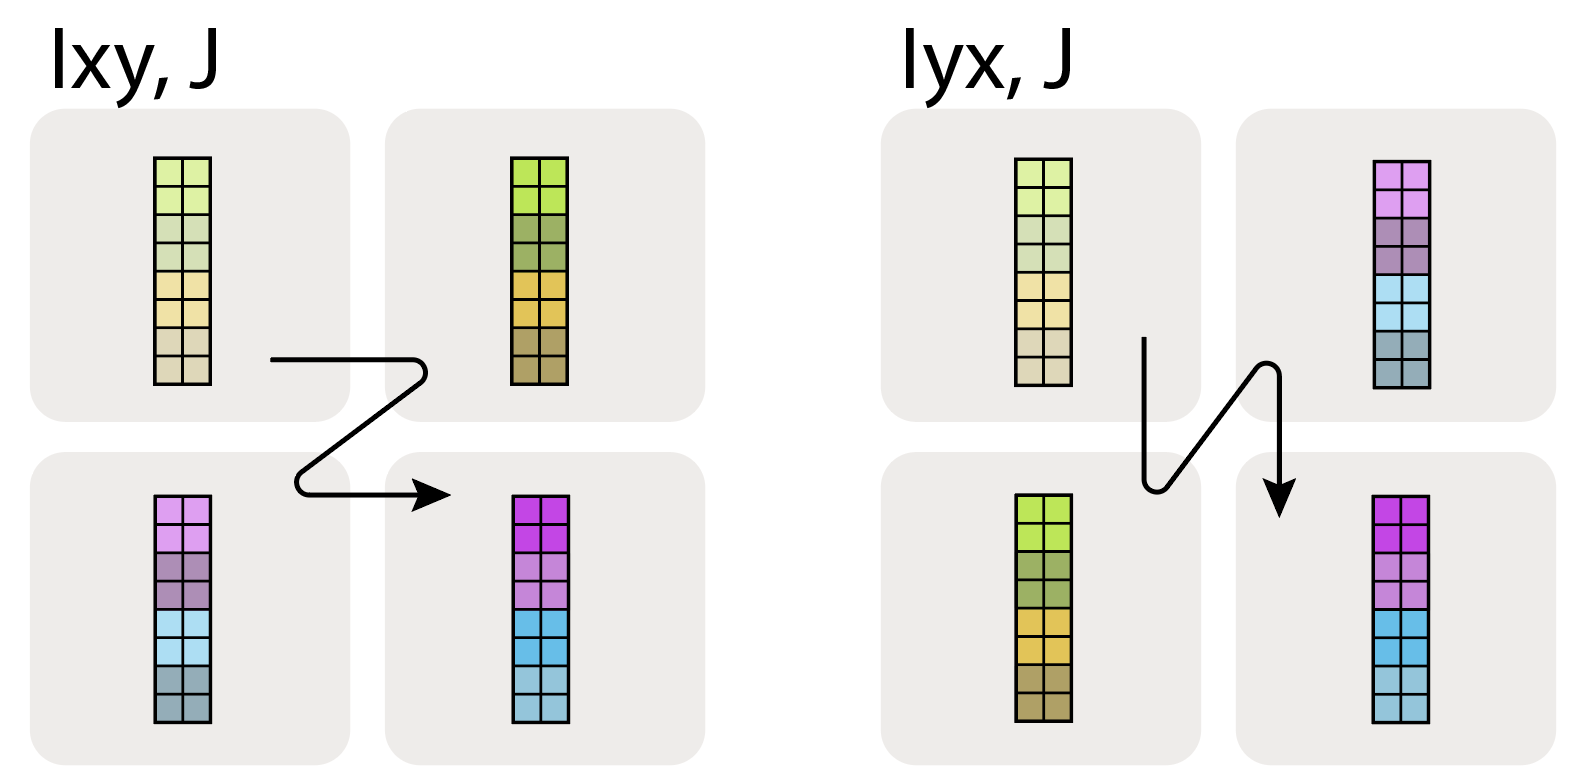
여기서 는 X와 Y mesh axis를 하나의 더 큰 평탄화된(flattened) 차원으로 취급해 I 이름 axis를 모든 장치에 걸쳐 분할한다는 뜻이다. 여러 mesh-axis 아래첨자의 순서는 그리드에 걸친 분할의 순회(traversal) 순서를 지정하므로 중요하다.
마지막으로, 여러 이름 axis를 같은 mesh 차원을 따라 shard할 수는 없다는 점에 유의하자. 예컨대 는 말이 안 되는, 금지된 sharding이다. 어떤 mesh 차원이 배열의 한 차원을 shard하는 데 한 번 쓰이고 나면, 그 차원은 어떤 의미에서 이미 “소진된” 것이다.
Pop Quiz: A가 shape int8[128, 2048], sharding , mesh Mesh({'X': 2, 'Y': 8, 'Z': 2})(총 32개 장치)인 배열이라고 하자. A는 장치당 메모리를 얼마나 쓰는가? 전체 장치에 걸쳐서는 총 메모리를 얼마나 쓰는가?
정답 보기
정답: 배열 A는 X와 Y에 걸쳐 sharding되고 Z에 걸쳐 복제되므로, 장치당 shape은 int8[128 / (2 * 8), 2048] = int8[8, 2048]이고 크기는 8 * 2048 = 16,384 바이트다. Z에 걸쳐 복제되기 때문에 — 각 Z-평면 안에서는 X와 Y에 완전히 sharding되어 있지만 — 원본 배열의 완전한 복사본이 (Z-평면당 하나씩) 2개 존재한다. 따라서 전체 장치에 걸친 총 크기는 원본 배열 크기 × Z 복제 수 = 128 * 2048 * 2 = 총 512 KiB다. 또는 32개 장치 × 장치당 16,384 바이트 = 총 512 KiB로 검산할 수도 있다.
코드로는 어떻게 표현하는가?
지금까지는 코드 이야기를 피해 왔지만, 이제 슬쩍 엿보기 좋은 시점이다. JAX는 위에서 설명한 추상 문법과 아주 비슷하게 대응되는 named sharding 문법을 사용한다. 10장에서 더 다루겠지만, 여기서 미리 잠깐 보자. 여기 Google Colab에서 직접 갖고 놀면서 JAX가 서로 다른 sharding을 어떻게 다루는지 프로파일링해 볼 수 있다. 이 스니펫은 세 가지 일을 한다:
- 8개의 TPU를 ‘X’와 ‘Y’라는 이름이 붙은 4x2 그리드로 매핑하는 jax.Mesh를 만든다.
- A는 두 차원 모두 sharding되고 B는 출력 차원을 따라 sharding되도록 행렬 A와 B를 만든다.
- sharded 배열을 반환하는 간단한 행렬 곱셈을 컴파일하고 수행한다.
import jax
import jax.numpy as jnp

# Create our mesh! We're running on a TPU v2-8 4x2 slice with names 'X' and 'Y'.
# The Auto axis type tells JAX to let the XLA compiler infer intermediate shardings.
assert len(jax.devices()) == 8
Auto = jax.sharding.AxisType.Auto
mesh = jax.make_mesh(axis_shapes=(4, 2), axis_names=('X', 'Y'), axis_types=(Auto, Auto))

# A little utility function to help define our sharding. A PartitionSpec is our
# sharding (a mapping from axes to names).
def P(*args):
  return jax.NamedSharding(mesh, jax.sharding.PartitionSpec(*args))

# We shard both A and B over the non-contracting dimension and A over the contracting dim.
A = jnp.zeros((8, 2048), dtype=jnp.bfloat16, device=P('X', 'Y'))
B = jnp.zeros((2048, 8192), dtype=jnp.bfloat16, device=P(None, 'Y'))

# We can perform a matmul on these sharded arrays! out_shardings tells us how we want
# the output to be sharded. JAX/XLA handles the rest of the sharding for us.
y = jax.jit(lambda A, B: jnp.einsum('BD,DF->BF', A, B), out_shardings=P('X', 'Y'))(A, B)
JAX의 멋진 점은 이 배열들이 마치 sharding되지 않은 것처럼 동작한다는 것이다! B.shape은 global(logical) shape인 (2048, 8192)를 알려 준다. 실제로 로컬에서 어떻게 sharding되어 있는지 보려면 B.addressable_shards를 봐야 한다. 이 배열들에 연산을 수행하면, JAX가 연산을 수행하기 위해 어떻게 broadcast하거나 reshape해야 할지 알아서 찾아내려 한다. 예컨대 위 예시에서 A의 local shape은 [2, 1024]이고 B는 [2048, 4096]이다. JAX/XLA는 최종 곱셈을 수행하는 데 필요한 통신을 이 배열들 사이에 자동으로 추가한다.
Sharded 배열로 하는 연산
여러 장치에 분산된 데이터 배열이 있고 그 위에서 수학 연산을 수행하고 싶다면, 데이터와 연산 양쪽을 sharding하는 데 따르는 오버헤드는 무엇일까?
당연히 어떤 연산이냐에 달려 있다.
- elementwise 연산의 경우, 분산된 배열에 연산하는 데 오버헤드가 없다.
- 여러 장치에 흩어져 있는 원소들에 걸친 연산을 수행하고 싶을 때는 일이 복잡해진다. 다행히 머신러닝에서는 거의 모든 연산이 행렬 곱셈 형태이고, 행렬 곱셈은 분석하기 비교적 단순하다.
이 절의 나머지는 sharded 행렬을 곱하는 방법을 다룬다. 1차 근사로는 각 청크를 온전히 곱하거나 합할 수 있도록 행렬의 청크들을 이리저리 옮기는 일이다. 각 sharding마다 필요한 통신이 다르다. 예를 들어 는 contracting 차원(실제로 합산이 일어나는 차원인 J)이 sharding되어 있지 않으므로 아무 통신 없이 곱할 수 있다. 반면 출력이 sharding되지 않기를 원한다면(즉 ), 와 를, 혹은 를 (AllGather를 사용해) 모든 장치로 복사해야 한다. 이 두 선택은 통신 비용이 다르므로, 그 비용을 계산해 더 낮은 쪽을 골라야 한다.
"블록 행렬 곱셈"의 관점에서 생각해 볼 수도 있다
이를 이해하려면 “블록 행렬”, 즉 행렬들의 중첩 행렬 개념을 떠올리는 것이 도움이 된다:
행렬 곱셈에는 좋은 성질이 있다: 피승수들을 블록으로 표현하면, 곱도 표준 규칙을 따르는 블록 matmul들로 표현된다:
즉 분산 행렬 곱셈을 구현하는 일은, 이 sharded 블록들을 네트워크로 옮기고 블록들에 대해 로컬 행렬 곱셈을 수행한 뒤 그 결과들을 합하는 것으로 환원된다. 그렇다면 문제는 어떤 통신을 추가할 것인가, 그리고 그것이 얼마나 비싼가다.
편리하게도, 가능한 모든 sharding은 고려해야 할 대략 4가지 경우로 요약되고, 각 경우마다 어떤 통신을 추가해야 하는지에 대한 규칙이 있다.
- Case 1: 어느 입력도 contracting 차원을 따라 sharding되어 있지 않다. 아무 통신 없이 로컬 shard들을 곱할 수 있다.
- Case 2: 한 입력의 contracting 차원이 sharding되어 있다. 보통 sharding된 입력을 contracting 차원을 따라 “AllGather”한다.
- Case 3: 두 입력 모두 contracting 차원을 따라 sharding되어 있다. 로컬 shard들을 곱한 다음 결과를 “AllReduce”한다.
- Case 4: 두 입력 모두 non-contracting 차원이 같은 axis를 따라 sharding되어 있다. 먼저 두 입력 중 하나를 AllGather하지 않고는 진행할 수 없다.
이 규칙들은 그냥 따르면 되는 규칙으로 생각해도 되지만, 왜 성립하는지 그리고 비용이 얼마나 드는지 이해하는 것도 가치가 있다. 이제 하나씩 자세히 살펴보자.
Case 1: 어느 입력도 contracting 차원이 sharding되지 않은 경우
보조정리(Lemma): sharded 행렬들을 곱할 때, contracting 차원이 sharding되어 있거나 두 행렬이 같은 axis를 따라 sharding되어 있는 경우가 아니라면 연산은 유효하고 출력은 입력의 sharding을 따른다. 예를 들어 다음은
아무런 통신 없이 잘 작동하며, 결과는 X와 Y 하드웨어 차원 모두에 걸쳐 sharding된 텐서가 된다. 왜 그런지 생각해 보자. 각 배치 원소가 contraction되는 axis의 로컬 청크를 갖고 있어서 그것을 곱하고 reduce할 수 있으므로, 기본적으로 연산은 sharding과 독립적이다. 다음 경우들은 모두 문제없이 작동하며 이 규칙을 따른다:
A도 B도 contracting 차원 J가 sharding되어 있지 않으므로, 입력들의 로컬 블록 행렬 곱셈을 그냥 수행하면 결과가 이미 원하는 출력 sharding대로 sharding되어 있다. 두 피승수의 non-contracting 차원이 같은 axis를 따라 sharding되어 있으면 이 성질은 더 이상 성립하지 않는다(자세한 내용은 아래 Case 4 절을 보라).
Case 2: 한쪽 입력의 contracting 차원이 sharding된 경우
한 입력 A가 contracting 차원 J를 따라 sharding되어 있고 B는 완전히 복제되어 있을 때 무엇을 해야 할지 생각해 보자:
A의 전체 contracting 차원에 걸쳐 합산해야 하는데 그 차원이 X axis에 걸쳐 쪼개져 있으므로, A와 B의 로컬 청크를 그냥 곱할 수는 없다. 보통은 먼저 A의 shard들을 “AllGather”해서 모든 장치가 완전한 복사본을 갖게 만든 다음에야 B와 곱한다:
이렇게 하면 실제 곱셈을 각 장치에서 온전히 수행할 수 있다.
요점(Takeaway): 곱하는 행렬 중 하나가 contracting 차원을 따라 sharding되어 있으면, 일반적으로 그 행렬을 먼저 AllGather해서 contraction이 더 이상 sharding되지 않게 만든 다음 로컬 matmul을 수행한다.
B가 X를 따라 sharding되어 있지 않은 경우에는, 로컬 부분 matmul을 수행한 뒤 sharded partial sum들을 합산(또는 AllReduce)할 수도 있다. 이렇게 하면 연산을 shard할 수 있지만 보통 통신 비용이 더 높다. 어떤 경우에는 이쪽이 더 빠를 수도 있으나, 실전에서는 B도 sharding되어 있는 것이 보통이다. 아래 연습 문제 4에서 언제 이쪽이 더 나은지 다룬다.
AllGather란 무엇인가? AllGather는 우리가 다룰 첫 번째 핵심 MPI 통신 primitive다. AllGather는 한 axis를 따라 sharding을 제거하고, 장치들에 흩어진 shard들을 그 axis를 따라 각 장치 위에 다시 조립한다. 위 표기법으로 말하면, AllGather는 축들의 집합에서 아래첨자를 제거한다. 예:
주어진 차원의 아래첨자를 전부 제거해야 하는 것은 아니다. 예컨대 도 (한 axis에 대해서만 수행한) AllGather다. 또한 non-contracting 차원의 sharding을 제거하기 위해 AllGather를 쓰고 싶을 수도 있다. 예컨대 행렬 곱셈
에서는 처음에 A를 AllGather해서 입력 sharding을 제거할 수도 있고, sharded matmul을 수행한 다음 결과 C를 AllGather할 수도 있다.
AllGather는 실제로 어떻게 수행되는가? 단일 TPU axis(링) 둘레로 1차원 AllGather를 수행하려면, 기본적으로 각 TPU가 자기 shard를 링을 따라 옆으로 넘기는 일을 모든 장치가 복사본을 가질 때까지 반복한다.2 애니메이션으로 보면:
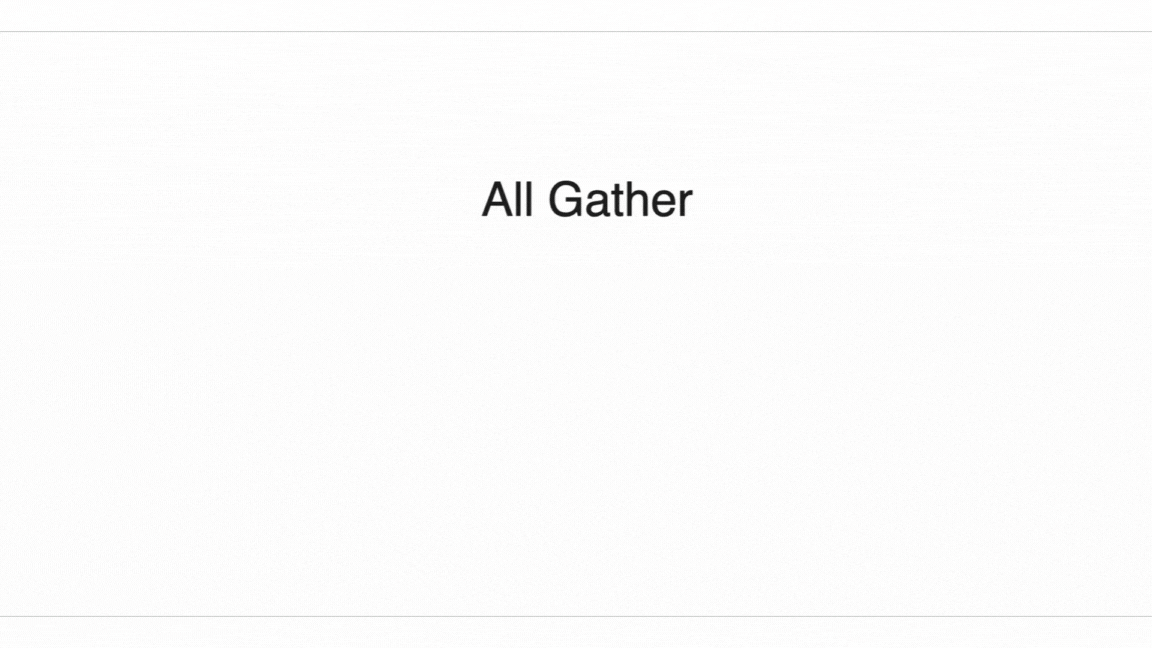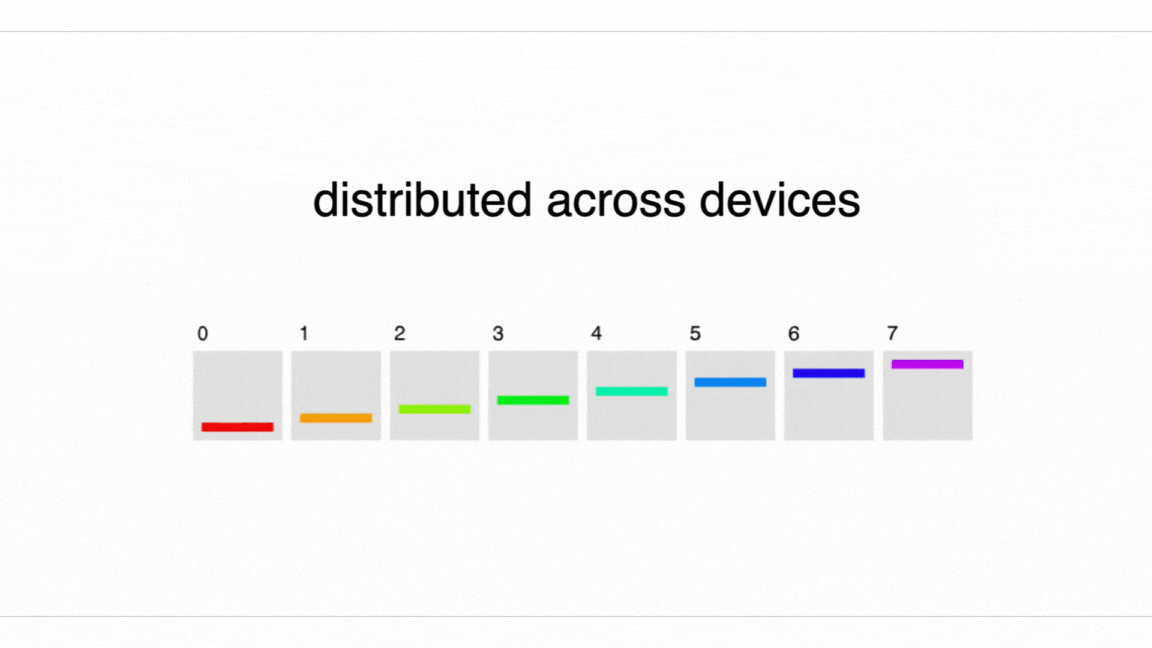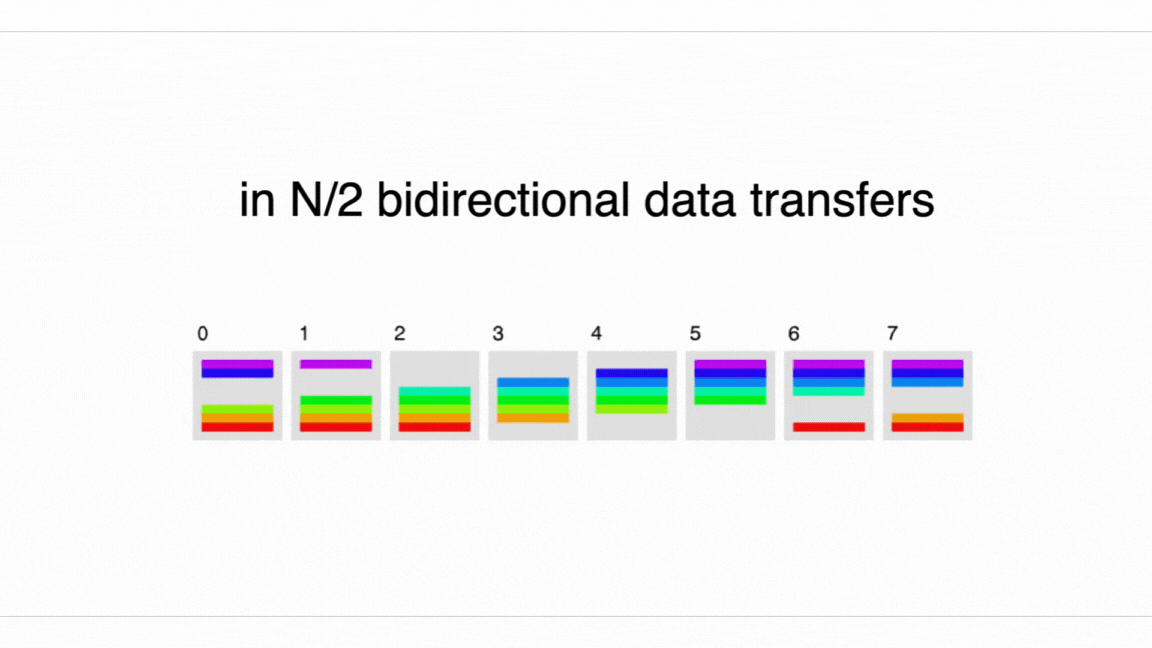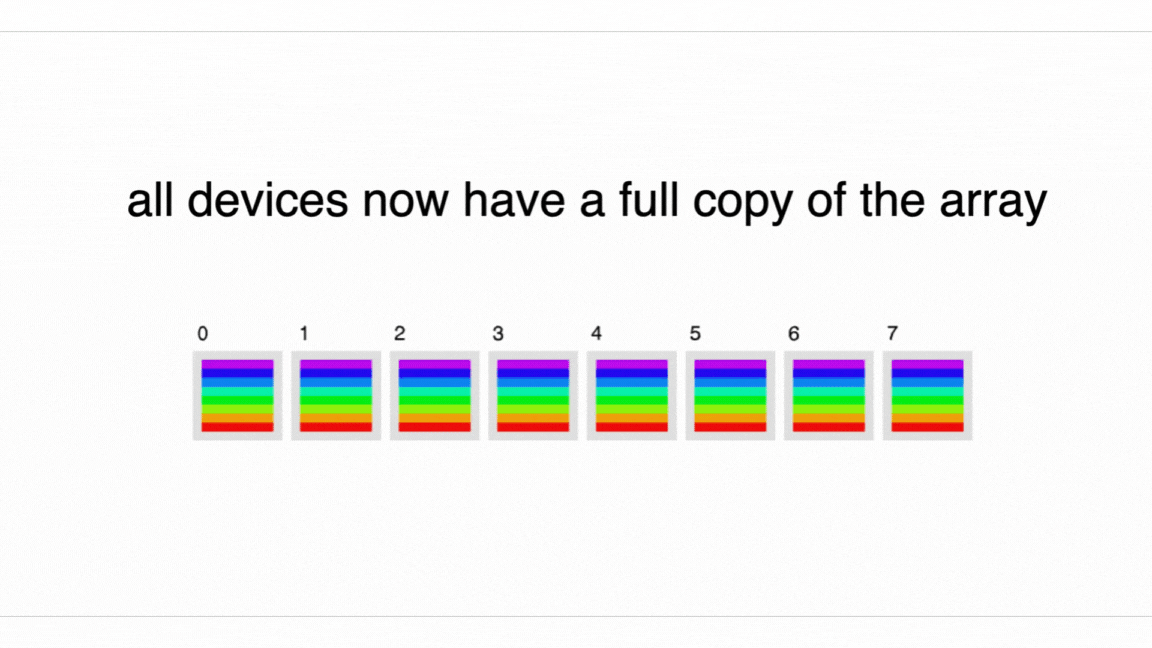
AllGather는 한 방향으로 할 수도 있고 양방향으로 할 수도 있다(위에는 양방향이 그려져 있다). 한 방향으로 하면 각 TPU는 크기 의 청크를 링 둘레로 홉에 걸쳐 보낸다. 양방향이면 크기 의 홉이 번 있다.
시간이 얼마나 걸리나? 양방향 AllGather를 잡고 시간이 얼마나 걸리는지 계산해 보자. 배열의 바이트 수를 , contracting 차원의 shard 수를 라 하자. 위 다이어그램에서 각 홉은 각 방향으로 바이트를 보내므로 각 홉에 걸리는 시간은
이다. 여기서 는 양방향 ICI bandwidth다.3 모든 TPU에 도달하려면 총 홉을 보내야 하므로4 전체 reduction은 다음과 같다:
주목할 점: 이것은 에 의존하지 않는다! 꽤 놀라운 사실이다. TPU들이 로컬로만 연결되어 있는데도 연결의 지역성이 문제가 되지 않는다는 말이다. 그저 각 링크의 속도에 병목이 걸릴 뿐이다.
요점(Takeaway): throughput-bound 영역에서 AllGather(또는 ReduceScatter나 AllReduce)를 수행할 때, 실제 통신 시간은 배열의 크기와 가용 bandwidth에만 의존하고, 배열이 몇 개의 장치에 sharding되어 있는지에는 의존하지 않는다!
ICI latency에 대한 노트: ICI 링크의 각 홉에는 데이터 양과 무관한 고유의 오버헤드가 있다. 보통 1us 정도다. 그래서 배열 가 아주 작아서 각 홉이 1us도 안 걸릴 때는, 계산이 에 의존하는 “latency-bound” 영역에 들어가기도 한다.
자세한 유도 보기
단일 홉의 최소 시간을 이라 하자. 그러면
이다. 홉을 수행하기 때문이다. 큰 reduction이나 gather에서는 확실하게 bandwidth bound다. 보내는 데이터가 워낙 많아서 홉당 오버헤드는 사실상 무시할 만하다. 하지만 (모델에서 샘플링할 때처럼) 작은 배열에서는 이것이 무시할 수 없게 되고, ICI bandwidth는 상관이 없어진다. 순전히 latency에 묶이는 것이다. 달리 말하면, 특정 TPU — 예컨대 단방향 ICI bandwidth가 4.5e10인 TPU v5e — 에서 4.5e10 * 1e-6 = 45kB보다 작은 버퍼를 보내는 일은 무엇이든 latency bound가 된다.
다음은 TPU v5e 8x16 슬라이스에서 AllGather bandwidth를 실측한 것이다. 배열은 16 axis에 걸쳐 sharding되어 있어 완전한 양방향 링을 갖는다.
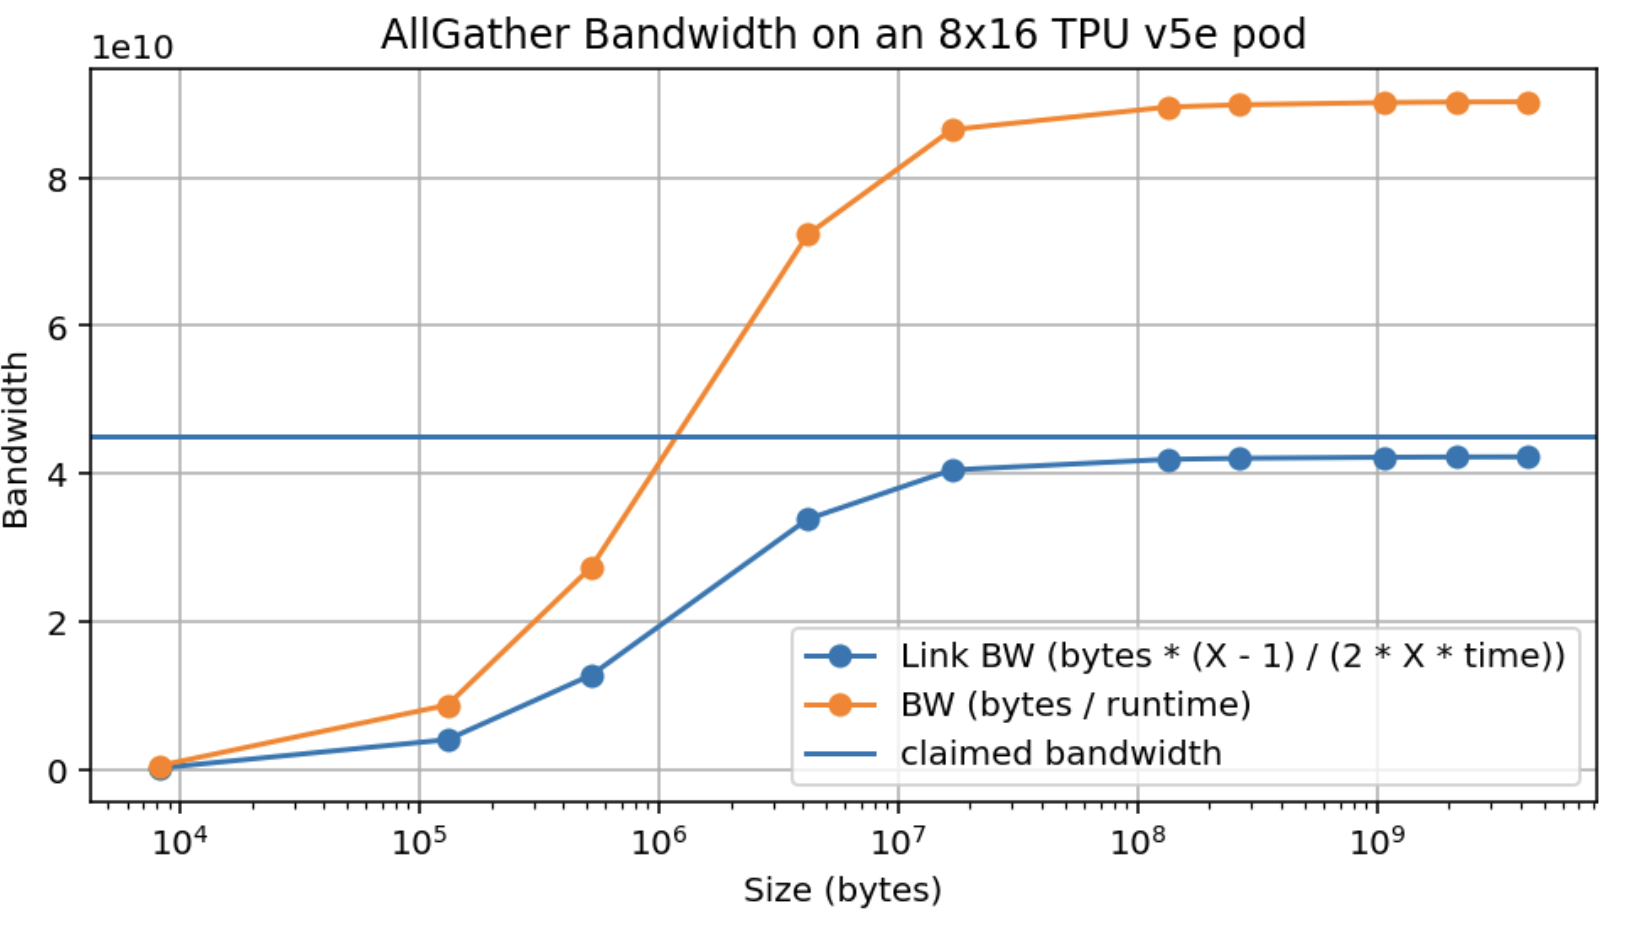
공칭 peak bandwidth(4.5e10)의 약 95%를 달성할 뿐 아니라, 이 peak에 약 10MB에서 도달한다는 점에도 주목하자. 16-way sharding이면 장치당 약 625kB인 셈이다(여담: 이는 GPU보다 훨씬 좋은 수치다).
여러 axis에 걸쳐 AllGather하면 어떻게 되나? 여러 axis에 걸쳐 gather할 때는 gather를 수행할 ICI 차원이 여러 개가 된다. 예컨대 AllGatherXY([B, DXY])는 두 개의 하드웨어 mesh axis에 걸쳐 동작한다. 그러면 가용 bandwidth가 배로 늘어난다.
latency까지 고려하면 일반 규칙은 다음과 같다:
여기서 는 TPU mesh에서 가장 긴 경로의 길이다.
Pop Quiz 2 [AllGather 시간]: 2장의 수치를 이용해, 2D mesh {'X': 8, 'Y': 4}인 TPU v5e에서 , 일 때 bfloat16으로 AllGatherY([EY, F]) → [E, F]를 수행하면 시간이 얼마나 걸리는가? 이면 어떤가?
정답 보기
정답: 기본량 몇 가지를 계산하는 데서 시작하자:
- TPU v5e는 2개 axis 각각에 대해 4.5e10 bytes/s의 단방향 ICI bandwidth를 갖는다.
- (a)의 bfloat16에서는 이므로 각 장치는 shape bf16[512, 8192]인 배열을 담고, 크기는 512 * 8192 * 2 = 8.4MB다. 전체 배열의 크기는 2048 * 8192 * 2 = 34MB다.
*파트 (1)*은 위 공식을 쓸 수 있다. 한 axis에 대한 AllGather이므로 이다. latency-bound가 아닌지 확인해 보면, 크기 4인 axis에서는 최대 3홉이므로 latency 하한은 3us 정도라서 전혀 가깝지 않다. 다만 TPU v5e는 axis 크기가 16일 때만 wraparound 연결이 있어서, 여기서는 완전한 양방향 AllGather를 실제로는 할 수 없다. 가장자리의 데이터가 반대쪽 가장자리에 도달하려면 3홉이 필요하므로, 이론상으로는 에 가깝다. 여기에 이 Colab에서 얻은 실제 프로파일이 있는데 를 보여준다. 이론 bandwidth의 100%를 얻지는 못할 테니 합리적인 값이다! *파트 (2)*는 각 shard의 크기가 64 * 256 * 2 = 32kB. 32e3 / 4.5e10 = 0.7us이므로 latency bound다. 3홉이 필요하므로 대략 3 * 1us = 3us가 걸린다. 실제로는 8us에 가깝다.
참고(Note): {'X': 16, 'Y': 4} 같은 2D mesh가 있을 때, 각 axis가 반드시 특정 하드웨어 axis에 대응해야 하는 것은 아니다. 예컨대 위 mesh는 하드웨어 axis 2개를 axis에 합친 4x4x4 TPU v5p 큐브를 기술하는 것일 수도 있다. 이 이야기는 나중에 여러 axis에 걸친 data parallelism을 설명할 때 다시 등장한다.
Case 3: 양쪽 입력 모두 contracting 차원이 sharding된 경우
세 번째 기본 경우는 두 피승수 모두 contracting 차원이 같은 mesh axis를 따라 sharding된 경우다:
이 경우 로컬 sharded 블록 행렬 곱셈은 최소한 수행 가능은 하다. 같은 contracting 인덱스 집합을 공유하기 때문이다. 하지만 각각의 곱은 원하는 전체 곱의 partial sum일 뿐이고, X 차원을 따라 각 장치에는 이 최종 결과물의 서로 다른 partial sum들이 남는다. 이 상황이 워낙 흔해서 이 조건을 명시적으로 표시하도록 표기법을 확장한다:
표기 **{ UX }**는 “X mesh axis를 따라 unreduced(아직 합산되지 않음)“라고 읽으며, 이 연산이 어떤 의미에서 “미완성” — 마지막 합산이 남아 있어야 비로소 완료되는 — 상태임을 가리킨다. 문법은 로컬 합산까지는 수행하되 결과를 unreduced 상태로 남겨 둔다는 뜻이다.
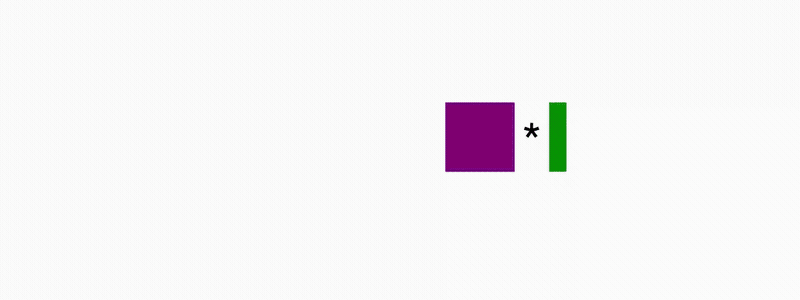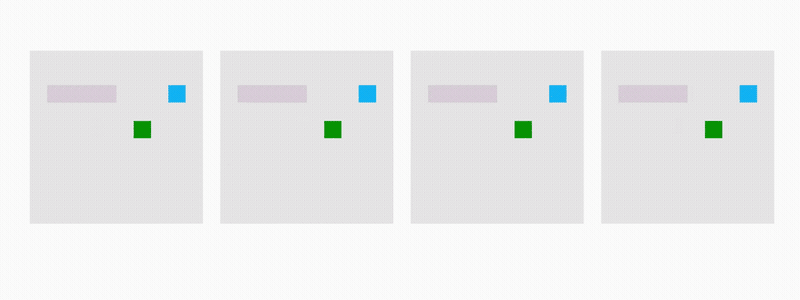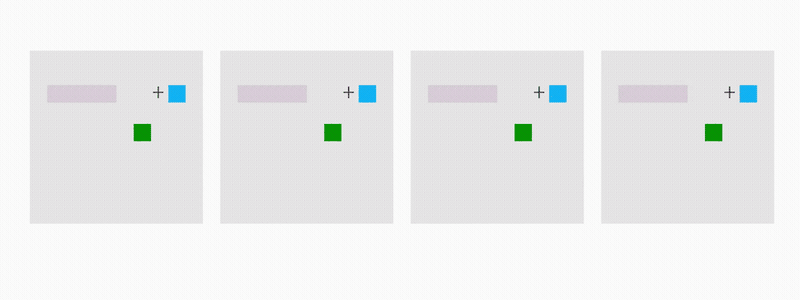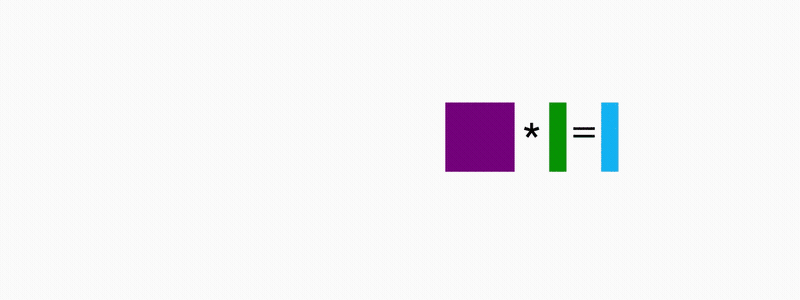
행렬 곱셈과 outer product에 관한 다음 결과로 보면 된다:
여기서 ⊗는 outer product다. 따라서 axis X 위의 TPU i가 A의 i번째 열과 B의 i번째 행을 갖고 있다면, 로컬 행렬 곱셈으로 을 얻을 수 있다. 이 행렬은 각 원소 자리에, A • B가 그 자리에 갖는 합의 i번째 항을 담고 있다. mesh axis X에 걸쳐 sharding해 둔 P에 대한 그 합산은 여전히 수행해야 전체 A • B를 얻는다. A와 B를 블록(즉 shard) 단위로 쓰고 결과의 각 shard에 대해 합산해도 똑같은 방식으로 작동한다.
이 합산을 X axis에 걸친 완전한 AllReduce로 수행하면 문제가 해소된다:
AllReduce는 partial sum들을 제거해, axis를 따라 각 장치가 완전히 합산된 같은 값을 갖게 만든다. AllReduce는 이 절에서 다룰 핵심 통신 여러 개 중 두 번째다. 첫 번째는 AllGather였고, 나머지는 ReduceScatter와 AllToAll이다. AllReduce는 unreduced(부분 합산된) axis를 가진 배열을 받아, 그 shard들을 unreduced axis 둘레로 돌리며 결과를 누적하는 방식으로 합산을 수행한다. 시그니처는 다음과 같다:
단순히 접미사를 제거할 뿐, 그 외에는 결과를 바꾸지 않는다.
AllReduce는 비용이 얼마나 드나? AllReduce가 어떻게 수행되는지에 대한 한 가지 멘탈 모델은, 모든 장치가 자기 shard를 이웃들에게 보내고 받은 shard를 전부 합산한다는 것이다. 각 “shard”가 전체 배열과 같은 shape을 가지므로 AllGather보다 분명히 비싸다. 일반적으로 AllReduce는 AllGather보다 2배 비싸다. 이를 보는 한 가지 방법은 AllReduce가 두 개의 다른 primitive의 합성으로 표현된다는 점이다: ReduceScatter와 AllGather다. AllReduce처럼 ReduceScatter도 배열의 partial sum을 해소하지만, 출력은 주어진 차원을 따라 ‘scatter’(분할)된 상태로 나온다. AllGather는 그 조각들을 전부 모아 논리 axis를 그 물리 axis를 따라 ‘unpartition/unshard/replicate’한다.
ReduceScatter는? AllGather가 sharded 배열을 재조립(아래첨자 제거)하듯이, ReduceScatter는 unreduced/부분 합산된 배열을 합산하면서 다른 논리 axis를 같은 mesh axis를 따라 scatter(shard)한다. . 애니메이션이 그 과정을 보여준다: AllGather와 매우 비슷하지만, 각 shard를 그대로 보관하는 대신 서로 합산한다는 점이 다르다. 따라서 reduction 자체를 수행하는 시간을 제외하면 latency는 거의 같다.
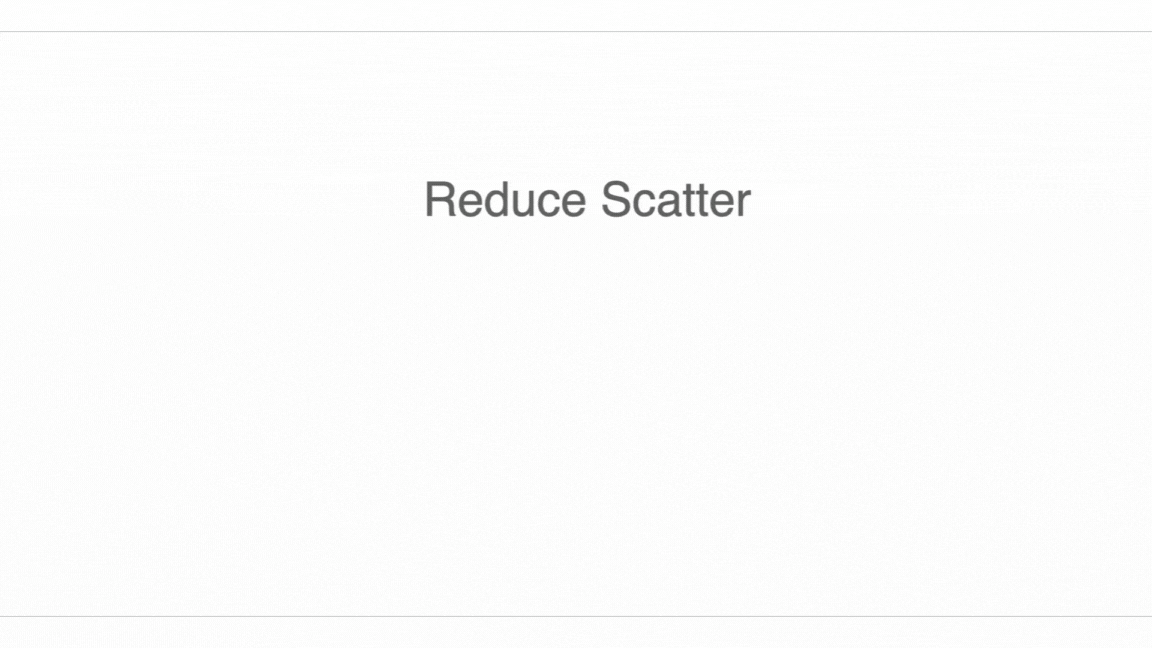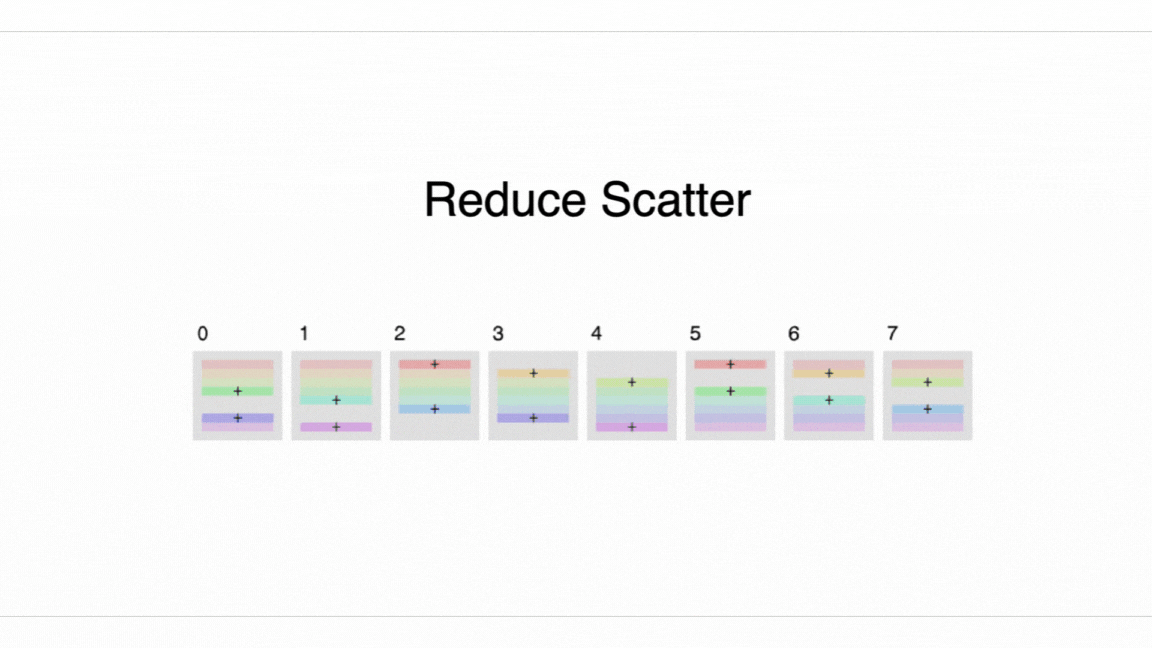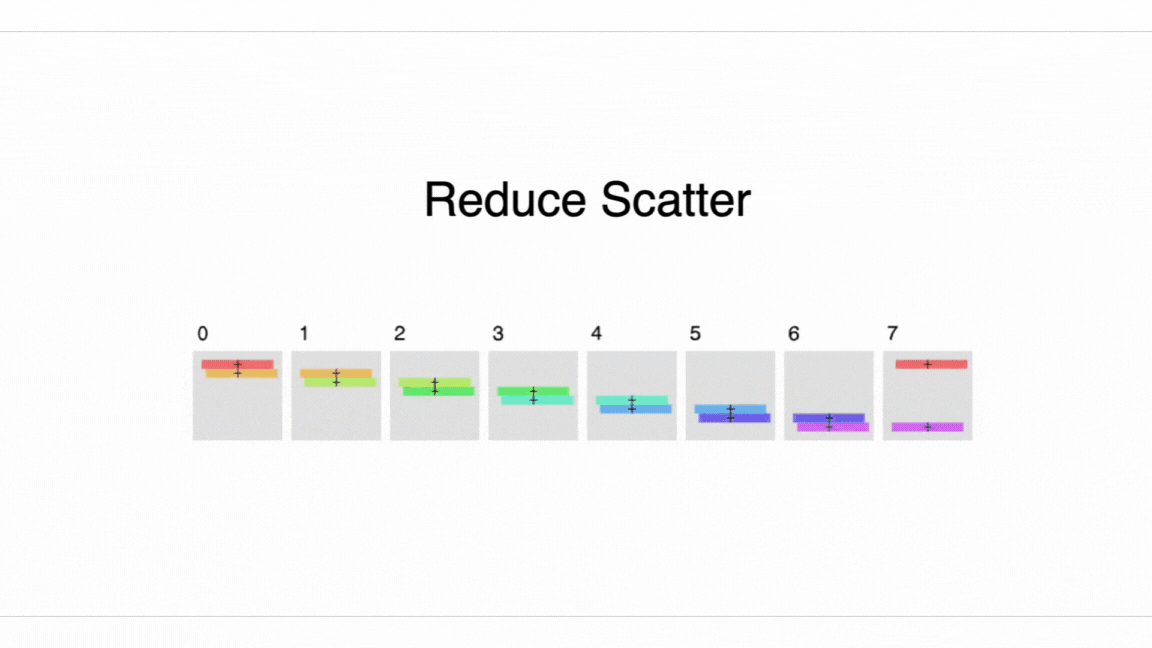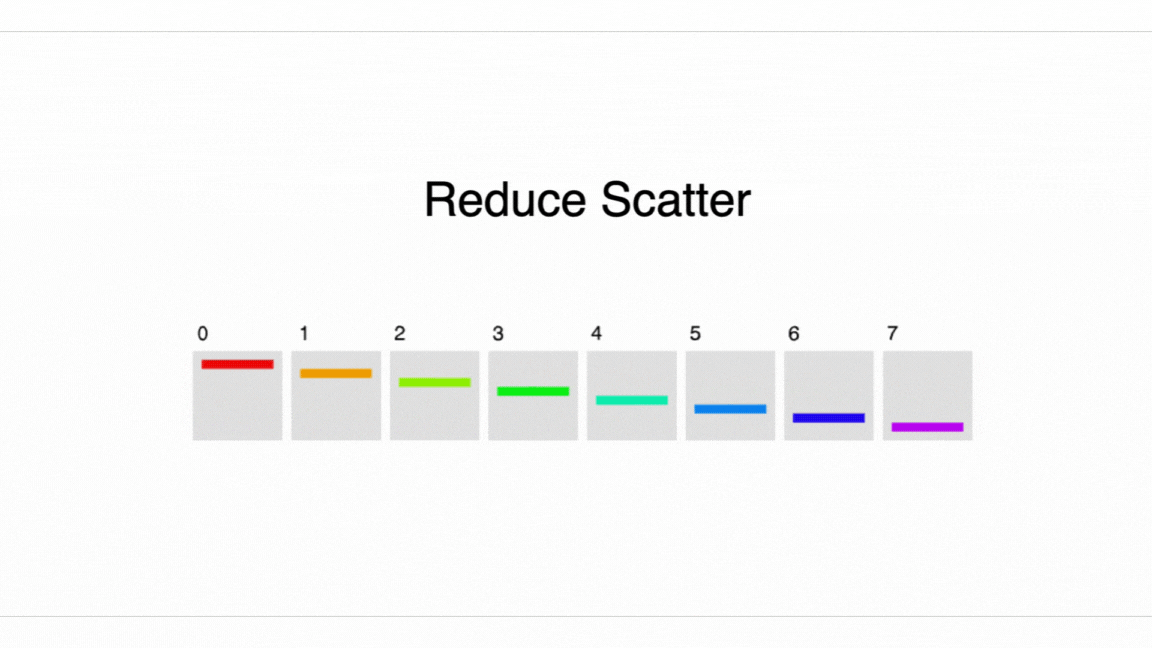
각 홉의 통신 시간은 AllGather와 마찬가지로 shard당 바이트 를 bandwidth 로 나눈 것이므로 다음과 같다:
여기서 는 양방향 bandwidth다 — reduce를 수행할 완전한 링이 있는 한.
Case 4: 양쪽 입력의 non-contracting 차원이 같은 axis를 따라 sharding된 경우
각 mesh 차원은 하나의 텐서를 shard할 때 최대 한 번만 나타날 수 있다. 위 규칙들을 수행하다 보면 이 규칙이 깨지는 상황에 이르기도 한다. 예컨대:
이것이 유효하지 않은 이유는, 차원 X를 따라 어떤 shard i를 생각하면 그 shard가 C의 **(i, i)**번째 shard, 즉 대각 성분을 갖게 되기 때문이다. 그러면 모든 shard를 모아도 결과의 대각 성분 말고는 복원할 수 있는 정보가 없으므로, 이 sharding은 허용할 수 없다.
해결책은 일부 차원을 AllGather하는 것이다. 여기에는 두 가지 선택지가 있다:
또는
어느 쪽이든 결과의 shape에는 X가 한 번만 나타난다. 어느 쪽을 고를지는 이어지는 연산들이 어떤 sharding을 필요로 하느냐에 따라 정해진다.
TPU 통신 primitive 깊이 보기
앞의 4가지 경우에서 sharded 행렬 곱셈을 수행하는 데 쓰이는 “핵심 통신 primitive” 몇 가지가 등장했다:
- AllGather: sharding에서 아래첨자 하나를 제거하며 shard들을 모은다.
- ReduceScatter: 배열의 “un-reduced” 접미사를 그 axis에 걸친 shard 합산으로 제거하되, 배열은 두 번째 axis에 대해 sharding된 채로 남긴다.
- AllReduce: “un-reduced” 접미사를 제거하며, 배열을 그 axis를 따라 unsharded 상태로 남긴다.
Mixture of Experts(MoE) 모델을 비롯한 여러 연산에서 등장하는 핵심 통신 primitive가 하나 더 있다: AllToAll이다.
마지막 통신 primitive: AllToAll
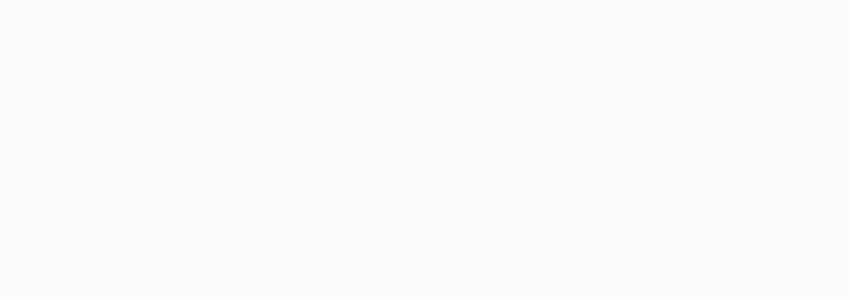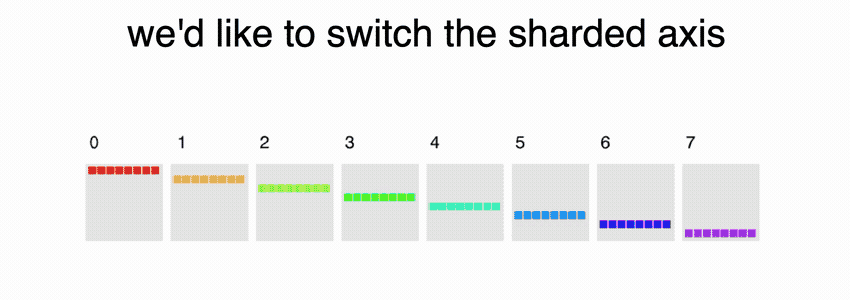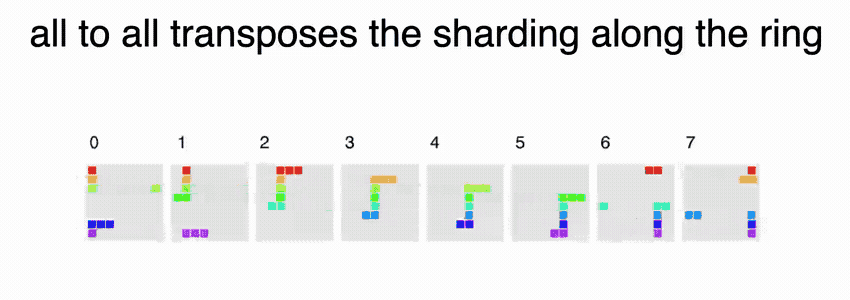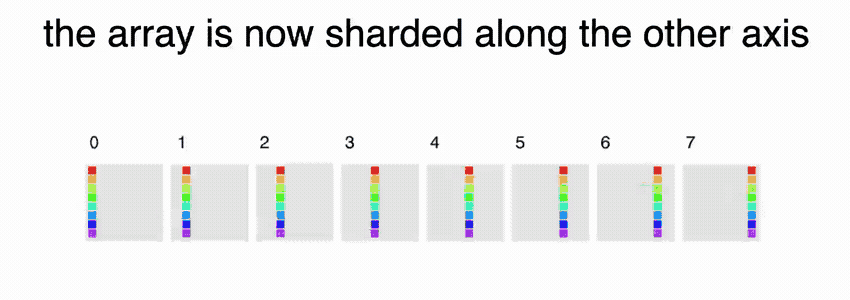
sharded 행렬 곱셈을 생각할 때 자연스럽게 나오지는 않지만 실전에서는 끊임없이 등장하는 마지막 기본 collective가 AllToAll이다. 정확히는 sharded 전치(transposition) 또는 resharding 연산이라는 특수한 경우다. 예:
AllToAll은 보통 호환되는 layout 체계를 갖지 않는 sharded 연산의 서로 다른 영역들 사이에서 sharded layout을 재배열하는 데 필요하다. sharded mixture-of-experts 모델을 생각할 때 자연스럽게 나타난다. AllToAll은 아래첨자를 한 axis에서 다른 axis로 옮기는 것이라고 생각하면 된다. AllToAll은 각 shard의 데이터 전부를 링 전체에 복제할 필요가 없기 때문에, 실제로는 AllGather보다 (¼배만큼) 싸다.5
ND AllToAll로 일반화하면, AxBxC mesh에서 (전 장치 합산) 총 바이트의 배열에 대한 전체 비용은
이다. 여기서 늘 그렇듯 는 양방향 ICI bandwidth이고 는 총 장치 수다. 장치당 바이트 로 표현하면 비용은 이다. 1D mesh에서는 이것이 로 줄어들어 AllGather 비용의 1/4이 된다. 2D에서는 비용이 실제로 가장 작은 axis의 크기에 비례해 더 줄어든다.
여담: 이 사실의 대략적인 유도가 궁금하다면 1D 토러스 에서 시작하자. 소스 노드와 타깃 노드를 무작위로 고르면 평균적으로 서로 N / 4 홉 떨어져 있으므로 비용은 이 된다. 이제 ND 토러스를 생각하면 각 axis는 기본적으로 독립이다. 각 노드는 의 바이트를 갖고 있고 평균적으로 데이터를 홉 옮겨야 한다. bisection bandwidth로도 유도할 수 있다: AllToAll에서 mesh의 각 절반은 자기 데이터의 절반( 바이트)을 반대쪽 절반으로 보낸다. 가장 좁은 bisection은 가장 긴 axis에 수직으로 자르며 개의 링크를 가로지르므로(wraparound까지 세면 절단면이 두 개다), 단방향 bandwidth는 이다. 나누면 위 공식이 나온다.
ReduceScatter 더 알아보기
ReduceScatter는 언뜻 보이는 것보다 더 근본적인 연산이다. 실제로 AllGather의 미분(derivative)이고, 그 역도 성립하기 때문이다. 즉 forward pass에서
라면, reverse-mode 미분값 A’(일반적으로 shard마다 서로 다르다)를 ReduceScatter해서 sharded **A’**를 얻는다:
마찬가지로 forward pass의 는 backward pass의 를 함의한다.
AllGather와 ReduceScatter가 서로의 미분인 이유 보기
이 성질은 broadcast와 reduction이 선형 연산자로서 서로의 전치(transpose)이고, AllGather와 ReduceScatter가 각각 broadcast와 reduce의 outer product(Kronecker product라고도 한다)라는 사실에서 나온다. 구체적으로, 벡터 과 임의의 장치 수 가 있고 라 하면, broadcast와 reduce를 다음과 같이 정의하자. 여러분의 직관적 이해와 일치할 것이다:
, 인 예에서 어떻게 되는지 보자. 이면 이다. 의 벡터를 으로 broadcast하는, 기대에 부합하는 결과다. 이제 라 하면 이다. 역시 의 벡터를 의 벡터로 reduce하는, 기대에 부합하는 결과다. 임의의 두 행렬 , 에 대해 이므로 임을 알 수 있다. AllGather와 ReduceScatter는 다음 outer product로 복원된다:
여기서 은 으로, 즉 개 장치 각각에 벡터 하나씩이라고 생각한다. , 같은 작은 예로 이 연산자들이 행렬로는 어떤 모습인지 직접 만져 보기를 권한다. 같은 전치 성질을 쓰면 다시 한 번 를 얻고, 물론 도 얻는다. 이 전치는 backpropagation에서 나타난다. AllGather나 ReduceScatter 같은 어떤 선형 연산자 에 대해 라면, backpropagation에서 우리는 손실의 에 대한 미분 를 갖게 되고, 로 를 얻기 때문이다. 이것이 AllGather의 미분이 ReduceScatter가 되고 그 역도 성립하는 이유다.
AllReduce를 AllGather와 ReduceScatter로 바꾸는 것에는, 마지막 AllGather를 나중 시점으로 미룰 수 있다는 편리한 성질도 있다. 전체 행렬 곱을 장치들에 복제된 형태로 재조립하는 비용을 치르고 싶지 않은 경우가 아주 흔하다. 그보다는, contracting 차원이 sharding된 두 피승수를 결합하는 이 경우에도 sharded 상태를 유지하고 싶다:
이 경우 AllReduce 대신 ReduceScatter를 수행하고, 원한다면 AllGather는 나중 어느 시점에 수행하면 된다. 즉:
ReduceScatter는 sharded 차원을 도입하므로, 이 경우 I든 K든 어느 이름 차원을 따라 shard할지에 대한 자연스러운 자유가 있다. ReduceScatter를 쓸 때는 새 sharding을 도입할 이름 차원을 일반적으로 골라야 한다(대개는 더 큰 모델링 맥락이 선택을 강제하지만). 그래서 shard할 axis를 지정하기 위해 ReduceScatterX,K 같은 문법을 쓴다.
matmul 통신을 연산과 겹치는 방법
1장에서 논의했듯, 통신이 충분히 빠르면 항상 어떤 유용한 연산과 겹칠 수 있다고 일반적으로 가정한다. 이 절의 collective들은 대체로 행렬 곱셈 연산 자체와 겹칠 수 있지만, 그렇게 하는 것이 간단하지는 않다. 우리가 쓰는 알고리즘은 collective matmul이라는 것으로, Wang et al.에서 처음 기술되었다. 이 겹침을 구현하는 방법을 단순화한 애니메이션은 다음과 같다:
간단히 말해, 행렬의 한 청크에 대한 matmul을 수행하는 동안 이전 청크들에 대한 링 reduction을 시작할 수 있다. 어떤 경우에는 batch 차원이나 행렬 입력 차원에 대해 타일링할 수도 있다. 10장에서 간단한 JAX 구현을 다루며, Mosaic 문서에도 GPU에서의 좋은 예시가 있다. 언젠가 직접 한 버전을 구현해 보기를 권한다.
무엇을 배웠는가?
-
배열의 sharding은 TPU mesh의 물리적 하드웨어 axis들에 이름을 붙이는 Mesh와, mesh axis 이름을 배열의 논리 axis에 배정하는 Sharding으로 명시된다.
- 예컨대 A[IXY, J]는 첫 번째 차원이 두 mesh axis X와 Y를 따라 sharding된 추상 배열 A를 기술한다. 이를 Mesh(mesh_shape=(4, 8), axis_names=(‘X’, ‘Y’)) — 축약형으로는 Mesh({‘X’: 4, ‘Y’: 8}) — 와 결합하면, 배열이 첫 번째 차원을 따라 32-way로 sharding되어 있음을 알 수 있다.
-
sharded 배열의 산술은, sharding된 axis를 따라 contraction을 수행하지 않는 한 unsharded 배열과 똑같이 작동한다. contraction이 있으면 통신을 도입해야 한다. 네 가지 경우를 고려한다:
- 어느 배열도 contracting 차원을 따라 sharding되지 않음: 통신이 필요 없다.
- 한 배열이 contracting 차원을 따라 sharding됨(또는 contracting 차원들이 서로 다른 axis를 따라 sharding됨): 연산을 수행하기 전에 입력 중 하나를 AllGather한다.
- 두 배열이 contracting 차원을 따라 동일하게 sharding됨: shard들을 로컬로 곱한 뒤 AllReduce 또는 ReduceScatter를 수행한다.
- 두 배열이 non-contracting 차원에서 같은 mesh axis를 따라 sharding됨: 먼저 입력 중 하나를 AllGather한다.
-
TPU는 대략 4개의 핵심 통신 primitive를 사용한다:
- AllGather:
- ReduceScatter:
- AllToAll:
- AllReduce: (ReduceScatter + AllGather를 조합한 것이므로 엄밀히는 primitive가 아니다)
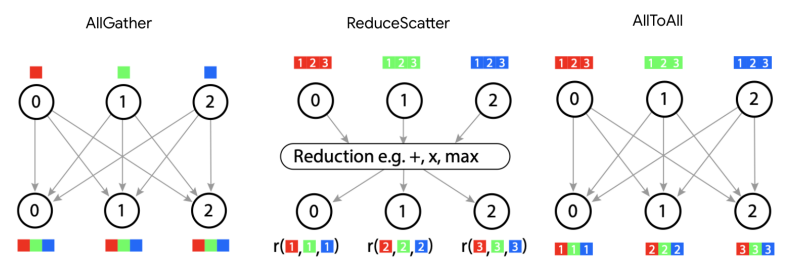
- 이 연산들 각각의 비용과 latency는 (bandwidth bound인 한) axis의 크기에 의존하지 않고, 입력 배열의 크기와 링크의 bandwidth에만 의존한다. 단방향 AllGather/ReduceScatter의 경우:
- AllReduce는 ReduceScatter 뒤에 AllGather가 이어지는 구성이므로 위 비용의 2배다. AllToAll은 shard들을 링의 일부만 돌리면 되므로 AllGather 비용의 ¼이다. 요약하면:
| 연산 | 설명 | 문법 | 실행 시간 |
|---|---|---|---|
| AllGather | sharding된 배열의 모든 shard를 한 axis를 따라 모아 아래첨자 하나를 제거한다. | bytes / (양방향 ICI bandwidth * num_axes) | |
| ReduceScatter | 부분 합산된 배열을 한 axis를 따라 합산하고 다른 axis를 따라 shard한다(아래첨자 추가). | AllGather와 동일 | |
| AllReduce | 부분 합산된 배열을 한 axis를 따라 합산한다. { Ux }를 제거한다. AllGather와 ReduceScatter를 합친 것이다. | 2 * AllGather | |
| AllToAll | 한 axis를 모으고(복제하고) 다른 차원을 같은 axis를 따라 shard한다. | 양방향 링에서 AllGather / 4 |
연습 문제
이 절의 내용에 기반한 학습용 문제들이다. 지금은 모든 답을 싣지 않았지만, 가능한 대로 더 많은 답을 적어 나가겠다.
문제 1 [복제된 sharding]: 배열이 로 sharding되어 있고(즉 에 대해서만 sharding), mesh는 Mesh({'X': 4, 'Y': 8, 'Z': 2})다. 가 전체 칩에 걸쳐 차지하는 총 바이트 수와 배열 복사본 하나의 크기의 비는 얼마인가?
정답 보기
배열은 크기 4인 X를 따라서만 sharding되어 있으므로, 각 shard는 사실상 크기가 이다. 배열이 Y와 Z에 걸쳐 복제되므로 총 크기는 이고, 따라서 총 크기 대 단일 칩 크기의 비는 이다.
문제 2 [AllGather latency]: mesh Mesh({'X': 4, 'Y': 4, 'Z': 4})인 TPU v4p 4x4x4 슬라이스에서 , 일 때 bfloat16으로 는 얼마나 걸려야 하는가? 는? 는?
정답 보기
완전한 4x4x4 큐브이므로 모든 axis에 wraparound 링크가 있고, 따라서 9e10의 양방향 bandwidth를 쓸 수 있다.
-
한 axis에 대해서만 gather하고 다른 axis는 sharding된 채이므로, 사실상 바이트를 1개 axis에 대해 gather하는 셈이다. Y-axis를 따라 shard 하나만 놓고 생각하면, X를 따라가는 AllGather는 바이트 수가 1 / Y인 unsharded AllGather처럼 보인다. TPU v4p의 ICI bandwidth는 양방향 9e10 bytes/second이므로 가 걸린다.
-
이전보다 bandwidth가 2배지만 전체 배열을 AllGather하므로
T = 2BD / (2 * W) = 2*1024*4096 / (2 * 9e10) = 46us다. latency 하한인 4us(홉당 1us)에서 멀리 떨어져 있으므로 괜찮다. -
AllReduce의 비용은 AllGather의 2배다. 각 shard는 크기가 이므로 비용은 약 , 대략
4 * 1024 * 4096 / (16 * 9e10) = 11.6us다.
재미있는 사실: 파트 (1)과 (2)는 사실 최적이 아니다. 배열이 쓰이지 않는 Z axis에도 복제되어 있어서 그 놀고 있는 링크들을 활용할 수 있기 때문이다. 먼저 로 공짜로 re-shard한 다음(각 장치가 자기 shard의 일부만 남기고 버리면 된다) (또는 )를 수행하면, 더 많은 axis에 걸쳐 gather하면서 같은 최종 상태에 도달한다. 이렇게 하면 파트 (1)은 11.5us, 파트 (2)는 31us로 줄어든다 — 실전에서는 처음부터 더 많은 axis에 걸쳐 sharding해 두는 식으로 이 이득을 얻는데, 이것이 배열을 가능한 한 잘게 shard해 둘 이유 중 하나다.
문제 3 [latency-bound AllGather]: 를 수행하는데 가 아주 작다고 하자(가령 128). mesh Mesh({'X': 4, 'Y': 4, 'Z': 4})인 TPU v4p 4x4x4 슬라이스에서 bfloat16으로 얼마나 걸리는가? 힌트: 아마 latency bound일 것이다.
정답 보기
bfloat16 배열은 총 256바이트만 쓰고 장치당으로는 64바이트뿐이다. TPU v4p에서 크기 4인 axis가 있으므로 wraparound 링크가 있고, 배열을 양방향으로 보낼 수 있다. 4.5e10의 단방향 bandwidth라면 각 홉은 대략 64 / 4.5e10 ~ 0이 걸리므로 확실히 latency bound다. 홉 수를 세어 보면 전체 gather를 단 2홉에 끝낼 수 있으므로, 대략 2us가 좋은 추정치다.
문제 4 [matmul 전략]: 를 수행할 때, 이 절에서는 를 하고 완전히 복제된 행렬들을 곱하라고 했다(Case 2, 전략 1). 그 대신 로컬 shard들을 처럼 곱한 다음(Case 3, 전략 2) 를 할 수도 있다. 각 전략은 FLOPs와 통신을 얼마나 수행하는가? 어느 쪽이 더 낫고 왜인가?
정답 보기
기준선(전략 1)부터 시작하자. 앞서 보였듯 AllGather의 비용은 이다. 완전히 복제된 배열을 얻고 나면 총 연산 시간은 다(여기서 는 가속기의 FLOPs/s — 각 TPU가 같은 FLOPs를 수행하므로). 따라서
이에 비해 새 전략(전략 2)은 바이트에 대한 AllReduce를 수행하며 그 비용은 지만, FLOPs는 (연산이 sharding되므로) 만큼으로 줄어든다. 즉 FLOPs를 수행하고, 이어지는 AllReduce는 bfloat16으로 바이트를 통신한다. 따라서 전략 2(AllGather 없이 나중에 AllReduce만)의 총 시간은 대략 다음과 같다:
문제는 이것이다: 둘 중 어느 쪽이 더 큰가? 전략 (2)는 일 때, 즉 일 때 compute bound다. 정도를 합리적으로 기대할 수 있으므로 이는 대략 를 뜻하는데 그럴 일은 별로 없다 — 전략 2에서는 기본적으로 항상 comms bound인 셈이다. 기준선(전략 1)에서는 일 때 comms bound인데, 이는 자주(항상은 아니지만) 참이다.
따라서 이면 두 경우 모두 comms-bound이고
이는 일 때 참이다(여기서 ). 이 조건은 자주 참이므로, batch가 작으면 전략 2가 때때로 더 나을 수 있다. batch가 클 때()는
이는 일 때, 즉 일 때 참인데, 큰 모델에서는 대개 참이다. 따라서 이 대안 전략은 가 작지 않은 한 큰 모델에서 일반적으로 더 낫다.
그런데 왜 항상 이렇게 하지 않을까? 실전에서 가끔은 이렇게 하기도 하지만, matmul의 한쪽 입력의 contracting 차원이, 다른 쪽 입력은 sharding되어 있지 않은 axis를 따라 sharding되어 있는 경우 자체가 보통 드물다. 예컨대 FSDP(5장에서 설명)를 한다면 파라미터를 data 차원에 걸쳐 shard하는데, activation 역시 data를 따라 sharding되어 있다. 그래서 이런 상황은 그다지 자주 나타나지 않는다.
문제 5 [최소 latency]: TPU v4p 4x4x4에서 가능한 한 낮은 latency로 matmul 를 하고 싶다고 하자. 입력은 임의로 shard할 수 있지만 결과는 완전히 복제되어야 한다. 입력을 어떻게 shard해야 하는가? 총 FLOPs와 통신 시간은 얼마인가?
정답(일부) 보기
여기서 완전한 답을 제공하지는 않겠지만, 가장 유력한 네 가지 선택지를 기술하는 데서 시작한다:
- + 마지막에 AG
- + 마지막에 AG
- + 마지막에 AR
- (완전 복제)
서로 다른 axis를 서로 다른 mesh axis를 따라 shard하는 것도 고려할 수 있지만, 최종 비용을 바꿀 가능성은 낮다. (4)를 제외한 모든 경우에 TPU당 총 FLOPs는 같지만 통신은 저마다 다르다. 그러면 각 경우의 통신 비용을 계산해 가장 낮은 것을 고르기만 하면 된다. TLDR은 (1)과 (2)가 똑같이 좋다는 것이다.
문제 6: TPU v5e 4x4에서 를 수행하고 싶다고 하자. 어떤 통신을 수행하는가? 통신과 연산에 각각 시간이 얼마나 쓰이는가?
- 는 어떤가? 이는 data, tensor, ZeRO sharding을 결합하는, 학습에서 가장 표준적인 설정이다.
- 는 어떤가? 순수 tensor parallelism(+data)을 쓰는, 추론의 표준 설정이다.
문제 7: 전형적인 Transformer 블록에는 두 행렬 와 가 있고 다. batch size가 B라고 하자. 그러면 전체 블록은 다. , , 로 잡고 모든 것이 bfloat16이라고 가정하자. TPU v5e 2x2 슬라이스에서 돌리되, 각 TPU에 여유 메모리가 300MB밖에 없다고 치자. 메모리 한도 아래로 유지하면서 전체 시간을 최소화하려면 In, , , Out을 어떻게 shard해야 하는가? 통신과 FLOPs에 시간이 각각 얼마나 쓰이는가? 힌트: 최종 출력이 완전히 복제될 필요는 없지만, “layer”를 반복할 수 있도록 입력과 같은 방식으로 sharding되어야 한다.
정답(일부) 보기
먼저 메모리를 생각해 보자. 두 개의 큰 행렬은 각각 2 * 8192 * 32768 = 536MB를 쓴다. activation In은 크기가 2 * 128 * 8192 = 2MB다(걱정할 필요가 없을 만큼 작다). 각 장치에 여유 메모리가 300MB뿐이므로 matmul을 shard해야 하는 것은 분명하다.
- (흔히 FSDP라 부른다)
- (tensor parallelism이라 부른다)
첫 번째는 큰 weight나 activation을 먼저 AllGather해야 하므로 꽤 나쁘다. 두 번째는 처음에 AllGather 하나와 끝에 ReduceScatter 하나가 필요하다(이는 AllReduce보다 싸다). 나머지 계산은 연습으로 남겨 둔다.
문제 8 [도전]: 위의 짧은 코드 스니펫을 템플릿 삼아, sharded 배열을 할당하고 pmap이나 shard_map으로 4개의 주요 통신 primitive(AllGather, AllReduce, ReduceScatter, AllToAll) 각각을 벤치마크하라. jax.lax.all_gather, jax.lax.psum, jax.lax.psum_scatter, jax.lax.all_to_all을 쓰게 될 것이다. 이 함수들의 의미론(semantics)을 이해했는가? 각각 얼마나 걸리는가?
문제 9 [sharded matmul의 또 다른 전략?]: 위 Case 2에서, matmul의 한쪽 입력만 contracting 차원을 따라 sharding되어 있을 때는 sharding된 행렬을 AllGather한 다음 그 contraction을 로컬로 수행해야 한다고 했다. 떠올릴 만한 또 다른 전략은, (두 입력 모두 contracting 차원을 따라 sharding된 것처럼) sharded matmul을 수행한 다음 결과를 AllReduce하는 것이다. 즉 를 다음 경로로 수행한다:
다음에 답하라:
- 이 알고리즘을 행렬 과 에 대해 명시적으로 적어라. 인덱스를 사용해 어느 장치에서 정확히 어떤 연산이 수행되는지 보여라. 는 ND개의 장치에 로 sharding되어 있고, 출력은 모든 장치에 복제되기를 원한다고 가정한다.
- 이제 최종 결과가 각 장치에 복제되지 않고 (N 또는 K 차원에 걸쳐) sharding되어도 괜찮다고 하자. 위 알고리즘은 어떻게 달라지는가?
- (1이 아니라 2에서의) 위 전략의 통신 비용만 놓고 보면, A를 먼저 AllGather한 다음 matmul하는 알고리즘의 통신 비용과 비교해 어떤가?
정답 보기
- 먼저 outer product들을 계산해 결과를 에 저장한다. 반복되는 인덱스가 contraction되는 인덱스가 아니라는 점에 주목하자 — outer product를 하고 있기 때문이다. 여기서 합은 우리가 쓰는 특정 장치에 저장된 i 값들의 집합에 대해 돈다. 예컨대 contracting axis의 크기가 16이고 장치가 4개라면, 장치 0에서 i는 {0, 1, 2, 3}, 장치 1에서는 {4, 5, 6, 7}, 장치 2에서는 {8, 9, 10, 11}, 장치 3에서는 {12, 13, 14, 15}를 돈다. 그런 다음 각 장치에 있는 의 partial sum들을 AllReduce해 완전한 를 만든다.
- 2단계에서 AllReduce 대신 더 싼 ReduceScatter로 끝낼 수 있다. 어느 axis로든 가능하다: 또는 .
- 본문에서 설명했듯 (throughput-bound일 때) AllGather의 비용은 ReduceScatter의 비용과 같다. 처리하는 전체 행렬의 크기로 정해질 뿐이다. 따라서 gather-후-matmul 알고리즘에서는 (를 하므로) 이것이 으로 스케일하고, matmul-후-reduce-scatter 알고리즘에서는 (를 reduce-scatter하므로) NK로 스케일한다. 두 알고리즘의 통신 비용의 비는
M/K다.
문제 10: AllToAll로 놀아 보기: 위 표에서 AllToAll의 수행 시간은 (throughput-bound 영역에서) AllGather나 ReduceScatter의 수행 시간보다 4배 낮다고 했다. 이 문제에서는 그 4배가 어디서 나오는지 보고, ICI 링크가 양방향이 아니라 단방향뿐이라면 이 배수가 어떻게 달라질지도 살펴본다.
- 단방향 경우부터 시작하자. D개의 장치가 링 토폴로지로 있고 N x N 행렬 에 대해 AllGather 또는 ReduceScatter를 하고 싶다(단순함을 위해 가 을 나눈다고 하자). 이 두 collective에 수반되는 통신을 기술하고, 이 알고리즘 전체 동안 단일 ICI 링크를 가로질러 전송되는 스칼라(float 또는 int)의 총 개수를 계산하라.
- 이제 AllToAll을 생각하자. 여전히 단방향 ICI 경우다. 이 경우 알고리즘은 all-gather 경우와 어떻게 다른가? 이 알고리즘에서 단일 ICI 링크를 가로질러 전송되는 스칼라 수를 계산하라.
- 파트 (a)와 (b)의 답의 비가 깔끔한 숫자로 나왔을 것이다. 이 배수가 어디서 나오는지 쉬운 말로 설명하라.
- 이제 양방향 통신을 추가하자. all-gather 경우의 총 소요 시간에 어떤 영향을 주는가?
- 양방향 통신 추가는 AllToAll 경우의 총 소요 시간에 어떤 영향을 주는가?
- 이제 양방향 링에서 AllGather 시간과 AllToAll 시간의 비를 간단히 설명하라.
정답 보기
(1) 풀이: 과정은 단순하다. 알고리즘의 각 단계에서 각 장치는 행렬의 single-shard “스트립”(총 개 원소 크기)을 가장 가까운 이웃에게 보낸다. 각 shard는 자기가 출발한 장치를 제외한 모든 장치로 전달되어야 하므로 이 일이 번 일어난다. 따라서 각 장치가 총 개의 스칼라를 전송하며, 단일 ICI 링크를 그만큼의 스칼라가 흐르는 셈이다.
답: , 이면 그냥 .
(2) 풀이: 통신 관점에서 AllToAll과 AllGather의 핵심 차이는, AllToAll에서는 특정 장치에 있는 shard 전체가 다른 모든 장치로 전달될 필요가 없다는 점이다. 특정 장치(장치 0이라 하자)에 저장된 shard가 라고 상상하자(여기서 A, B, C, D는 행렬이고, 그림을 위해 장치 4개짜리 링을 상상한다). 이제 행렬 는 어디로도 보낼 필요가 없고, 행렬 는 장치 1에, 행렬 는 장치 2에, 행렬 는 장치 3에 도착해야 한다. 알고리즘의 첫 단계에서 , , 를 장치 1로 보내고, 다음 단계에서 장치 1이 와 를 장치 2로 넘기고, 마지막 단계에서 장치 2가 만 장치 3으로 보낸다. 이 경우 전송되는 총 파라미터 수는 이다. A/B/C/D의 크기는 (이제 일반적인 경우로) 이고, 역시 일반적인 경우 항은 , 즉 가 된다. 따라서 단일 ICI 링크를 가로질러 전송되는 총 바이트 수는 이다.
답: , 이면 그냥 .
(3) 풀이: 배수는 그냥 이다. 즉 단방향 링 토폴로지에서 AllToAll은 all-gather/ReduceScatter의 절반 비용이다. 위 유도를 훑어 보면, 이는 궁극적으로 all-gather 경우에는 같은 크기의 블록을 번 전송하는 것 — 즉 라는 합 — 인 반면, AllToAll 경우에는 이라는 합을 하기 때문이다. 따라서 이 2배는 본질적으로 라는 사실에서 나온다.
(4) 풀이: 이제 양방향 링에서는 각 “sharded 스트립”을 동시에 두 방향으로 보낼 수 있으므로, 어느 한 링크가 날라야 하는 스칼라의 총수가 2배 줄어든다.
(5) 풀이: 이 경우 단방향 대비 4배를 번다. 이는 하나의 sharded 스트립 — 예컨대 장치 0에서 출발하는 스트립 — 안의 크기 (N2/D2)인 블록 각각의 운명을 생각해 보면 가장 쉽게 보인다. (단방향 경우처럼) 이 블록들 중 하나를 거리 D-1만큼, 다른 블록을 거리 D-2만큼, … 1까지 보내는 대신, 이제는 스트립을 오른쪽 또는 왼쪽으로 움직이는 블록들로 나누며 최대 이동 거리는 floor(D/2)다. 그래서 해당 합은 이제 , 큰 의 극한에서 이 된다. 단방향 경우의 와 비교하면 4배를 번 것이다.
(6) 풀이: 단방향 링에서는 AllToAll 시간이 이미 all-gather 시간보다 2배 빨랐다. 이는 전체 스트립을 모든 장치 하나하나에 보낼 필요가 없다는 사실에서 나온다. 그리고 양방향성을 추가했더니 AllToAll에는 4배 이득, all-gather에는 2배 이득이었다. 이 비들을 합치면 우리가 찾던 4배가 나온다.
3부는 여기까지! Transformer 수학을 다루는 4부는 여기에서 볼 수 있다.
Footnotes
-
속도를 위해 병렬화를 선택할 수도 있다는 점은 짚어 둘 만하다. 더 적은 수의 칩에 들어갈 수 있더라도 더 많은 칩으로 스케일하면 단순히 FLOPs/s가 그만큼 늘어난다. 예컨대 추론에서는 더 작은 토폴로지에 들어갈 수 있는데도 latency를 줄이기 위해 더 큰 토폴로지로 스케일하기도 한다. 마찬가지로 학습 중에는 step 시간을 줄이기 위해 더 많은 칩으로 스케일하는 경우가 많다. ↩
-
GPU의 AllGather도 이런 식으로 작동할 수 있다. 노드 안의 GPU들로 링을 만들고 그 (임의의) 순서로 청크를 돌리면 된다. ↩
-
분자의 2배는 양방향 bandwidth를 쓰고 있다는 데서 나온다. 각 방향으로 씩, 즉 총 를 보낸다. ↩
-
엄밀히는 이다. ↩
-
짝수 크기의 양방향 링에서 각 장치는 오른쪽으로 개, 왼쪽으로 개의 청크를 보내며, 합하면 이다. 각 청크(즉 shard의 shard)의 크기는 이므로 장치당 비용은 이다. 총 bandwidth가 장치 수에 비례해 늘어나므로 이 결과는 모든 장치에 걸쳐 그대로 스케일된다. ↩