JAX로 TPU를 효율적으로 프로그래밍하는 방법! 이 장의 상당 부분은 여기에서 가져왔다. 이 장의 코드 예제는 Google Colab의 무료 TPU에서 실행해 볼 수 있다.
JAX에서 병렬화는 어떻게 동작하는가?
JAX는 멀티 디바이스 프로그래밍에 대해 세 가지 사고방식을 지원한다:
- 컴파일러야, 운전대를 잡아라! XLA 컴파일러가 자동으로 배열을 분할하고, 주어진 프로그램이 돌아가도록 어떤 통신을 추가할지 결정하게 한다. 이렇게 하면 단일 디바이스에서 돌아가는 프로그램을 아무것도 바꾸지 않고 수천 개의 디바이스에서 자동으로 실행할 수 있다.
- JAX야, 운전대를 잡아라! 자동 병렬화는 훌륭하지만 가끔 컴파일러가 말도 안 되는 짓을 한다. Explicit sharding을 쓰면 평소처럼 단일 디바이스 코드를 작성하되, sharding 전파는 (컴파일러가 아니라) JAX가 처리한다. 덕분에 여러분이 뭘 원하는지 불분명할 때 JAX가 되물어 확인할 수 있다.
- 그냥 내가 뜻하는 대로 쓰게 해달라니까! 컴파일러는 좋지만 가끔 잘못된 일을 하고 의도하지 않은 통신을 추가한다. 실행하려는 통신을 정확히 명시하고 싶을 때도 있다.
| 모드 | 뷰 | 명시적 sharding? | 명시적 collective? |
|---|---|---|---|
| Auto | Global | ❌ | ❌ |
| Explicit | Global | ✅ | ❌ |
| Manual | Per-device | ✅ | ✅ |
이에 대응해 JAX는 각 모드를 위한 API를 제공한다:
jax.jit(Automesh axis 사용)을 쓰면 기존의 어떤 JAX 함수든 sharding된 입력으로 호출할 수 있다. 그러면 JAX는 XLA의 Shardy 컴파일러로 프로그램을 자동 병렬화한다. XLA는 기존 연산이 돌아가는 데 필요한 통신(AllGather, ReduceScatter, AllReduce 등)을 대신 추가해 준다. 완벽하지는 않지만 대개는 코드 수정 없이 프로그램을 임의 개수의 칩으로 스케일링하는 일을 꽤 괜찮게 해낸다.Explicitmesh axis를 쓰는jax.jit은 (1)과 비슷해 보이지만 sharding 전파를 XLA 대신 JAX가 처리한다. 배열의 sharding이 실제로 JAX 타입 시스템의 일부가 되고, JAX는 모호한 통신을 감지하면 에러를 내서 사용자가 이를 해소하게 한다.jax.shard_map은 더 수동적인 대응물이다. 프로그램의 디바이스-로컬 뷰를 얻고, 원하는 통신은 전부 직접 명시적으로 작성해야 한다. sharding된 배열이 있는데 각 디바이스에 전체가 필요한가?jax.lax.all_gather를 추가하라. 배열을 디바이스들에 걸쳐 합산하고 싶은가?jax.lax.psum(AllReduce)을 추가하라. 프로그래밍은 더 어렵지만 원하지 않는 일이 벌어질 가능성은 훨씬 낮다.
Auto sharding 모드
jax.jit은 JAX 안에서 두 가지 역할을 한다. 이름이 시사하듯 함수를 Python에서 바이트코드로 (XLA/HLO/LLO를 거쳐) “just-in-time” 컴파일해 더 빨리 실행되게 한다. 하지만 입력이 sharding되어 있거나 사용자가 in_sharding이나 out_sharding을 지정하면, XLA가 연산을 여러 디바이스에 분산하고 필요한 통신을 추가하게도 해 준다. 예를 들어 sharding된 matmul을 jax.jit으로 이렇게 쓸 수 있다:
import jax
import jax.numpy as jnp

Auto = jax.sharding.AxisType.Auto

# This creates a fake set of 8 CPU devices so you can run this on a CPU without TPUs.
jax.config.update("jax_num_cpu_devices", 8)

# This creates a 2D 4x2 mesh with axis names X and Y that JAX uses by default.
# We explicitly tell JAX to let the XLA compiler infer sharding along these axes.
mesh = jax.make_mesh(axis_shapes=(4, 2), axis_names=('X', 'Y'), axis_types=(Auto, Auto))
jax.set_mesh(mesh)

# We create a matrix W and input activations In sharded across our devices.
In = jnp.zeros((8, 2048), dtype=jnp.bfloat16, device=jax.NamedSharding(mesh, jax.P('X', 'Y')))
W = jnp.zeros((2048, 8192), dtype=jnp.bfloat16, device=jax.NamedSharding(mesh, jax.P('Y', None)))

def matmul_square(In, W):
  return jnp.einsum('bd,df->bf', jnp.square(In), W)

# We can explicitly compile the sharded matmul function here. This adds all the
# necessary comms (e.g. an AllReduce after the matmul).
jit_matmul = jax.jit(matmul_square, out_shardings=jax.P('X', None)).lower(In, W).compile()

out = jit_matmul(In, W)
이 코드는 어떤 sharding으로도 자동으로 실행되며 연산을 디바이스들에 분할한다. 그런데 하드웨어 수준에서는 실제로 무슨 일이 일어나는가?
- 먼저 In과 W를 디바이스들에 걸쳐 sharding된 상태로 생성한다1. W는 contracting 차원을 따라 2-way로 sharding되고, In은 8-way로 — 입력 차원을 따라 4-way, contracting 차원을 따라 2-way로 — sharding된다. W[DY, F], In[BX, DY]라는 sharding에 해당하며, 일종의 model parallelism + data parallelism이다.
- 로컬에서(즉 한 디바이스에서) 실행했다면
matmul_square는 그냥 입력을 제곱하고 단순한 matmul을 수행했을 것이다. 하지만out_shardings를P('X', None)으로 지정했기 때문에, 출력은 batch를 따라 sharding되되 모델 차원에 대해서는 복제(replicate)되어야 하고, 이를 계산하려면 AllReduce가 필요하다.
이전 장들의 표기를 쓰면 아마 다음과 같은 일이 일어날 것이다:
- Out[BX, F] { UY } = In[BX, DY] *D W[DY, F]
- Out[BX, F] = AllReduce(Out[BX, F] { UY })
jax.jit이 이걸 자동으로 추가해 준다! jit_matmul.as_text()로 HLO를 실제로 출력해 보면 (대폭 축약해서) 다음과 같은 HLO가 나온다:
# This fusion is the actual matmul of the sharded inputs and matrix
%fusion = bf16[2,8192]{1,0:T(4,128)(2,1)S(1)} fusion(bf16[2,1024]{1,0:T(4,128)(2,1)} %param, bf16[8192,1024]{1,0:T(8,128)(2,1)S(1)} %copy-done)

# We reduce the partially summed results across devices
ROOT %AllReduce = bf16[2,8192]{1,0:T(4,128)(2,1)} AllReduce(bf16[2,8192]{1,0:T(4,128)(2,1)S(1)} %fusion)
위에서 matmul(fusion)과 AllReduce가 보인다. shape에 특히 주목하라. bf16[2, 1024]는 activation의 로컬 뷰다. batch_size=8이 4개 디바이스에 나뉘고 d_model=2048도 마찬가지로 2-way로 나뉘기 때문이다.
이건 꽤 마법 같다! 프로그램이 아무리 복잡해도 Shardy와 jit은 모든 중간 activation의 sharding을 찾아내고 필요한 통신을 추가하려고 시도한다. 그렇긴 해도 Shardy에는 결함이 있다. 실수를 하기도 한다. 프로파일을 보다가 뭔가 잘못됐다는 걸 알아차릴 때가 있다. 굳이 필요하지도 않은 거대한 AllGather가 프로파일의 80%를 차지하는 식이다. 이럴 때는 jax.lax.with_sharding_constraint로 중간 텐서에 명시적으로 주석을 달아 컴파일러를 교정해 볼 수 있다. 예컨대 matmul이 두 개일 때, 다음과 같이 중간 activation이 y 차원을 따라 sharding되도록 강제하면 된다(이게 좋은 생각이라는 건 아니다):
import jax
import jax.numpy as jnp

Auto = jax.sharding.AxisType.Auto

mesh = jax.make_mesh((4, 2), ('X', 'Y'), (Auto, Auto))
jax.set_mesh(mesh)

def matmul(x, W_in, W_out):
  hidden = jnp.einsum('bd,df->bf', x, W_in)
  hidden = jax.lax.with_sharding_constraint(hidden, jax.P('X', 'Y'))
  return jnp.einsum('bf,df->bd', hidden, W_out)
자동 분할의 세계에서 JAX 병렬 프로그래밍의 약 60%는 이렇게 jax.lax.with_sharding_constraint로 중간 sharding을 제어하는 일이다. 하지만 “컴파일러 간질이기(compiler tickling)“는 즐거운 프로그래밍 모델이 아니기로 악명 높다. 모든 중간 변수에 주석을 달아도 올바른 결과가 나올지 여전히 알 수 없다. 그 대신, JAX 자체가 sharding 전파를 다루고 제어할 수 있다면 어떨까?
Explicit sharding 모드
Explicit sharding(또는 “sharding in types”)은 automatic sharding과 아주 비슷해 보이지만 sharding 전파가 JAX 수준에서 일어난다! 각 JAX 연산에는 인자들의 sharding으로부터 결과의 sharding을 만들어내는 sharding 규칙이 있다. 결과 sharding은 jax.typeof로 확인할 수 있다:
import jax
import jax.numpy as jnp
import numpy as np

Explicit = jax.sharding.AxisType.Explicit

# Running on a TPU v5e 2x2. This assigns names to the two physical axes of the hardware.
mesh = jax.make_mesh(axis_shapes=(2, 2), axis_names=('X', 'Y'), axis_types=(Explicit, Explicit))

# This tells JAX to use this mesh for all operations, so you can just specify the PartitionSpec P.
jax.set_mesh(mesh)

x = jax.device_put(np.arange(16, dtype=np.float32).reshape(8, 2), jax.P('X', 'Y'))

@jax.jit
def f(x):
  print(jax.typeof(x))  # float32[8@X,2@Y]
  out = x * 2
  print(jax.typeof(out))  # float32[8@X,2@Y]
  return out

f(x)
보다시피 JAX가 입력(x)의 sharding을 출력(out)으로 전파했고, trace 시점에 jax.typeof로 들여다볼 수 있다. 대부분의 연산에서는 합리적인 선택지가 하나뿐이어서 이 규칙이 단순하고 자명하다(예: elementwise 연산은 같은 sharding을 유지한다). 하지만 어떤 연산들은 결과를 어떻게 shard할지 모호한데, 이 경우 JAX는 trace 시점 에러를 던지며 프로그래머에게 out_sharding 인자를 명시적으로 제공하라고 요구한다(예: jnp.einsum, jnp.reshape 등). 충돌이 있는 다른 예를 보자:
# We create a matrix W and input activations In sharded across our devices.
In = jnp.zeros((8, 2048), dtype=jnp.bfloat16, out_sharding=jax.P('X', 'Y'))
W = jnp.zeros((2048, 8192), dtype=jnp.bfloat16, out_sharding=jax.P('Y', None))

@jax.jit
def matmul_square(In, W):
  print(jax.typeof(In))  # bfloat16[8@X, 2048@Y]
  print(jax.typeof(W))  # bfloat16[2048@Y, 8192]
  return jnp.einsum('bd,df->bf', jnp.square(In), W)

matmul_square(In, W)  # This will error
이 코드는 다음 에러를 내며 실패한다:
Contracting dimensions are sharded and it is ambiguous how the output should be sharded.
Please specify the output sharding via the `out_sharding` parameter.
Got lhs_contracting_spec=('Y',) and rhs_contracting_spec=('Y',)
einsum의 출력을 어떻게 shard해야 하는지가 실제로 모호하니, 이 에러는 아주 좋은 일이다. 출력 sharding은:
- P(‘X’, ‘Y’)일 수 있고 — 이 경우 ReduceScatter가 유발된다 — 또는
- P(‘X’, None)일 수도 있다 — 이 경우 AllReduce가 유발된다.
Auto 모드와 달리 explicit 모드는 모호한 통신을 감지하면 에러를 내고 사용자가 이를 해소하도록 요구한다. 그래서 여기서는 이렇게 하면 된다:
@jax.jit
def matmul_square(In, W):
  return jnp.einsum('bd,df->bf', jnp.square(In), W, out_sharding=jax.P('X', 'Y'))

out = matmul_square(In, W)
print(jax.typeof(out))  # bfloat16[8@X,8192@Y]
Auto 모드와 Explicit 모드는 jax.sharding.auto_axes와 jax.sharding.explicit_axes API로 조합할 수 있다. 더 자세한 내용은 이 문서를 읽어 보면 좋다.
shard_map을 이용한 manual sharding 모드
Shardy가 “컴파일러야, 운전대를 잡아라” 모드라면, jax shard_map은 모든 것을 여러분 손에 맡긴다. jax.jit에서처럼 입력의 sharding을 지정하되, 그다음부터는 모든 통신을 직접 명시적으로 작성한다. jax.jit이 프로그램의 전역적인 cross-device 뷰를 주는 반면, shard_map은 디바이스별 로컬 뷰를 준다.
예제를 하나 보자. 이 함수가 무엇을 하는지 추론해 보라:2
import jax
import jax.numpy as jnp

Explicit = jax.sharding.AxisType.Explicit

mesh = jax.make_mesh((2, 4), ('x', 'y'), (Explicit, Explicit))
jax.set_mesh(mesh)

x = jnp.arange(0, 512, dtype=jnp.int32, out_sharding=jax.P(('x', 'y')))

# This function will operate on 1/8th of the array.
@jax.shard_map(in_specs=jax.P(('x', 'y')), out_specs=jax.P())
def slice_and_average(x):
  assert x.shape == (512 // 8,)
  return jax.lax.pmean(x[:4], axis_name=('x', 'y'))

out = slice_and_average(x)
assert out.shape == (4,)
이 코드는 무엇을 하는가? slice_and_average는 각 TPU에서 배열의 1/8을 가지고 실행되며, 거기서 앞의 4개 원소를 잘라내 전체 mesh에 걸쳐 평균을 낸다. 사실상 mean(x[:4], x[64:68], x[128:132], …)을 계산하는 셈이다. JAX에서 달리 표현하기 쉽지 않은 연산이니 꽤 멋진 일이다.
jax.jit 대신 왜 이렇게 하는가? jax.jit을 썼다면 slice_and_average는 배열의 전역 뷰(전체 [512,] 배열)를 봤을 것이다. 이 비균일한 slice를 잘라낸 다음 평균을 내야 했을 테고, XLA가 그걸 올바르게 해석해 줘야 했을 것이다. XLA가 잘못된 통신을 추가하거나 혼란에 빠졌을 수도 있다. 여기서는 로컬 뷰를 보면서 필요한 통신만 작성한다.
예시 [Collective Matmul]: 더 현실적인 예로, activation이 처음부터 model sharded인 model parallelism을 구현하고 싶다고 하자. 즉 A[BX, DY] *D W[D, FY] -> Out[BX, FY]이다. 순진하게는 A를 먼저 AllGather한 다음 로컬 행렬 곱셈을 하면 된다:
- A[BX, D] = AllGatherY(A[BX, DY])
- Out[BX, FY] = A[BX, D] *D W[D, FY]
안타깝게도 이 방식은 통신을 연산과 겹칠(overlap) 수 없어서 나쁘다. 둘을 겹치는 것은 Wang et al. 2023에 기술된 “collective matmul”로 할 수 있다. 알고리즘은 기본적으로 다음과 같다:
- 각 Y shard에 대해, A의 로컬 청크와 W의 로컬 청크를 matmul해
[B / X, F / Y]shape의 결과를 만든다. 동시에 A를 permute해서 다음 청크가 로컬로 오게 하고, matmul을 수행하고, 결과를 합산한다.
이건 jax.shard_map으로 꽤 쉽게 구현할 수 있다:
import functools

import jax
import jax.numpy as jnp
import numpy as np

Explicit = jax.sharding.AxisType.Explicit

# This is intended to run on a TPU v5e-8 runtime. If you can't get this,
# try setting jax.config.update('jax_num_cpu_devices', 8).
#
mesh = jax.make_mesh(axis_shapes=(2, 4), axis_names=('X', 'Y'), axis_types=(Explicit, Explicit))
jax.set_mesh(mesh)

B, D, F = 1024, 2048, 8192
A = jnp.arange(np.prod((B, D))).reshape((B, D))
W = jnp.arange(np.prod((D, F))).reshape((D, F))

A = jax.device_put(A, jax.P('X', 'Y'))
W = jax.device_put(W, jax.P(None, 'Y'))

@functools.partial(jax.jit, out_shardings=jax.P('X', 'Y'))
def matmul(lhs, rhs):
  return lhs @ rhs

def collective_matmul_allgather_lhs_contracting(lhs, rhs):
  # lhs is the looped operand; rhs is the local operand
  axis_size = jax.lax.axis_size('Y')  # axis_size = 4 for this example
  idx = jax.lax.axis_index('Y')

  chunk_size = lhs.shape[1]
  assert rhs.shape[0] % chunk_size == 0

  def f(i, carrys):
    accum, lhs = carrys
    rhs_chunk = jax.lax.dynamic_slice_in_dim(rhs, (idx + i) % axis_size * chunk_size, chunk_size)
    # Matmul for a chunk
    update = lhs @ rhs_chunk
    # Circular shift to the left
    lhs = jax.lax.ppermute(
        lhs,
        axis_name='Y',
        perm=[(j, (j - 1) % axis_size) for j in range(axis_size)]
    )
    return accum + update, lhs

  accum = jnp.zeros((lhs.shape[0], rhs.shape[1]), dtype=lhs.dtype)
  accum = jax.lax.pcast(accum, ('X', 'Y'), to='varying')
  accum, lhs = jax.lax.fori_loop(0, axis_size - 1, f, (accum, lhs), unroll=True)

  # Compute the last chunk after the final permute to leave lhs in the state we found it
  i = axis_size - 1
  rhs_chunk = jax.lax.dynamic_slice_in_dim(rhs, (idx + i) % axis_size * chunk_size, chunk_size)
  update = lhs @ rhs_chunk
  return accum + update

jit_sharded_f = jax.jit(jax.shard_map(
  collective_matmul_allgather_lhs_contracting,
  in_specs=(jax.P('X', 'Y'), jax.P(None, 'Y')), out_specs=jax.P('X', 'Y')))

shmapped_out = jit_sharded_f(A, W)
expected_out = matmul(A, W)

np.testing.assert_array_equal(shmapped_out, expected_out)
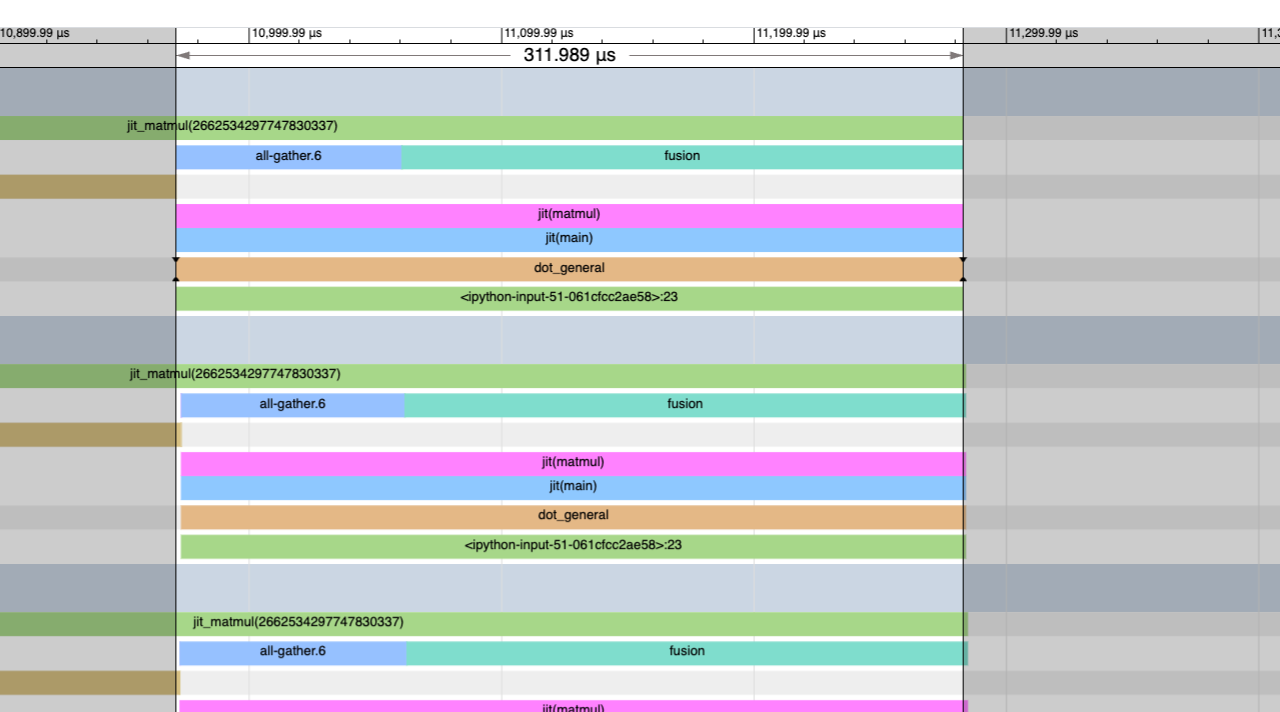
이거 꽤 깔끔하다! 벤치마크해 보면 이 버전이 훨씬 빠르기까지 하다! 여기는 기본 jit matmul의 프로파일인데, 시작 부분의 커다란 blocking AllGather 때문에 311us가 걸린다:
그리고 여기는 위의 버전으로, 244us가 걸린다. 프로파일에 AllGather가 보이지 않는다. 전부 알짜 작업이다! FLOPs 활용률도 훨씬 높다.
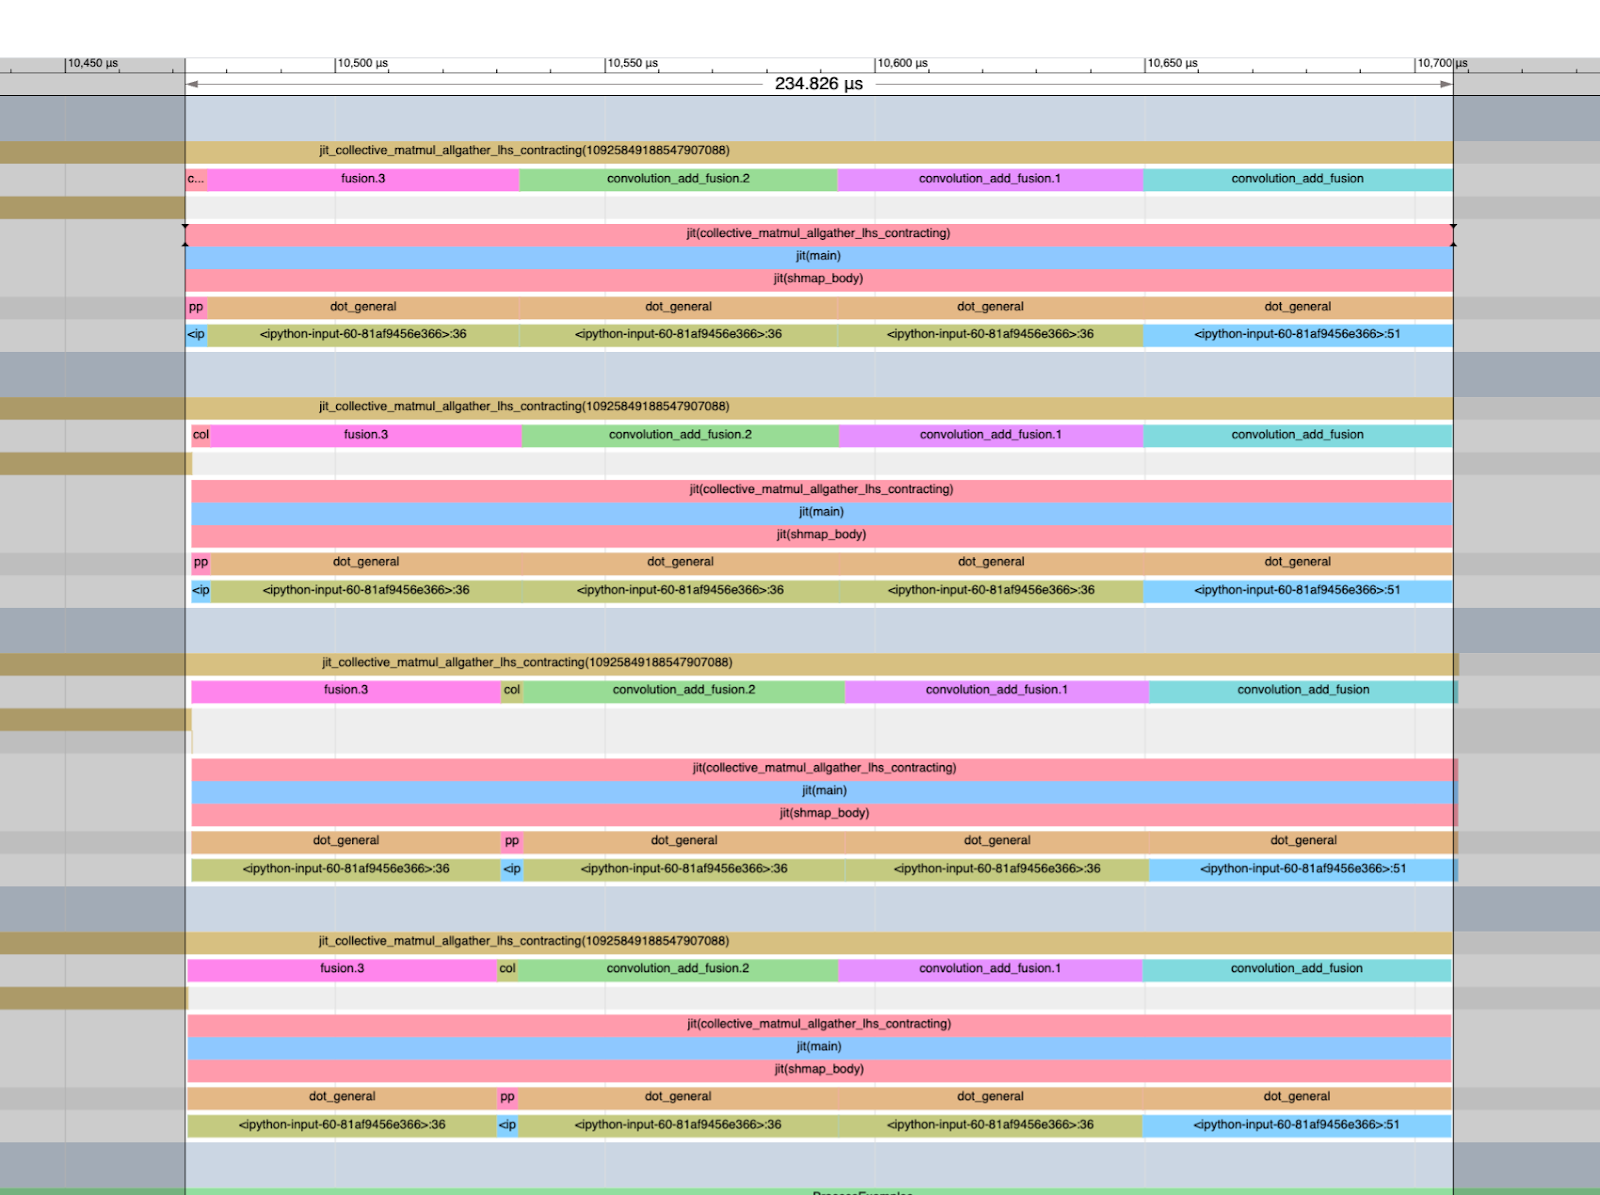
contracting 차원에 sharding이 없을 때의 matmul 시간이 224us라는 점도 짚어 둘 만하다. 여기서 우리는 unsharded 기준선에 놀랄 만큼 가까이 와 있다. TPU 활용률을 높이기 위해 여러분이 하게 될 법한 성능 엔지니어링의 좋은 예다. 더 많은 shard_map 예제는 이 노트가 훌륭하다.
이제 jax.jit이나 shard_map으로 직접 구현해 볼 만한 유용한 연습 문제 몇 개를 소개한다!
연습 문제
여기 JAX 관련 문제 몇 개가 있다. 나중에 더 추가하겠다. 이 문제들 전부에는 어느 정도 개수의 TPU가 필요하다. Colab은 더 이상 TPU v2-8 slice를 제공하지 않으므로, (아직 무료로 제공하는) Kaggle이나 8코어 GCP slice를 사용하라.3 이제부터는 N개의 디바이스가 있다고 가정한다.
문제 1: A를 shape float32[SX, DY]의 activation 배열이라 하고, X * Y = N이라 하자. 다음을 해 보라:
-
각
(X, Y)shard 내부의 평균을 계산하는 JAX 함수를 작성하라. 즉arr[i, j]가 shard(i, j)의 평균인 [X, Y] 크기의 배열을 반환한다.jax.jit과shard_map두 가지 방식 모두로 해 보라. 각각 프로파일해서 얼마나 걸렸는지 확인하라. 통신이 추가되었는가? 힌트: 추가되지 않아야 정상이지만 가끔 XLA가 그래도 추가한다. -
어떤 shift에 대해 X를 따라 각 shard 내부에서
roll(x, shift, axis=0) - x를 반환하는 JAX 함수를 작성하라. 이걸 jax.jit으로 시킬 만큼 내가 가학적이지는 않으니,shard_map으로만 하면 된다.
정답 보기
Part 1: 다음은 part 1의 한 가지 풀이다. jax.jit 풀이에서 해야 하는 꽤 복잡한 reshape들에 주목하라.
import numpy as np

import jax
import jax.numpy as jnp

Auto = jax.sharding.AxisType.Auto

mesh = jax.make_mesh((4, 2), ('X','Y'), (Auto, Auto))

average_shmap = jax.shard_map(
    lambda x: x.mean(keepdims=True),
    mesh=mesh,
    in_specs=jax.P('X','Y'), out_specs=jax.P('X','Y')
)

def average(x):
  X, Y = mesh.axis_sizes
  return x.reshape(X, x.shape[0] // X, Y, x.shape[1] // Y).mean(axis=(1, 3))

average_jit = jax.jit(average, out_shardings=jax.NamedSharding(mesh, jax.P('X','Y')))

x = jnp.arange(8 * 64 * 8, dtype=jnp.float32).reshape(8 * 64, 8)
x = jax.device_put(x, jax.NamedSharding(mesh, jax.P('X','Y')))

y1 = average_shmap(x)
y2 = average_jit(x)

np.testing.assert_array_equal(y1, y2)
Part 2: 다음은 Part 2에 대한 비슷한 풀이다.
import numpy as np

import jax
import jax.numpy as jnp

import functools

Auto = jax.sharding.AxisType.Auto

mesh = jax.make_mesh((4, 2), ('X','Y'), (Auto, Auto))

def shift_shmap(x, shift: int):
  shmapped = jax.shard_map(
      lambda x: jnp.roll(x, shift, axis=0),
      mesh=mesh,
      in_specs=jax.P('X','Y'), out_specs=jax.P('X','Y')
  )
  return shmapped(x)

@functools.partial(jax.jit, static_argnames=['shift'], out_shardings=jax.NamedSharding(mesh, jax.P('X','Y')))
def shift_jit(x, shift: int):
  X, Y = mesh.axis_sizes
  reshaped = x.reshape(X, x.shape[0] // X, -1)
  return jnp.roll(reshaped, shift, axis=1).reshape(x.shape[0], x.shape[1])

x = jnp.arange(8 * 64 * 8, dtype=jnp.float32).reshape(8 * 64, 8)
x = jax.device_put(x, jax.NamedSharding(mesh, jax.P('X','Y')))

y1 = shift_shmap(x, 5)
y2 = shift_jit(x, 5)

np.testing.assert_array_equal(y1, y2)
문제 2: 여기서는 기본적인 “mixture of experts” 모델을 함께 만들어 본다. W: float32[EX, D, F]를 E개의 “expert” 행렬 집합이라 하자. A: float32[SX, D]를 activation이라 하고, B: int32[SX]를 “라우팅 할당(routing assignments)“의 집합이라 하자. B[i]는 [0, E) 범위의 정수로, 그 activation을 어떤 행렬로 처리할지 알려 준다. Out[i] = A[i] @ W[B[i]]를 반환하는 JAX 함수를 작성하려 한다.
-
우선 sharding을 아예 무시하는 것부터 시작하자. 이 텐서들을 전부 한 디바이스에 들어갈 만큼 작게 만들어라. 이 함수의 로컬 구현을 작성하라.
[S, D, F]shape의 배열을 실체화(materialize)하지 않도록 주의하라! 힌트: 마스킹에 신경 쓰면서 토큰들을[E, S, D]shape의 새 버퍼로 정렬해 보라(왜 두 번째 차원의 크기가 S여야 할까?). -
위 방법을 그냥
jax.jit하면 뭔가 일이 일어나긴 할 것이다. 프로파일해서 XLA가 어떤 통신을 하기로 결정했는지 보라. 얼마나 걸리는가? -
위 구현에서 눈에 띄는 문제 하나는, 아마 전체 activation A를 로컬로 gather한다는 것이다. 즉 AllGatherX([SX, D])다. 통신 면에서 비쌀 뿐 아니라, 전체 activation을 로컬에 담을 수 없다면 메모리 면에서도 엄청나게 비싸다. 위를
shard_map과 명시적 통신으로 구현하라.-
첫 번째 패스에서는
jax.lax.all_gather를 쓰고 step 1처럼 재정렬하는 것이 가장 쉬울 것이다. -
두 번째 패스에서는
[E, S, D]크기의 배열을 실체화하지 않도록 해 보라. 즉jax.lax.while_loop안에서jax.lax.all_to_all을 써서 연산을 ragged하게 수행해 보라. 이렇게 하면 전체 activation을 실체화하는 것도, padding에 연산을 낭비하는 것도 피할 수 있다. 원래 구현보다 얼마나 빠른가?
-
-
대부분의 MoE는 여러(k개) expert로 라우팅한 뒤 결과를 평균한다. 이를 구현하도록 위 코드를 리팩토링하라. 이 경우 라우팅할 k개의 expert를 위해 B: int32[SX, k]라 하자.
정답 보기 (부분)
1/2. part (1)에는 선택지가 많다. 다음은 마스킹을 써서 expert들을 그냥 순회하는 한 가지 방법이다.
def moe_local(W: jnp.ndarray, A: jnp.ndarray, B: jnp.ndarray) -> jnp.ndarray:
    S, _ = A.shape
    E, _, F = W.shape

    def expert_forward(carry, e):
        output = carry  # [S, F]
        mask = (B == e)[:, None]  # [S, 1]
        expert_result = A @ W[e]  # [S, F] - this expert's transform of ALL tokens
        output = output + expert_result * mask  # Only keep results for assigned tokens
        return output, None

    output = jnp.zeros((S, F))
    output, _ = jax.lax.scan(expert_forward, output, jnp.arange(E))

return outputjax.lax.ragged_dot을 쓸 수도 있는데, 비슷한 일을 더 효율적으로 해 준다.
- 여기서는 의사코드만 스케치하겠다(깔끔한 풀이가 있다면 자유롭게 추가해 달라):
chunk_size = 128
def matmul(W, x, B):
  i = 0
  x = # sort x according to assignments
  while (chunk := x[i:i+chunk_size]).any():
     chunk = all_to_all(chunk)
     out = matmul_local(W, chunk)
     i += chunk_size
  return concat(out)
기본 아이디어는 배열의 청크들을 순회하면서, 정렬하고 all_to_all을 한 다음, 로컬 FLOPs를 수행하는 것이다.
문제 3: 위의 collective matmul 예제는 실제 LLM에 정말로 아주 유의미하다. 예제를 변형해 전체 Transformer 스택을 만들어 보자.
-
연습으로, 우선 AllReduce collective matmul, 즉 A[BX, DY] *D W[DY, F] -> Out[BX, F]를 구현하는 것부터 시작하자. 출력이 replicate되지 않는다는 점에 유의하라. 순진한 알고리즘은 위에서 논의했다 — 기본적으로 로컬 matmul 뒤에 AllReduce를 붙이는 것이다. 이 연산의 통신이 겹쳐진 “collective” 버전을 만들어 보라. 힌트: 출력 차원을 따라 타일링하고,
jax.lax.psum(AllReduce)을 자유롭게 사용하라. 참고: XLA가 이를 처리하는 방식 때문에, 실제로는 기준선보다 빠르지 않을 수도 있다. -
위 AllReduce collective matmul의 대응물은 ReduceScatter collective matmul이다. Tmp[BX, FY] *F W2[FY, D] -> Out[BX, DY]처럼 말이다. Transformer의 down-projection 행렬에서 발생한다. 이것의 collective, 즉 통신이 겹쳐진 버전을 JAX로 구현하라. 필요한 최소한의 데이터만 전달하도록 주의하라. 힌트: 결과를 누적하면서 permute해 보라.
-
이 둘을 합쳐, In[BX, DY] *D Win[D, FY] *F Wout[FY, D] -> Out[BX, DY]를 통신이 겹쳐진 상태로 수행하는 end-to-end Transformer 블록을 만들어라.4
jax.jit구현보다 얼마나 빠른가?
문제 4: 위에서 구현한 collective matmul은 전부 단방향이다. 한 방향으로만 permute한다. collective AllReduce matmul과 collective ReduceScatter matmul을 양방향 통신을 쓰도록 다시 작성하라. 얼마나 더 빨라지는가?
10부는 여기까지! 사실상 책의 본문도 여기서 끝이다! 최종 결론과 더 읽을거리는 여기에서 볼 수 있다.
Footnotes
-
우리가 이걸 어떻게 했는지 눈여겨보라. 특정 sharding을 가진 배열을 만드는 한 가지 방법이다(즉 생성 함수에 device 인자를 추가하는 것). 다른 방법은
jnp.array(....)로 배열을 평범하게 만든 뒤 예컨대jax.device_put(..., jax.P('X', 'Y'))를 하는 것이다. 또 다른 방법은 원하는 배열을 생성하는 함수를 작성해 두고,out_shardings를 원하는 값으로 지정해서 jit 컴파일하는 것이다. ↩ -
mesh를 에뮬레이션해서 colab에서 직접 갖고 놀고 싶다면, 다음 셀을 사용하면 된다:
import jax; jax.config.update('jax_num_cpu_devices', 8)↩ -
가짜 문제로 mesh를 에뮬레이션만 하고 싶다면,
import jax; jax.config.update('jax_num_cpu_devices', 8)로 CPU에서 8개의 가짜 디바이스를 만들 수도 있다(jax >= 0.4.27 언저리가 필요하다). 다만 실제 성능을 반영하지 않는다. ↩ -
이전과 마찬가지로, 여기서는 생략한 비선형성 때문에 을 먼저 계산할 수는 없다. ↩