지금까지 이 시리즈는 전적으로 이론이었다: 하드웨어 roofline에 기반한 어림 계산. 그 이해만으로도 꽤 멀리 갈 수 있지만, 최적화의 많은 부분은 실전적인 세부 사항에 달려 있다: XLA 컴파일러가 어떻게 동작하는지, 그리고 컴파일러가 제대로 해내지 못할 때 무엇을 해야 할지 알아내기 위해 JAX/TensorBoard Profiler 같은 profiling 도구를 어떻게 쓰는지. 여기서 그것을 다룬다.
TPU 소프트웨어 스택 조감도
Google은 TPU 프로그래밍을 위해 고수준 JAX 코드부터 저수준 Pallas나 HLO까지 다양한 API를 제공한다. 대부분의 프로그래머는 JAX 코드만 작성하는데, 추상적인 NumPy 스타일의 선형대수 프로그램을 쓰면 TPU에서 효율적으로 돌아가도록 자동으로 컴파일된다.
간단한 예로, 두 행렬을 곱하는 JAX 프로그램을 보자:
import jax
import jax.numpy as jnp

def multiply(x, y):
  return jnp.einsum('bf,fd->db', x, y)

y = jax.jit(multiply)(jnp.ones((128, 256)), jnp.ones((256, 16), dtype=jnp.bfloat16))jax.jit을 호출하면 JAX는 이 함수를 trace해서 StableHLO라는 더 낮은 수준의 IR을 내놓는다. StableHLO는 ML 연산을 위한 플랫폼 독립적 IR로, 다시 XLA 컴파일러에 의해 HLO로 lower된다. 컴파일러는 여러 pass를 돌려 fusion, layout 등 여러 요소를 결정하고, 그 결과가 JAX profile에서 관찰할 수 있는 HLO다. 이 HLO는 JAX 코드의 핵심 선형대수 연산 전부(matmul, pointwise op, convolution 등)를 LLVM 스타일의 그래프 형태로 표현한다. 예를 들어 위 프로그램을 HLO로 나타낸 축약본은 다음과 같다1:
ENTRY %main.5 (Arg_0.1: f32[128,256], Arg_1.2: bf16[256,16]) -> f32[16,128] {
  %Arg_1.2 = bf16[256,16]{1,0} parameter(1), metadata={op_name="y"}
  %convert.3 = f32[256,16]{1,0} convert(bf16[256,16]{1,0} %Arg_1.2),
  %Arg_0.1 = f32[128,256]{1,0} parameter(0), metadata={op_name="x"}
  ROOT %dot.4 = f32[16,128]{1,0} dot(f32[256,16]{1,0} %convert.3, f32[128,256]{1,0} %Arg_0.1), lhs_contracting_dims={0}, rhs_contracting_dims={1},
}
HLO 문법은 곧 설명하겠지만, 일단은 이것이 위 JAX 코드와 실제로 꽤 잘 대응한다는 점만 봐 두자. 예를 들어
ROOT %dot.4 = f32[16,128]{1,0} dot(f32[256,16]{1,0} %convert.3, f32[128,256]{1,0} %Arg_0.1), lhs_contracting_dims={0}, rhs_contracting_dims={1}이 부분이 위의 실제 matmul로, 두 f32 행렬을 각각 0번과 1번 차원을 따라 곱한다.
이 HLO를 TPU에서 실행할 수 있는 코드로 바꾸기 위해 XLA 컴파일러는 먼저 이를 LLO(low-level optimizer) IR로 lower한다. LLO는 TPU를 직접 프로그래밍한다 — 메모리 간 복사를 스케줄링하고, 배열을 systolic array에 밀어 넣는 식이다. LLO 코드는 buffer를 systolic array에 밀어 넣고, 결과를 꺼내 오고, TPU 메모리의 서로 다른 부분들 사이를 오가는 DMA를 스케줄링하는 primitive들을 담고 있다. LLO까지 lower되고 나면 기계어로 컴파일되어 TPU IMEM에 적재되고 실행된다.
프로그램이 원하는 것보다 느리게 돌 때 성능 개선 작업은 주로 JAX 수준에서 한다. 하지만 그러려면 HLO의 의미론과 코드가 TPU에서 실제로 어떻게 실행되는지를 어느 정도 이해해야 하는 경우가 많다. 더 낮은 수준에서 뭔가 잘못되면 또 하나의 탈출구를 열어 Pallas로 커스텀 kernel을 작성한다. 프로그램의 HLO와 런타임 통계를 보는 데는 JAX profiler를 쓴다.
JAX Profiler: 다목적 TPU profiler
JAX는 프로그램이 실행될 때 TPU에서 무슨 일이 일어나는지 이해할 수 있게 해 주는 유용한 도구를 잔뜩 갖춘 다목적 TPU profiler를 제공한다. jax.profiler 모듈로 실행 중인 프로그램을 trace해서 각 하위 구성 요소의 소요 시간, 각 프로그램의 HLO, 메모리 사용량 등 온갖 것을 기록할 수 있다. 예를 들어 아래 코드는 trace를 /tmp/tensorboard의 파일로 남기고, TensorBoard에서 볼 수 있다(여기에 단계별 가이드가 있다).
import jax
with jax.profiler.trace("/tmp/tensorboard"):
  key = jax.random.key(0)
  x = jax.random.normal(key, (1024, 1024))
  y = x @ x
  y.block_until_ready()

# Now you can load TensorBoard in a Google Colab with
#
# !pip install -U xprof
# !pip install -U protobuf
# %load_ext tensorboard
# %tensorboard --logdir=/tmp/tensorboard
#
# or externally with
#
# > tensorboard --logdir=/tmp/tensorboard
#
profiler에서 할 수 있는 일의 개요는 다음과 같다:
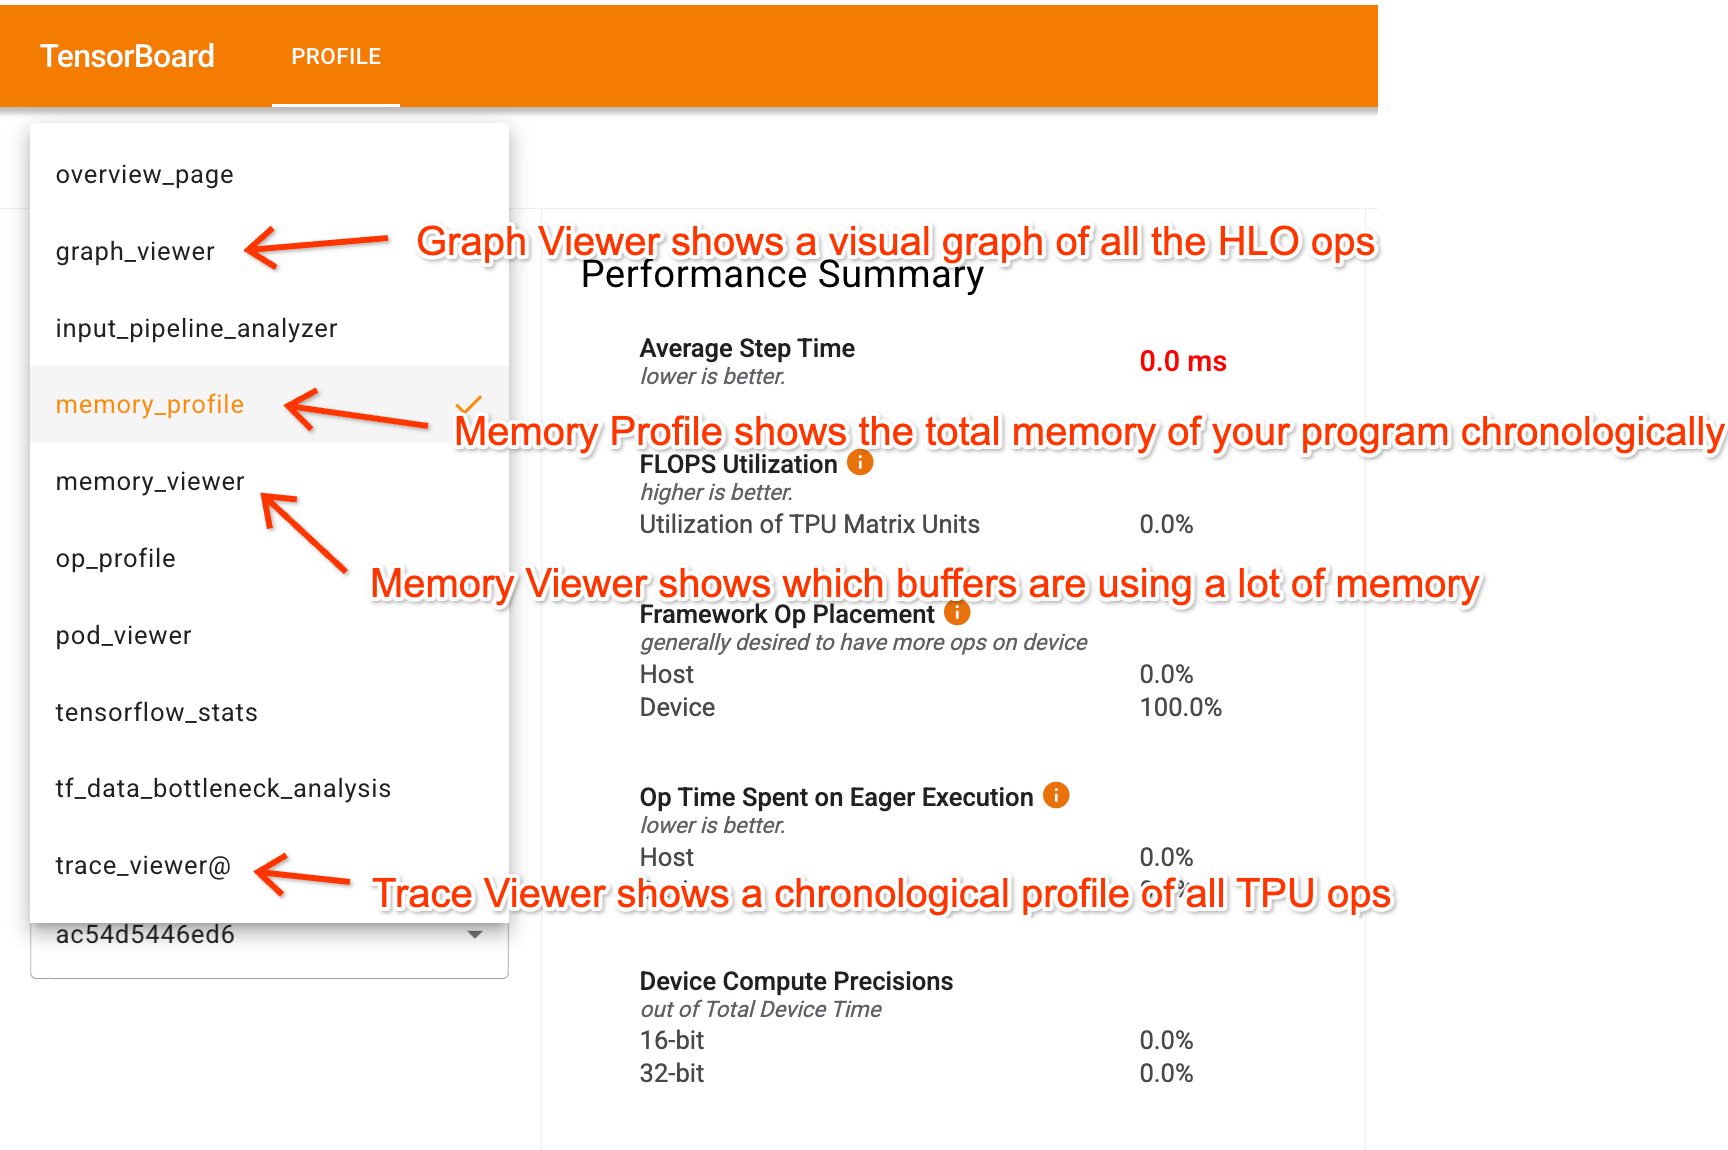
TensorBoard에 들어가면 profiler에는 프로그램을 이해하는 데 도움이 되는 핵심 탭이 몇 개 있다:
- Trace Viewer는 TPU에서 실제로 일어나는 일의 상세한 타임라인을 보여준다.
- Graph Viewer는 HLO 그래프를 보여주어, 프로그램의 어느 부분이 어느 부분으로 이어지는지와 어떻게 sharding되어 있는지 볼 수 있다.
- Memory Profile과 Memory Viewer: 프로그램이 메모리를 얼마나 쓰고 있는지 보여준다.
profile을 공유하기는 약간 까다롭지만, 간단한 Transformer에 대해 적어도 Trace Viewer 구성 요소만큼은 담고 있는 Perfetto 링크가 여기 있다. 이 Colab에서는 전체 JAX/TensorBoard trace를 직접 생성해서 가지고 놀 수 있다.
Trace Viewer
Trace Viewer는 아마 profiler에서 가장 유용한 부분일 것이다. 아래 예시는 간단한 Transformer의 각 부분에 주석을 단 것이다. 이름은 코드에서 붙인 라벨에서 온다.
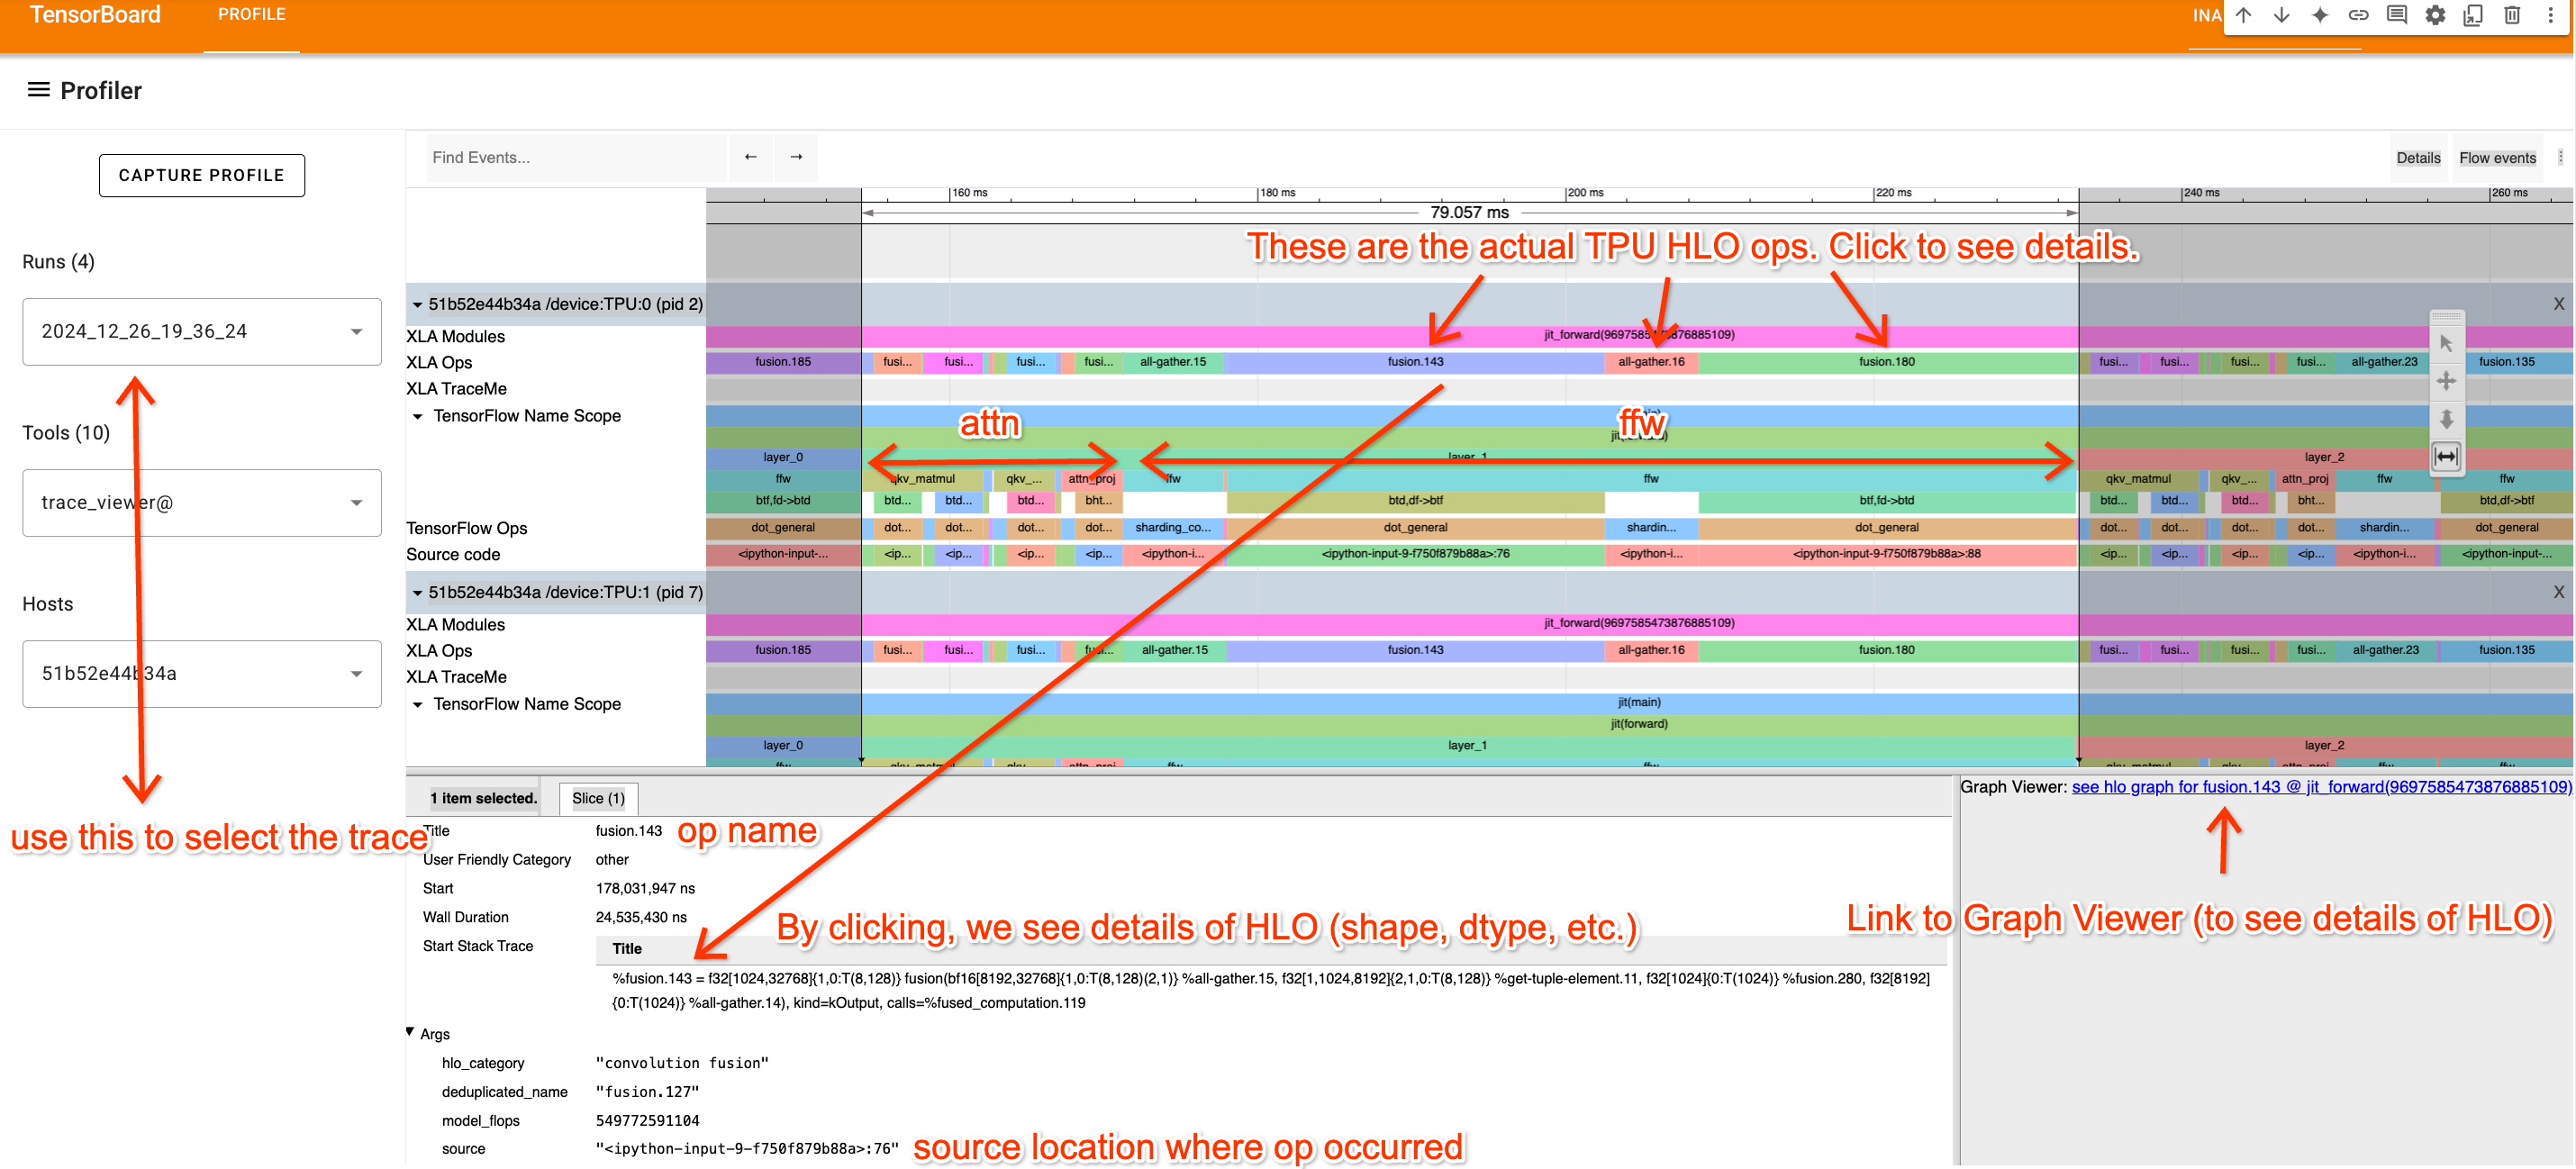
Trace Viewer는 각 TPU 코어에서 일어나는 모든 동작의 시간순 타임라인을 보여준다. 보통 모든 TPU가 같은 명령을 실행하므로 여기서는 TPU:0만 본다. 핵심 몇 가지:
- 맨 윗줄(XLA Ops)은 실제 TPU 연산을 보여준다(이름은 HLO 이름이다). 나머지는 전부
jax.named_scope,jax.named_call, Python 스택 트레이스에 기반한 근사적인 trace다. - 반복되는 블록을 눈여겨보면 여기서 레이어 하나를 분리해 낼 수 있다. 또 (코드를 보거나 Transformer의 동작 방식을 이해하고 있다면) 어느 부분이 attention이고 어느 부분이 MLP인지도 알 수 있다.
- XLA op을 클릭하면 그 op이 코드의 어디에서 왔는지 볼 수 있고(trace를 이해하는 데 유용하다) Graph Viewer로 가는 링크도 나온다.
팁(Tip): Trace Viewer는 “비디오 게임” 스타일 조작으로 탐색할 수 있다. A/D로 좌우 이동, W/S로 확대·축소다. 이 조작법을 쓰면 탐색이 훨씬 편해진다.
XLA op 읽는 법
HLO는 사실 그렇게 읽기 어렵지 않고, 위 trace의 특정 부분이 무엇에 해당하는지 이해하는 데 큰 도움이 된다. fusion.3이라는 예시 op을 보자.
%fusion.3 = bf16[32,32,4096]{2,1,0:T(8,128)(2,1)S(1)} fusion(bf16[32,32,8192]{2,1,0:T(8,128)(2,1)S(1)} %fusion.32), kind=kCustom, calls=%all-reduce-scatter.3이걸 조각조각 뜯어 보자.
- Op Name: fusion.3
- dot 또는 fusion op은 최대 1개의 행렬 곱셈과, 경우에 따라 그에 딸린 여러 pointwise VPU-op을 담은 연산 집합이다.
- Shape:
bf16[32,32,4096]- 이 op의 출력 shape이다. dtype이 bf16(원소당 2바이트)이고 shape이
[32,32,4096]이다.
- 이 op의 출력 shape이다. dtype이 bf16(원소당 2바이트)이고 shape이
- Layout:
{2,1,0:T(8,128)(2,1)}{2,1,0:T(8,128)(2,1)}은 메모리에서 축들의 순서(column-major, row-major 등)와 배열 padding을 알려준다. 아래에서 더 다룬다.
- Memory location: S(1)
- S(1)은 이 배열이 VMEM에 있다는 뜻이다. S(0)(생략되기도 한다)은 HBM이다. S(2)와 S(3)은 다른 메모리 공간이다.
- Arguments:
bf16[32,32,8192]{2,1,0:T(8,128)(2,1)S(1)} %fusion.32- 이 op에는 입력이 하나 있는데, 특정 shape을 가진 fusion.32라는 bf16 배열이다. 여기서 어떤 함수가 이 op으로 이어지는지 알 수 있다.
이 표기법을 조금 더 이해해 보자. 간단한 예로 다음을 보자:
f32[3,5]{1,0:T(2,2)}
이 op이 shape [3, 5]의 float32 배열을 특정 tiling {1,0:T(2,2)}으로 반환한다는 말이다. tiling이 아주 중요하지는 않지만 짧게 말하면, tiling은 N차원 배열이 메모리에 순차적으로 어떻게 배치되는지를 알려준다. 이 배열이 어떻게 배치되는지 보여주는 그림이다:
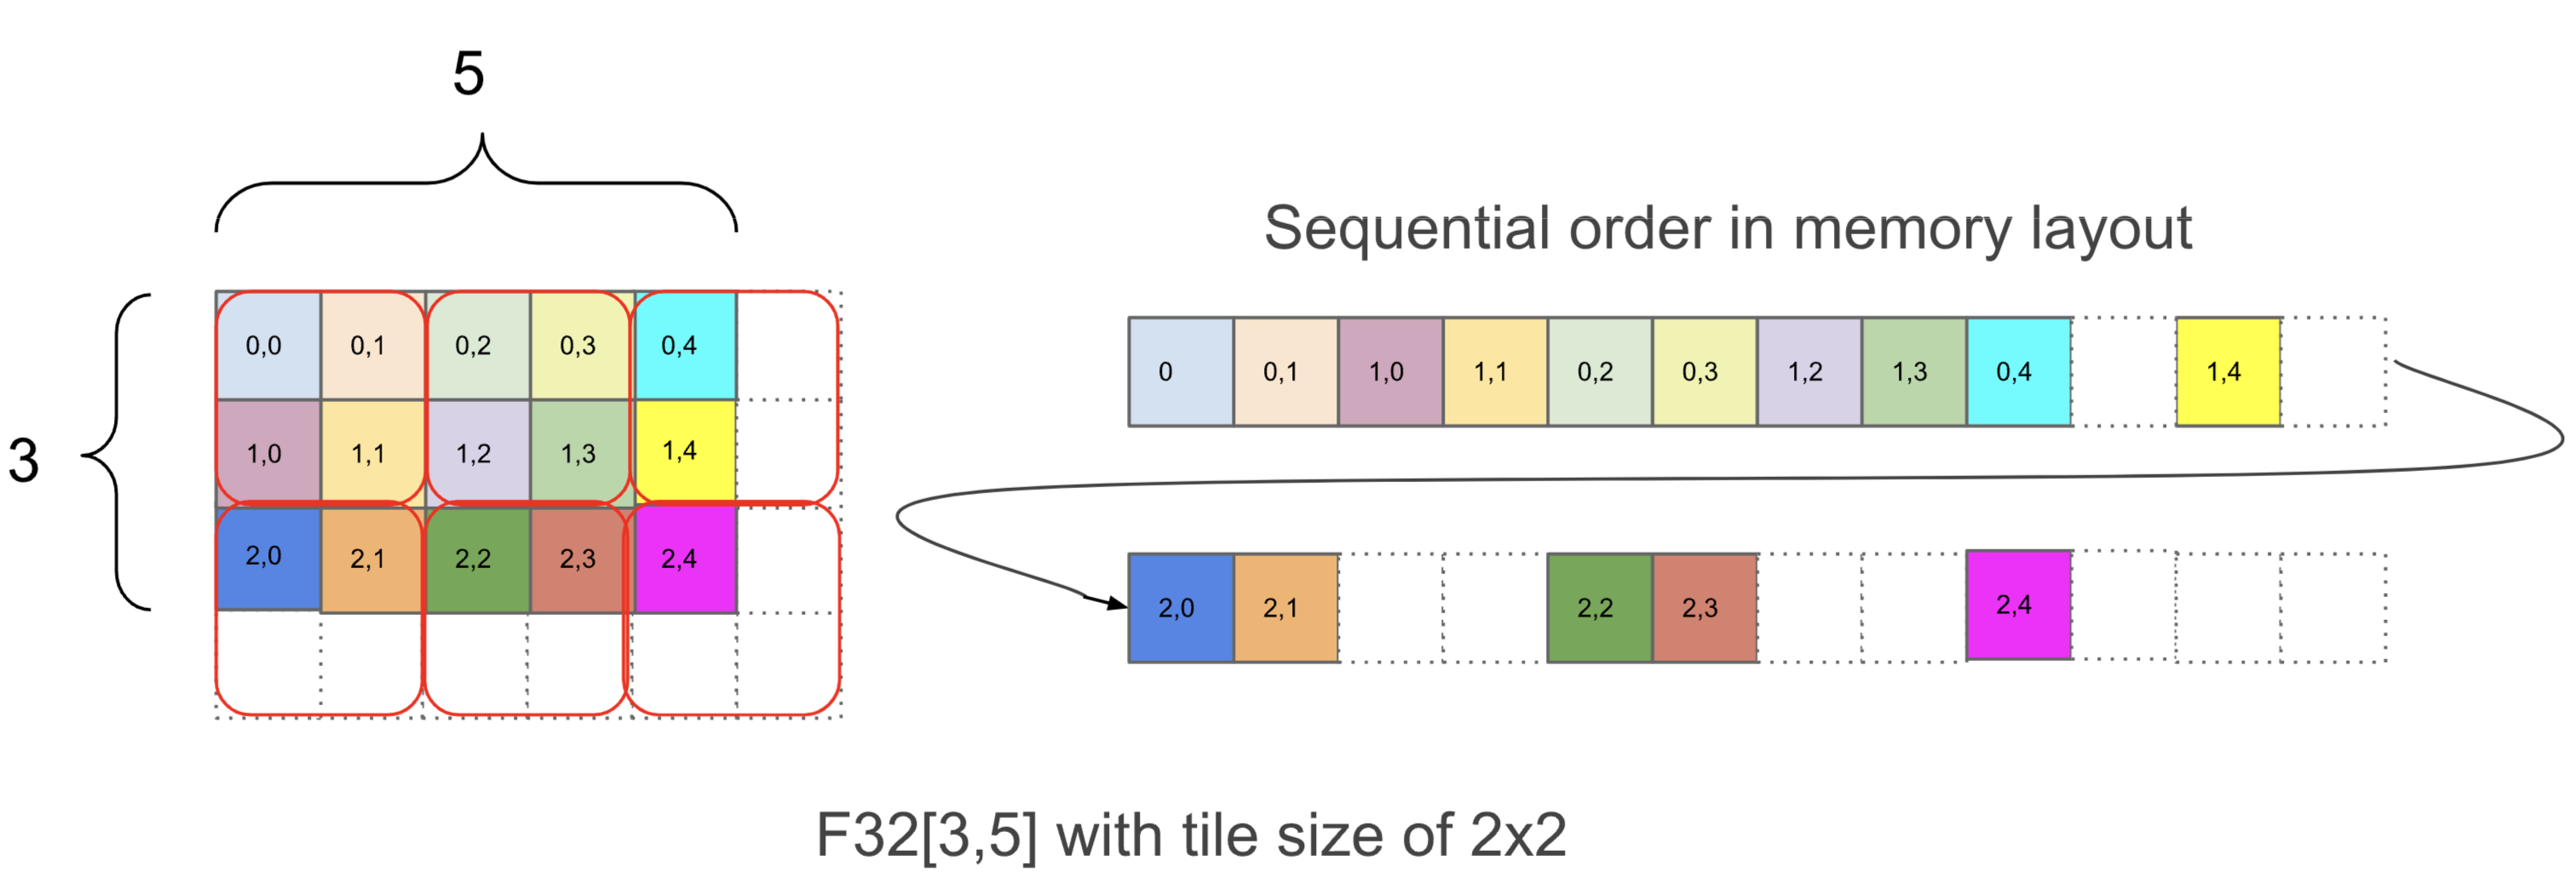
{1,0:T(2,2)}에서 1,0 부분은 물리 메모리에서 배열 차원들의 순서를 가장 minor한 것부터 가장 major한 것 순으로 알려준다. 이 부분을 오른쪽에서 왼쪽으로 읽으면서 f32[3,5]의 해당 차원을 짚어 보면 배열의 물리적 layout을 알아낼 수 있다. 이 예시에서 물리적 layout은 논리적 shape과 동일한 [3,5]다.
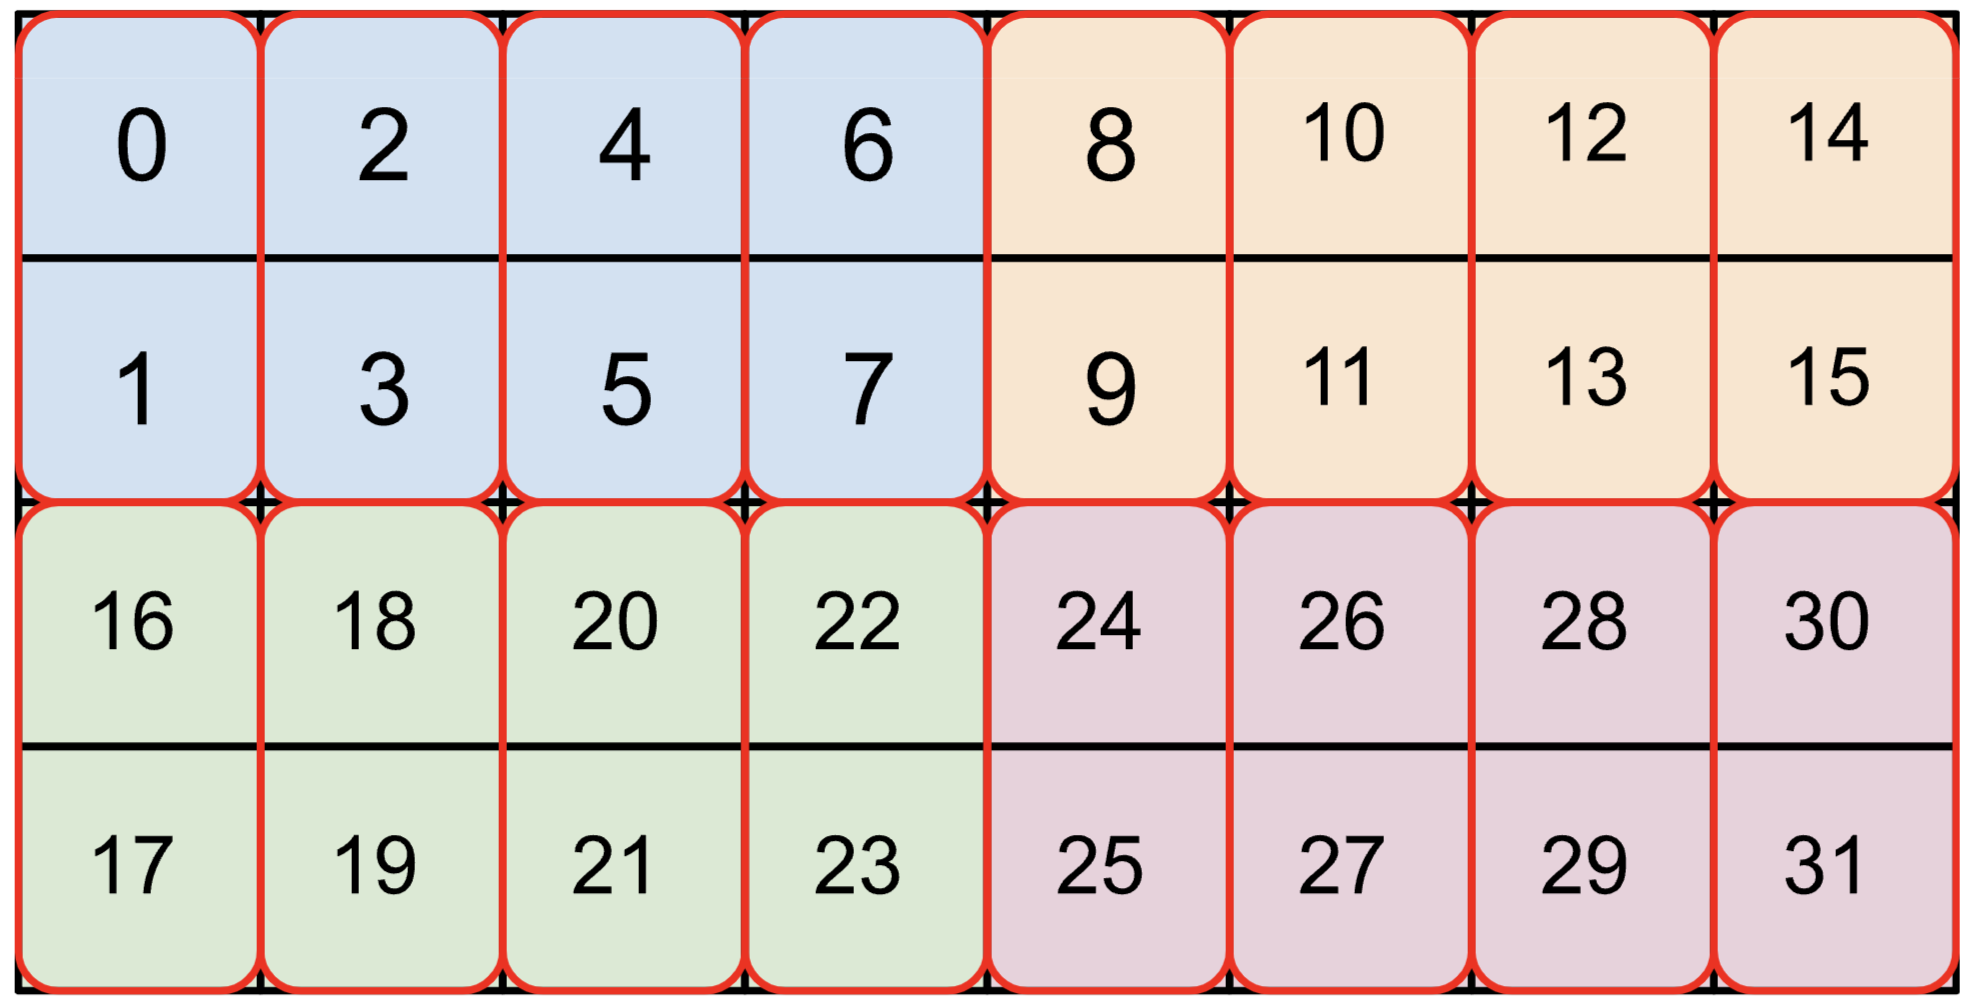
그다음 T(2,2)는 배열이 (2, 2) 청크 단위로 tiling되어 있고, 각 청크 안에서는 행이 먼저(row-major), 그다음 열 순서라는 것을 알려준다. 즉 (0, 0) 다음에 (0, 1)이 오고, 그다음 (1, 0)과 (1, 1)이 온다. T(2, 2) tiling 때문에 배열은 [4, 6]으로 padding되어 메모리 사용량이 약 1.6배로 늘어난다. 위에서 본 큰 bf16 배열 bf16[32,32,8192]{2,1,0:T(8,128)(2,1)S(1)}의 경우 T(8,128)(2,1)인데, 배열의 tiling이 두 단계다 — 바깥쪽 (8, 128) tiling과 그 단위 안의 안쪽 (2, 1) tiling(bf16에 쓰여서 로드가 항상 4바이트의 배수가 되게 한다)이다. 예를 들어 bf16[4,8]{1,0:T(2,4)(2,1)}은 다음과 같다(색깔은 (2,4) 타일, 빨간 상자는 (2,1) 타일):
tiling은 텐서의 청크를 VMEM으로 얼마나 효율적으로 로드할 수 있는지에 영향을 주고, XLA는 프로그램 안에서 텐서를 “retile”하거나 “re-layout”하는 복사를 끼워 넣기도 하는데 그 오버헤드가 무시할 수 없는 수준일 때도 있다.2
Graph Viewer
위의 fusion들 중 일부는 복잡해 보이지만, XLA Graph Viewer를 쓰면 해석하기가 더 쉬워진다. 예를 들어 꽤 복잡한 fusion을 Graph Viewer로 본 모습이다:
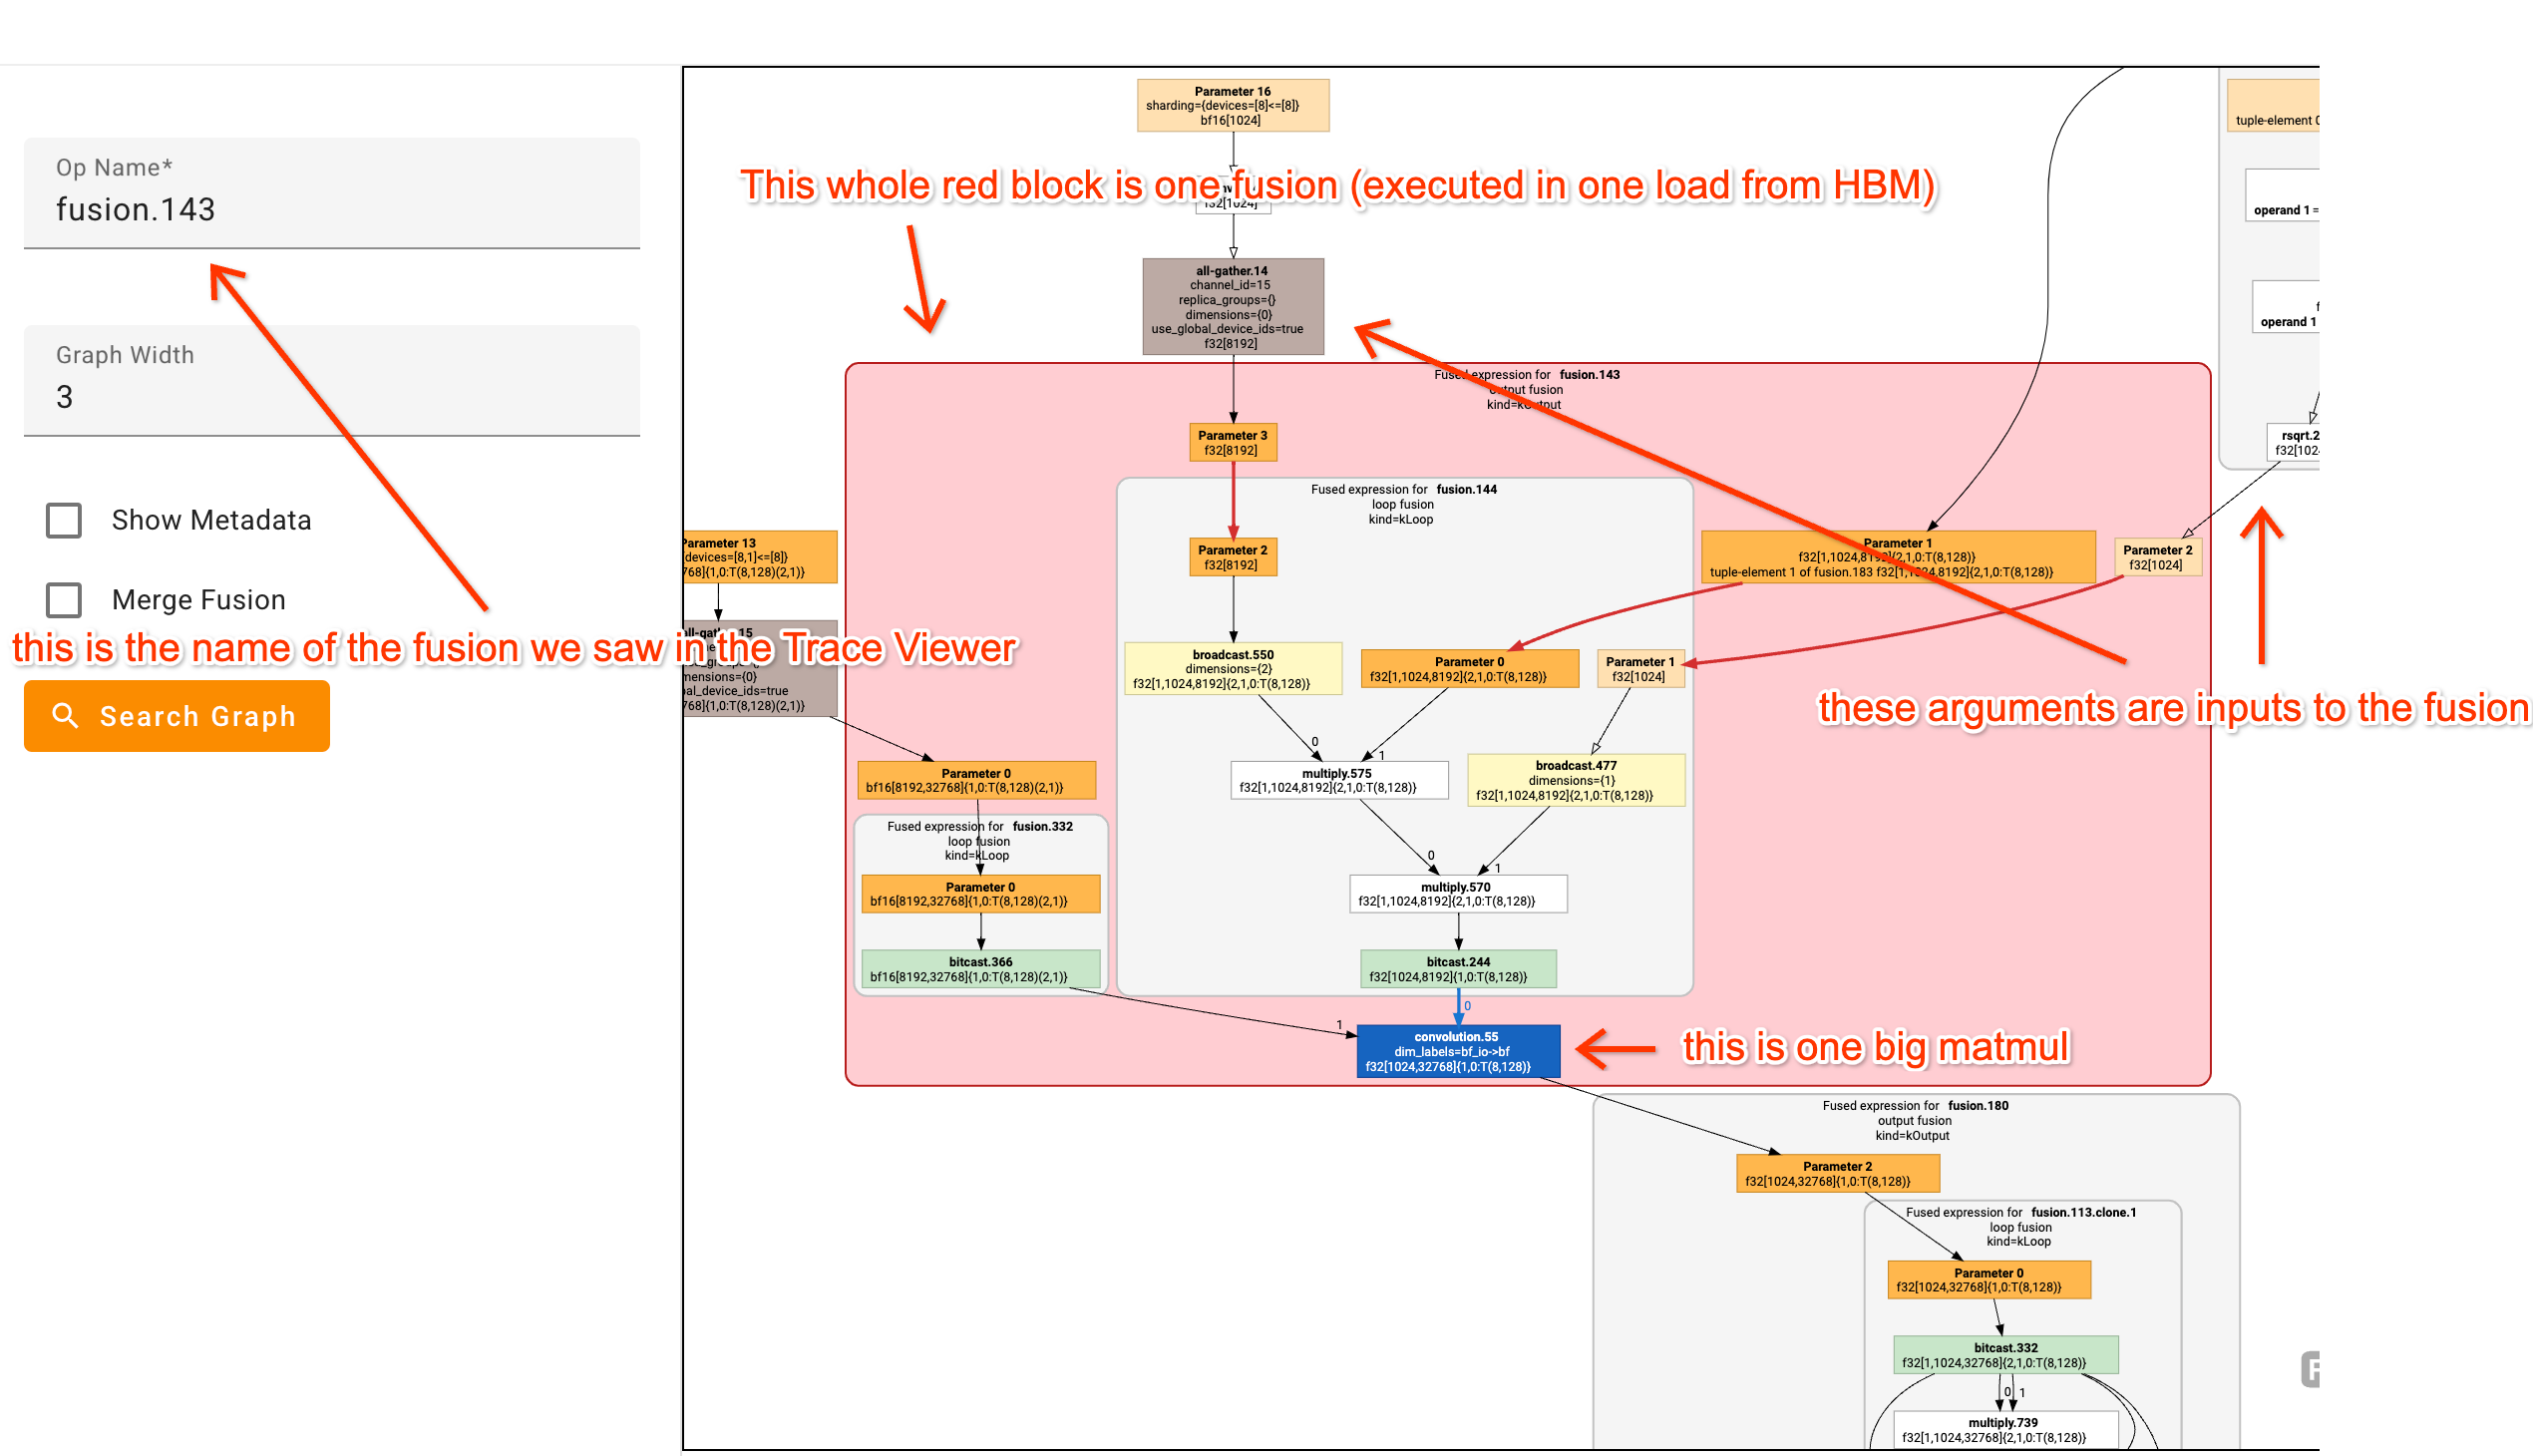
HLO 그래프를 여러 개 들여다보면서 HLO op을 profiling 중인 코드에 대응시켜 보는 연습은 정말 도움이 된다. 상자 위에 마우스를 올리면 그 함수가 정의된 코드 줄이 표시되는 경우가 많다.
실제에 가까운 예시 profile 살펴보기
이 Colab에 가짜 Transformer의 예시 profile이 있다. 시간이 없다면 최소한 Trace Viewer라도 볼 수 있는 Perfetto 링크가 여기 있다. 무슨 일이 일어나는지 알아볼 수 있도록 평소보다 공을 들여 trace에 jax.named_scope 호출로 주석을 달아 두었다.
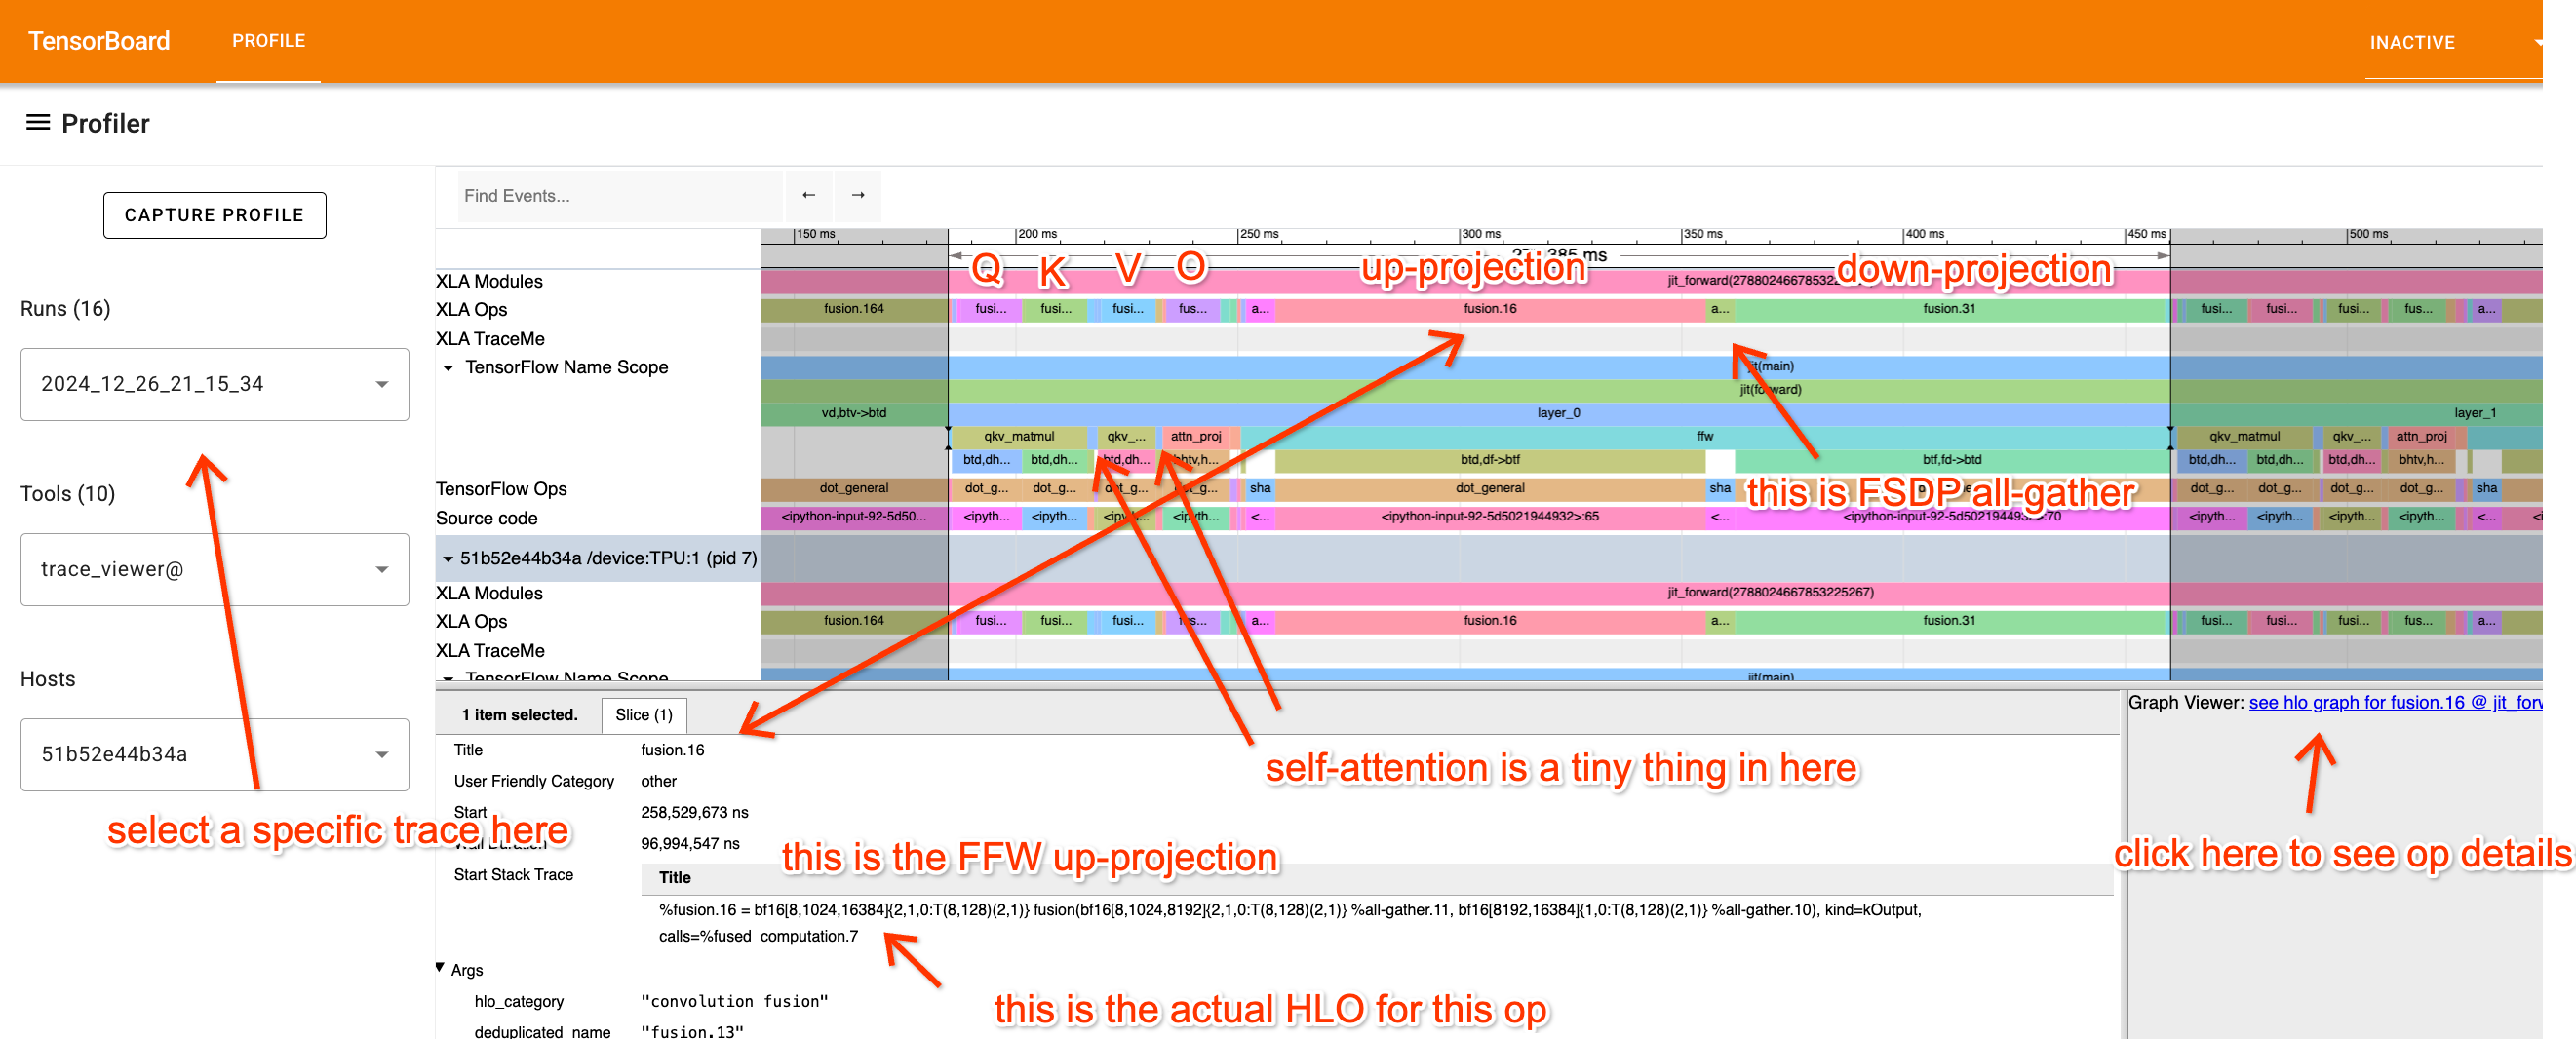
profile을 보면서 각 부분이 무엇을 하는지 제대로 이해해 보자. FFW 블록부터 조금씩 뜯어 보자:
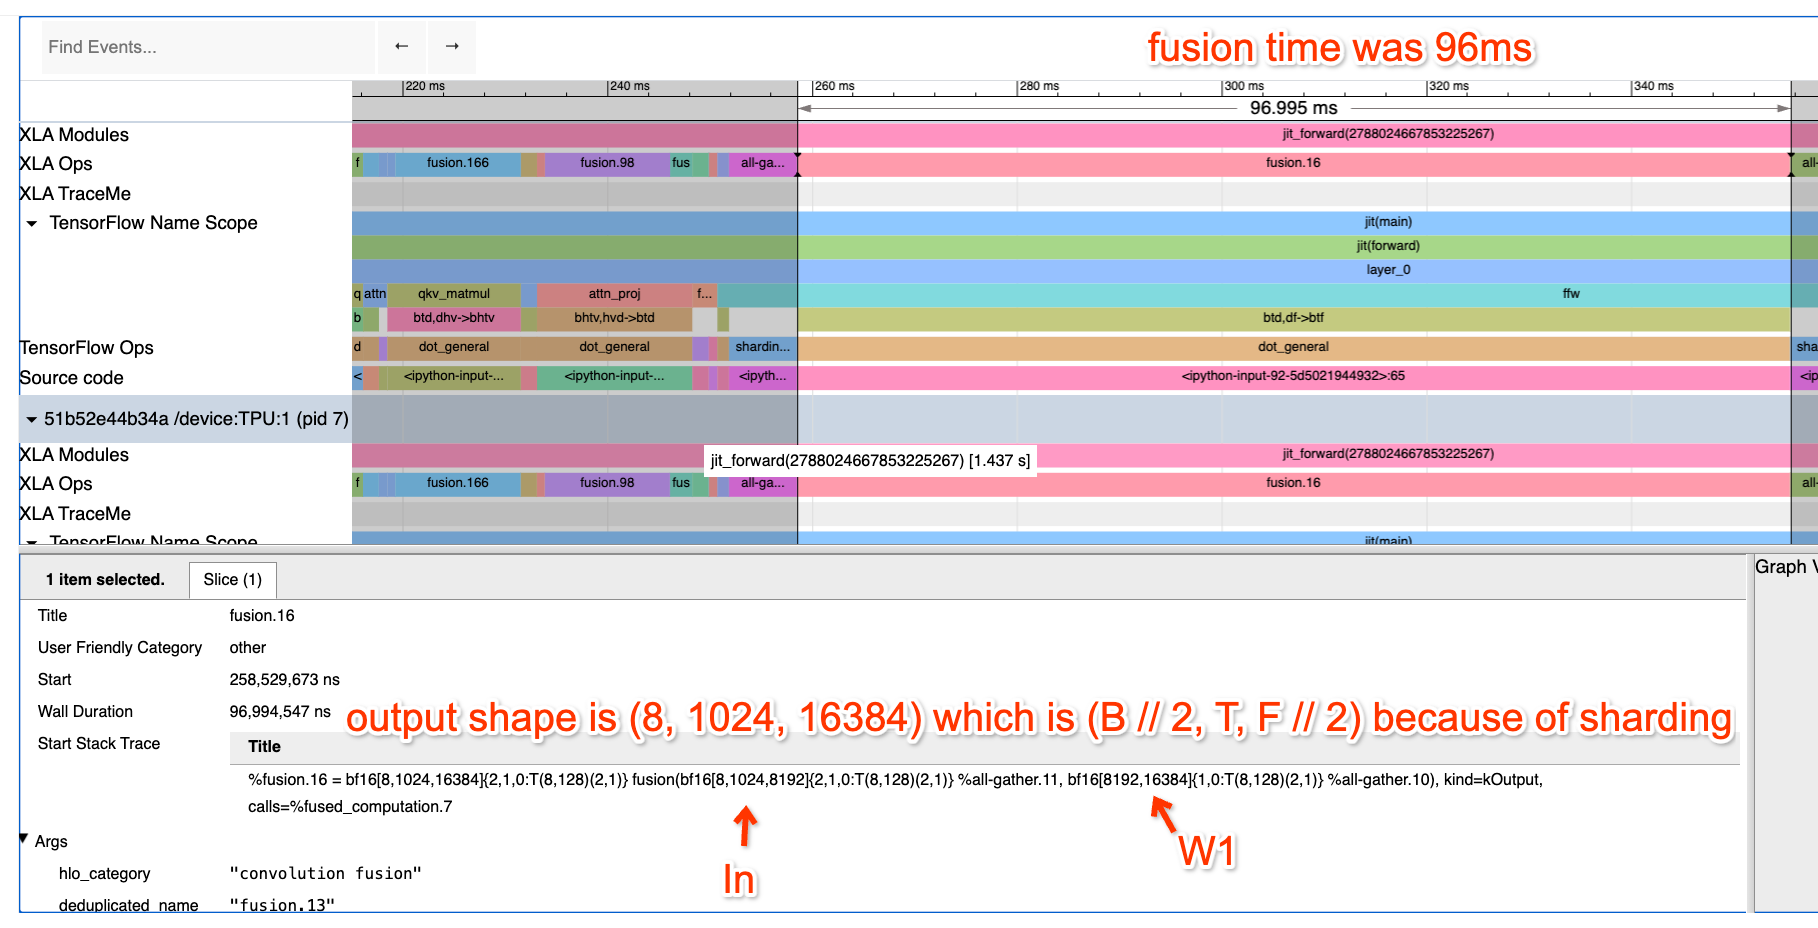
FFW 블록을 확대한 모습이다. up-projection op은 입력이 bf16[8, 1024, 8192]와 bf16[8192, 16384], 출력이 bf16[8, 1024, 16384]인 fusion(matmul)이다. (이 코드를 내가 썼기 때문에) 이것이 4-way DP, 2-way MP로 sharding된 matmul의 로컬 뷰라는 것을 아는데, 실제로 수행하는 연산은 다음과 같다
X: bf16[32, 1024, 8192] * Win: bf16[8192, 32768] -> Tmp: bf16[32, 1024, 32768]
이 연산은 얼마나 걸릴 것으로 기대해야 할까? 우선 data parallel shard당 batch size가 8 * 1024 = 8192이므로 확실하게 compute-bound여야 한다. 8개의 TPU v2 코어에서 도는 것이므로 약 2 * 32 * 1024 * 8192 * 32768 / (23e12 * 8) = 95.6ms가 걸릴 것으로 기대되는데, 실제 소요 시간(96ms)과 거의 정확히 일치한다. 훌륭하다! FLOPs 활용률이 환상적이라는 뜻이다!
Google Colab은 더 이상 TPU v2-8 slice를 제공하지 않는다는 점에 유의하라. 직접 따라 해 볼 실제 8코어 slice가 필요하면, 여전히 무료로 제공하는 Kaggle을 쓰거나 GCP에서 8코어 slice를 프로비저닝하면 된다.3
통신은 어떨까? 두 번째 matmul 끝에 숨어 있는 작은 fusion이 보일 것이다. 클릭해 보면 다음이 나온다
%fusion.1 = bf16[8,1024,4096]{2,1,0:T(8,128)(2,1)} fusion(bf16[8,1024,8192]{2,1,0:T(8,128)(2,1)} %fusion.31), kind=kCustom, calls=%all-reduce-scatter.1본질적으로 작은 ReduceScatter다(Graph Viewer로 본 모습은 다음과 같다):
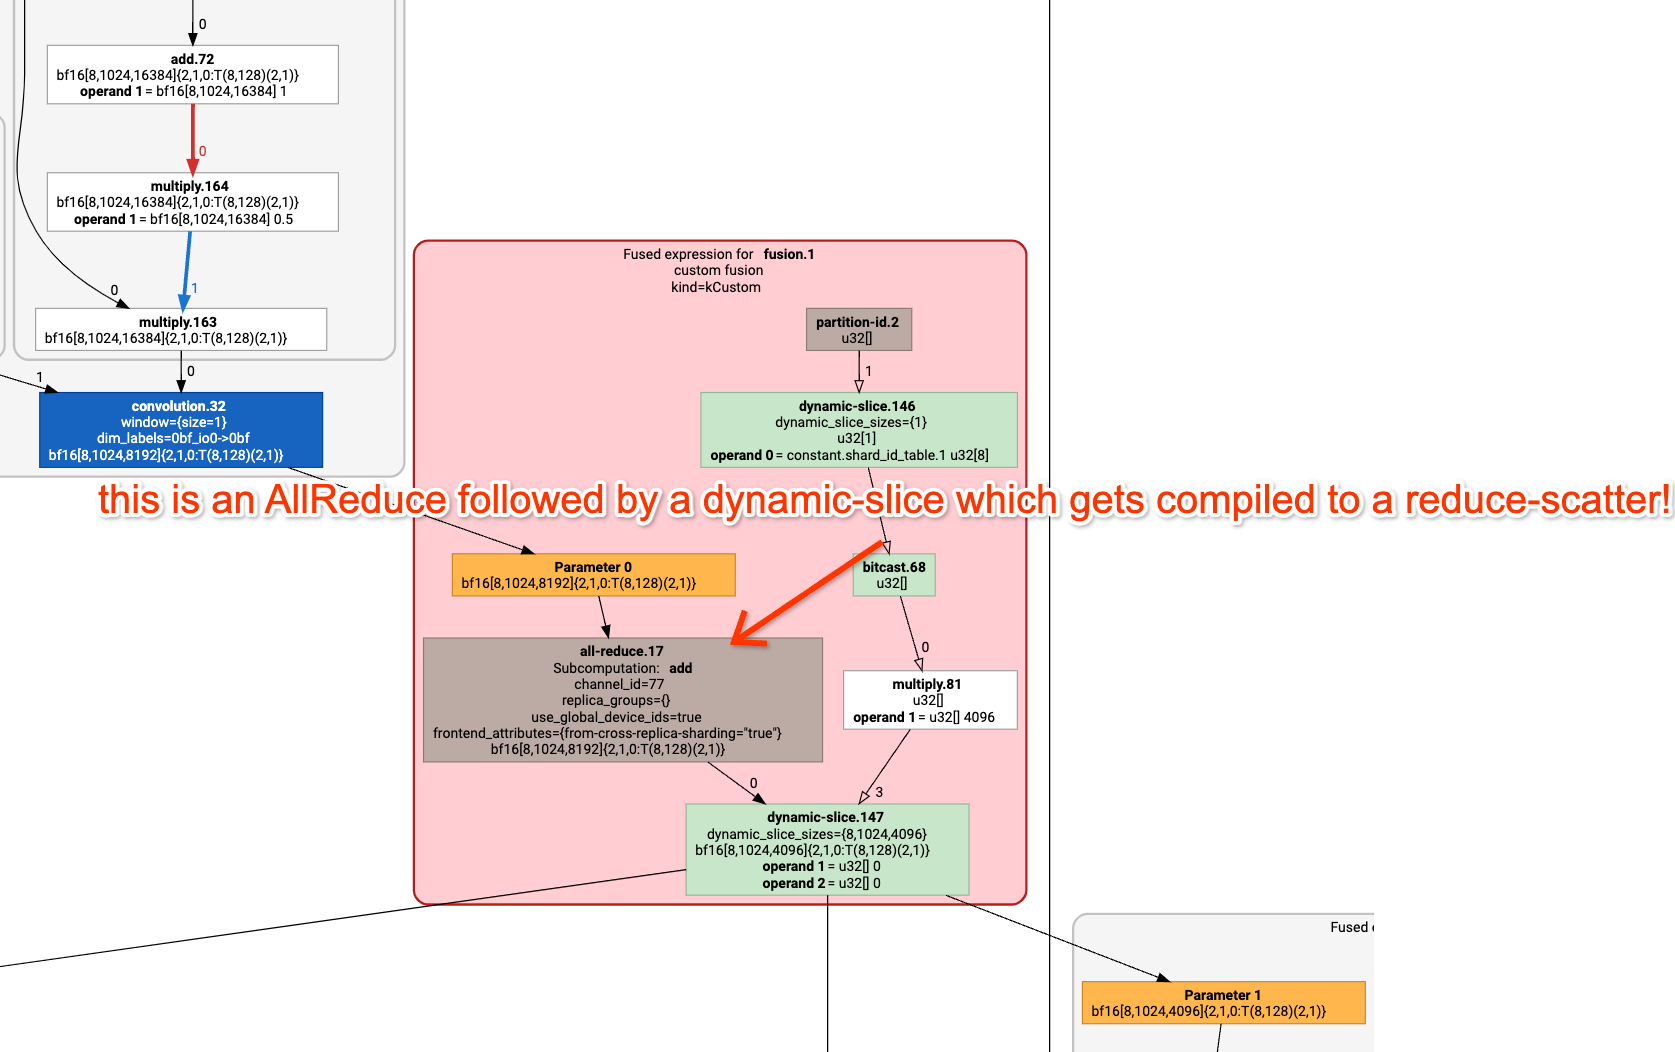
이건 얼마나 걸릴 것으로 기대해야 할까? TPU v2 4x2에서 ReduceScatter를 수행하고 있으므로, 1.2e11의 양방향 bandwidth로 hop 하나만 필요할 것이다. 배열 크기는 2*32*1024*8192이고 batch 축이 4-way로 sharding되어 있으므로 shard 하나는 2*8*1024*8192=128MB다. 따라서 대략 1.1ms가 걸려야 한다. 실제로는 얼마나 걸릴까? profile에 보고된 값은 1.13ms다. roofline에 정말 가깝다!
attention도 보자! attention 구성 요소의 profile이다:
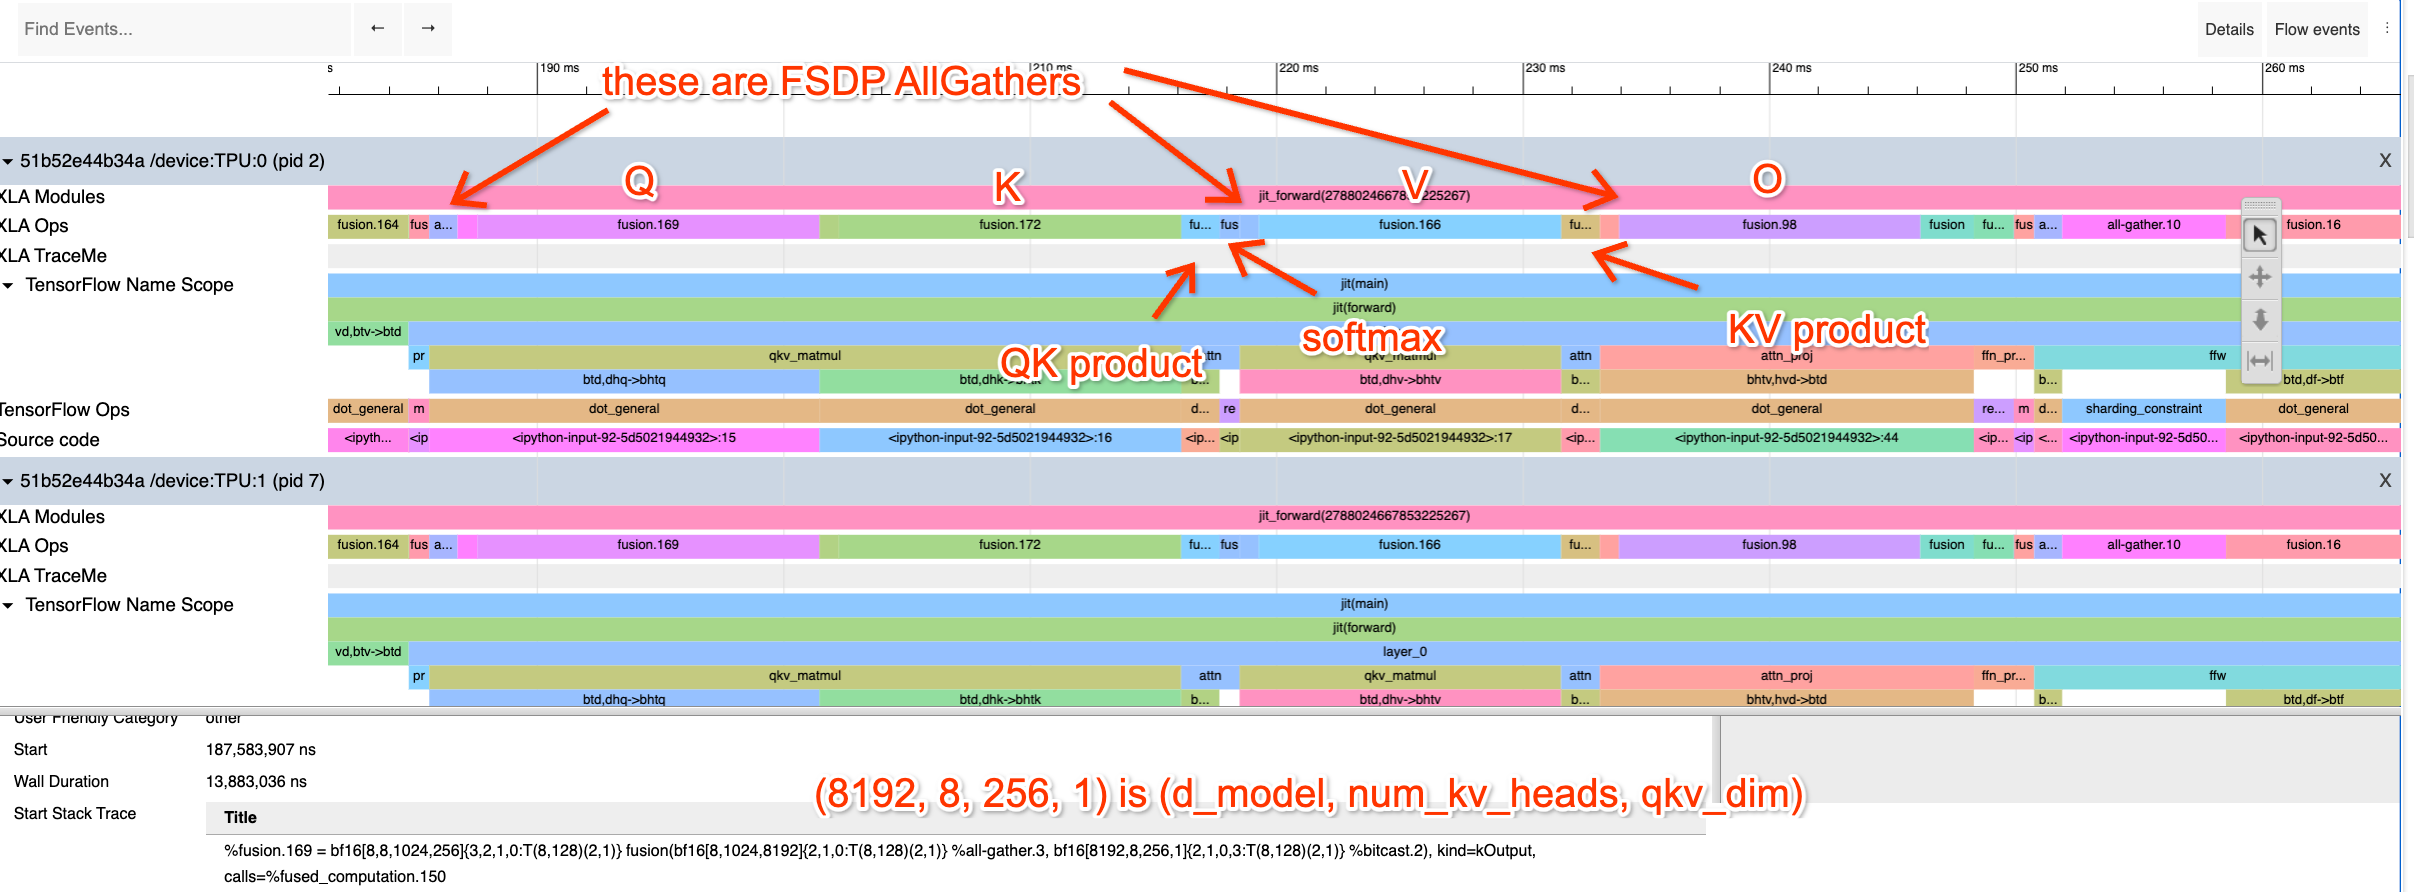
Q projection op을 클릭한 상태인데, 이 op은 shape이 [dmodel = 8192, nheads = 32, dqkv = 256]인 행렬 를 사용한다. head 차원을 따라 Megatron sharding을 하고 있다. 이 연산들이 얼마나 걸려야 하는지 계산하는 연습을 똑같이 해 보라.
Memory Profile
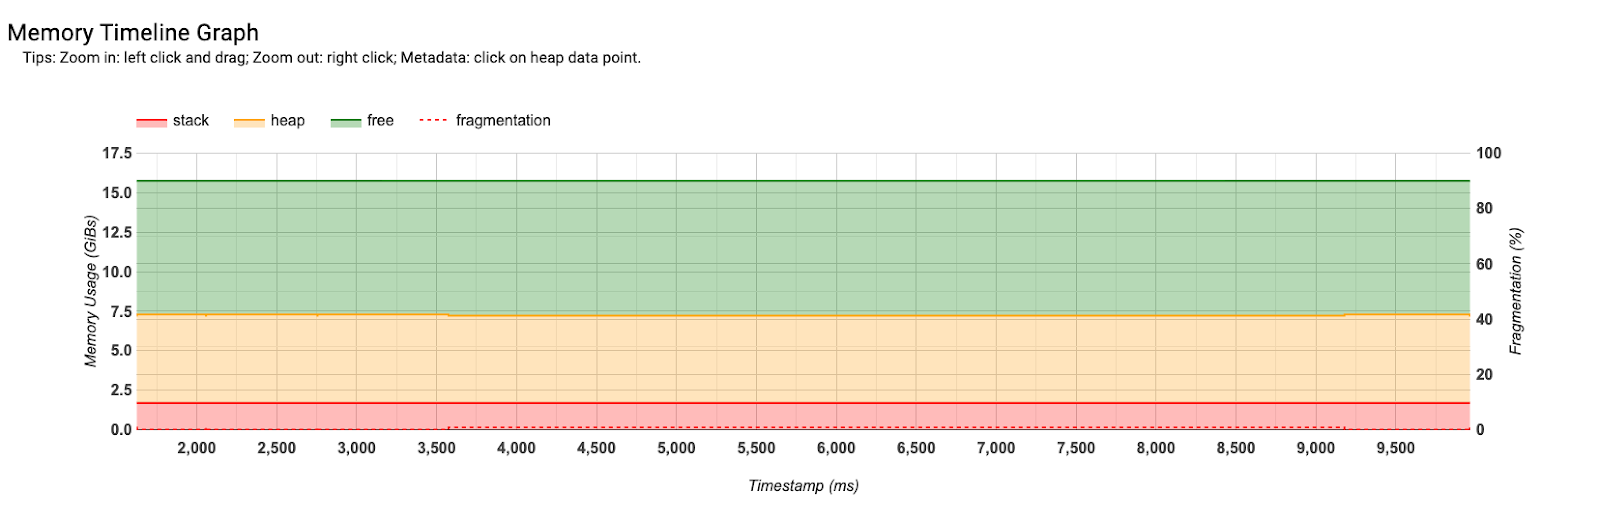
Memory Profile을 쓰면 시간에 따른 프로그램 메모리 사용량을 쉽게 볼 수 있다. OOM을 디버깅할 때 유용하다. 여기서는 모델 파라미터에 약 7.5GB가 할당되어 있고 약 8.5GB가 비어 있다. 즉 메모리에 훨씬 더 많은 것을 넣을 수 있다.
연습 문제
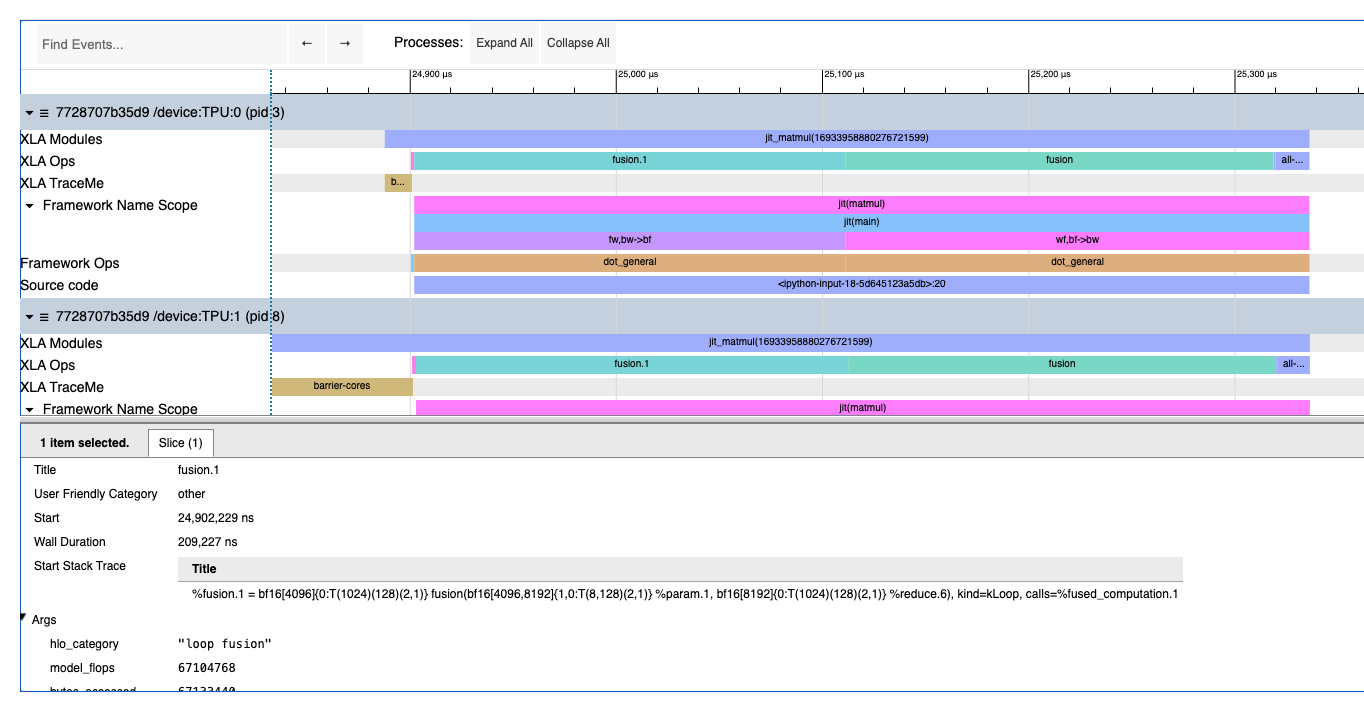
문제 1: 이 Colab/profile을 보고 어떤 부분이 수상해 보이는지, 여기서 무슨 일이 벌어지고 있는지 알아내라. 정확히 어떤 연산이 일어나고 있고 각 operation이 무엇을 하는지 말할 수 있는가? 관련된 각 행렬의 실제 shape은 무엇이고 어떻게 sharding되어 있는가? 코드를 읽기 전에 먼저 profile만 보고 시도해 보라.
정답 보기
이것은 두 개의 행렬 곱셈이다. 구체적으로는 다음과 같다:
def matmul(w1, w2, x):
  return jnp.einsum('wf,bf->bw', w2, jnp.einsum('fw,bw->bf', w1, x))
reduce 하나, 큰 fusion 두 개, all-reduce 하나가 보일 것이다. 첫 번째 큰 fusion은 다음과 같다:
%fusion.1 = bf16[4096]{0:T(1024)(128)(2,1)} fusion(bf16[4096,8192]{1,0:T(8,128)(2,1)} %param.1, bf16[8192]{0:T(1024)(128)(2,1)} %reduce.6), kind=kLoop, calls=%fused_computation.1shard당 shape은 (8192 차원에 대한 축약으로) bf16[8192] * bf16[4096, 8192] -> bf16[4096]이다. 마지막 AllReduce의 replica_groups={{0,16,32,48,64,80,96,112}, ...}를 관찰하면 8-way model parallelism을 하고 있음을 알 수 있고, 따라서 실제 shape은 bf16[8, 8192] * bf16[32768, 8192] -> bf16[8, 32768]이다.
문제 2: 앞서 본 Transformer Colab은 간단한 mock Transformer를 구현한다. Colab이 더 이상 TPU v2-8 slice를 제공하지 않으므로, 따라 하려면 Kaggle이나 8코어 GCP slice에서 실행해야 할 것이다. Colab의 지시를 따라 GSPMD partitioning을 쓰는 naive Transformer의 벤치마크를 얻어라. 각 부분은 얼마나 걸리는가? 얼마나 걸려야 하는가? 어떤 sharding이 쓰이고 있는가? sharding을 고쳐 보라! 힌트: jax.lax.with_sharding_constraint로 동작을 제약할 수 있다. 이렇게 고치면 최대 얼마의 MFU를 얻을 수 있는가?
참고로 초기 버전은 레이어당 약 184ms, 최적화된 profile은 레이어당 67ms가 나온다. 여기까지 했다면, profile을 들여다보면서 오로지 profile만으로 다음 질문에 답할 수 있는지 확인해 보라:
- 이것은 어떤 sharding 전략인가?
- batch size, , 는 얼마인가?
- attention과 MLP 블록에 각각 전체 시간의 몇 분의 몇이 쓰이는가?
- roofline 기준으로 각 op에 시간이 얼마만큼씩 쓰여야 하는가?
참고: 이 문제가 쓰인 이후 XLA 컴파일러가 더 좋아졌다. 이제 초기 버전은 레이어당 약 90ms이고, 최적화된 profile은 그보다 레이어당 겨우 10ms 정도 나은 수준(레이어당 80ms)이다. 그래도 직접 만져 보면서 더 잘할 수 있는지 확인해 볼 가치는 있다.
9부는 여기까지! JAX 병렬화를 깊이 파고드는 10부는 여기에서 볼 수 있다.
Footnotes
-
이 HLO를 얻으려면
jax.jit(f).lower(*args, **kwargs).compile().as_text()를 실행하면 된다. ↩ -
JAX는 이 문제를 우회하기 위한 실험적 기능을 제공하는데, XLA가 프로그램 입력에 대해 “선호하는” layout을 계산하게 해 주는 것이다.
jax.jit으로 프로그램을 “just-in-time” 컴파일할 때는 보통 JAX에 어떤 shape과 dtype을 기대할지 알려주는 “mock” 입력을 넘긴다. 이 입력들은 최적이 아닐 수도 있는 tiling 정보도 함께 담고 있다. 대신 입력 layout을 AUTO로 지정하면jax.jit이 jit된 프로그램이 선호하는 layout을 반환한다. 그러면 그 layout대로 텐서를 명시적으로 로드해서 프로그램 안에서 복사가 유발되는 것을 피할 수 있다. ↩ -
가짜 문제로 sharding만 가지고 놀고 싶다면
import jax; jax.config.update("jax_num_cpu_devices", 8)로 CPU에서 device 8개를 흉내 낼 수도 있다(jax >= 0.4.27쯤 필요). 그다음print(jax.devices())로 확인하면 된다. 장난감 문제에서만 동작하며 실제 성능을 반영하지 않는다. ↩