앞 장에서 배운 내용을 활용해 TPU v5p에서 LLaMA 3 모델을 학습하는 과정을 자세히 들여다보자. 이 모델들은 얼마나 큰가? 구성에 따라 학습 비용은 얼마나 달라지는가? 어떻게 sharding되는가? 앞 장들의 내용이 실제 모델에 어떻게 대응되는지 back-of-the-envelope 추정을 몇 가지 해 보자.
이 장의 목표는 앞 장의 결과를 아주 실용적인 문제, 즉 LLaMA 3 모델 패밀리(herd) 학습에 적용해 보는 것이다. 앞 장들과 달리 이번에는 여러분이 이 작업의 많은 부분을 직접 해 보길 바란다. 그래서 각 절의 정답을 숨겨 두었으니 먼저 스스로 답해 보자. 펜을 들고 손으로 직접 계산해 보자!
LLaMA 3은 어떻게 생겼는가?
LLaMA-3 모델 패밀리(Grattafiori et al. 2024)에는 세 가지 주요 모델이 있다: LLaMA 3 8B, 70B, 405B. 우리는 주로 70B에 집중하고, 8B와 405B는 마지막 문제 섹션에서 여러분이 직접 탐구하도록 남겨 둔다. 다음은 LLaMA 3-70B의 아키텍처로, LLaMA HuggingFace 페이지에서 가져온 것이다.
| hyperparam | 값 |
|---|---|
| (L) | 80 |
| (D) | 8,192 |
| (F) | 28,672 |
| (N) | 64 |
| (K) | 8 |
| (H) | 128 |
| (V) | 128,256 |
이걸 찾는 게 얼마나 쉬운지 보여 주기 위해, config 자체와 그 대응 관계를 함께 실어 둔다:
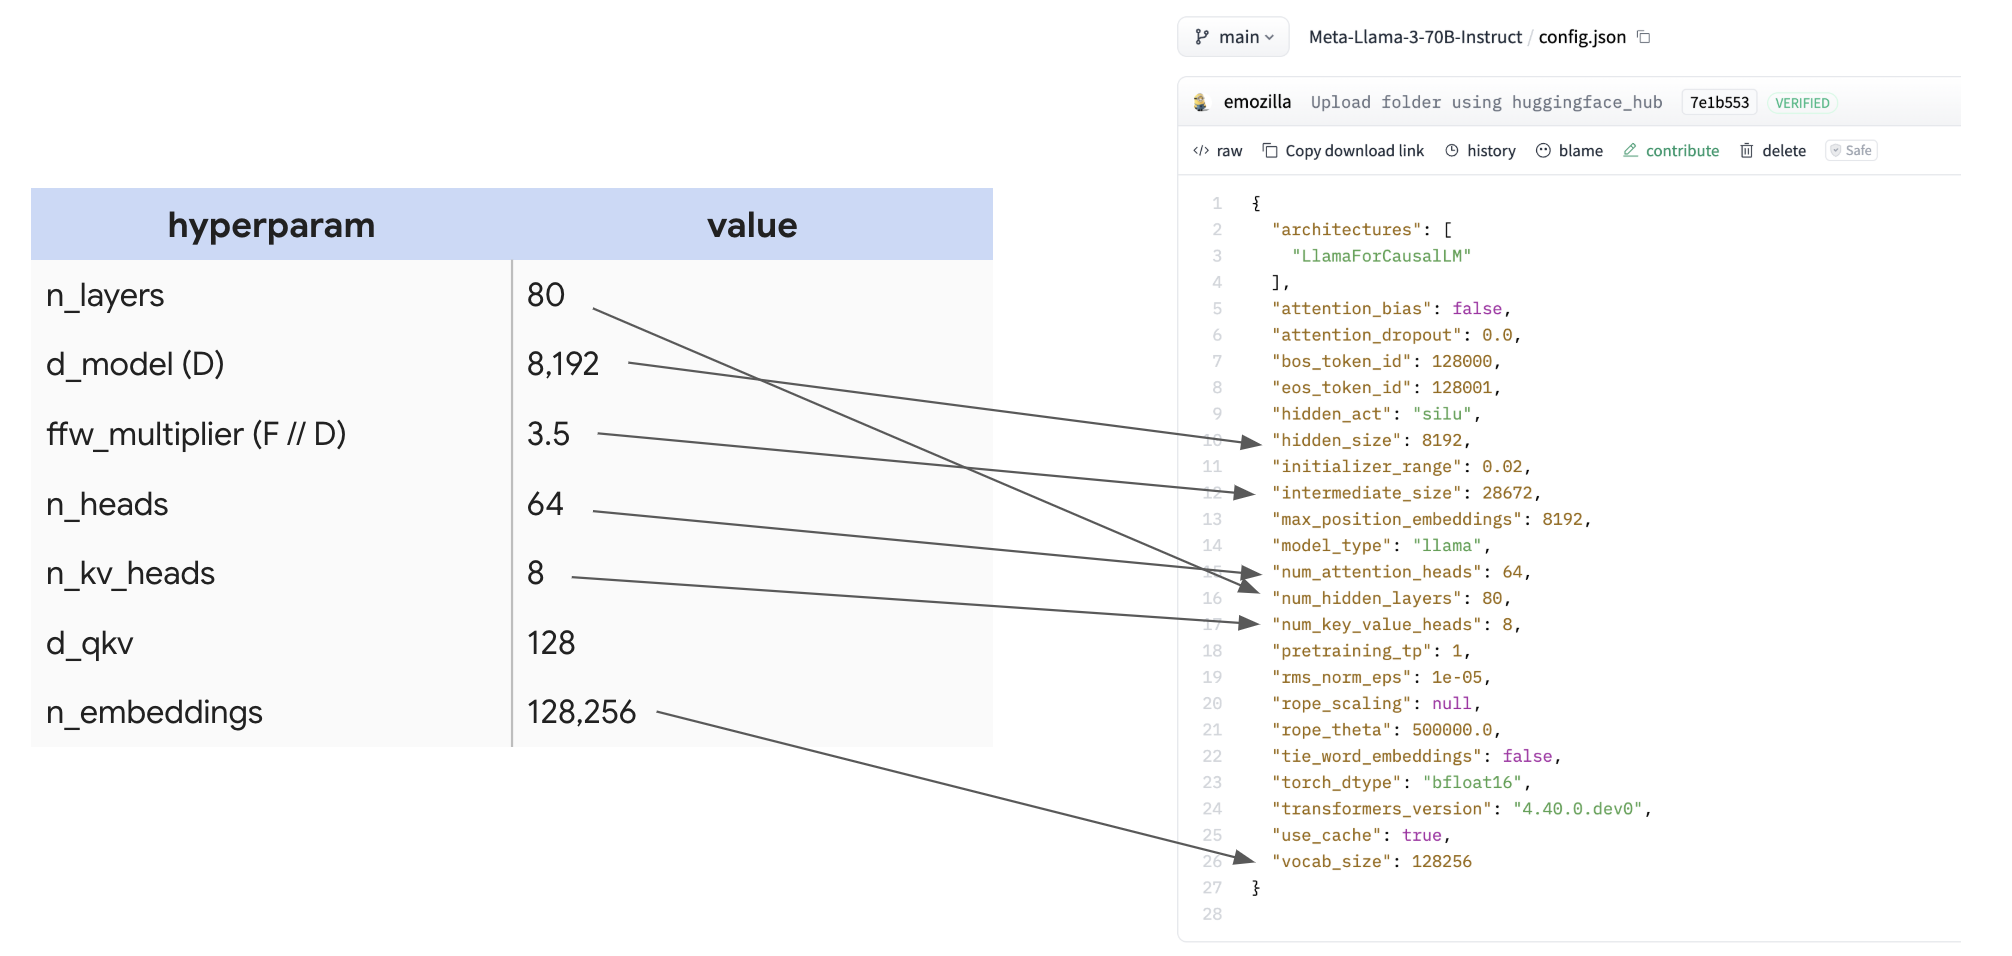
이런 수치를 여러 오픈소스 LLM에 대해 하나의 큰 표로 만들어 두면 각 모델이 내린 설계 결정을 빠르게 비교할 수 있어 유용하다.
파라미터와 FLOPs 세기
질문: 이 표로부터 LLaMA 3-70B의 파라미터 수를 계산할 수 있을까? 🤫 4장의 내용을 적용해서 70B가 나오는지 확인해 보자!
| param | 공식 | 개수 |
|---|---|---|
| FFW params | d_model * d_ff * 3 (SwiGLU의 gate, up, down projection) * n_layers | 8,192 * 8,192 * 3.5 * 3 * 80 = 56.3e9 |
| Vocab params | 2 (입력·출력 embedding) * n_embeddings * d_model | 2 * 128,256 * 8,192 = 2.1e9 |
| Attention params | n_layers * [ 2 (q embedding과 이어 붙인 output projection) * d_model * n_heads * d_qkv + 2 (k와 v) * d_model * n_kv_heads * d_qkv] | 80 * (2 * 8,192 * 64 * 128 + 2 * 8,192 * 8 * 128) = 12e9 |
| 56.3e9 + 2.1e9 + 12e9 = 70.4e9 |
훌륭하다! 기대한 숫자가 나온다. 예상대로 FFW 파라미터가 전체 파라미터 수를 압도하지만 attention도 무시할 수준은 아니다.
요점(Takeaway): MLP 블록의 큰 weight 행렬 3개는 Transformer의 다른 모든 배열보다 훨씬 커서, 모델 메모리나 FLOPs를 따질 때는 보통 나머지 파라미터를 거의 무시해도 된다. LLaMA 3-70B에서는 이 행렬들이 70B 중 56B 파라미터를 차지한다.
이제 FLOPs를 보자! 4장에서 다룬 학습의 일반 규칙을 떠올려 보자.
질문: LLaMA-3는 학습 스텝마다 토큰당 몇 FLOPs를 수행하는가? 이 값은 전체 학습 과정이 얼마나 비쌀지 가늠하는 데 도움이 된다.
정답 보기
정답: 4장에서 보았듯 토큰당 대략 FLOPs를 수행하므로, 여기서는 대략 6 * 70e9 = 4.2e11 FLOPs / token이다. 토큰당 스텝당 약 0.5 TFLOP인 셈이다. compute-bound라고 가정하면, 완벽한 FLOPs 활용률 가정하에 단일 TPU v5p 칩에서 대략 4.2e11 / 4.59E+14 = 1ms가 걸린다.
질문: LLaMA 3은 약 15조 토큰으로 학습되었다. 총 몇 FLOPs인가?
정답 보기
정답: 쉽다. 그냥 4.2e11 * 15e12 = 6.3e24 FLOPs가 전부다. 6.3 yottaFLOPs. 정말 많다! 단일 TPU로는 6.3e24 / 4.59E+14 = 435 years가 걸린다. 이것도 정말 길다!
질문: 16x20x28 = 8960 칩으로 이루어진 TPU v5p pod 전체에서 학습하고 싶다고 하자. compute-bound라고 가정할 때, bfloat16에서 40% MFU로 학습하면 얼마나 걸릴까?
정답 보기
정답: TPU v5p 하나는 초당 4.59e14 FLOPs를 수행할 수 있다. 40% MFU에서는 약 T = 6.3e24 / (8960 * 4.59e14 * 0.4) = 3.8e6 seconds가 걸린다. 약 44일이다! 실제로 40% MFU를 달성할 수 있다고 가정하면 꽤 합리적인 수준이다.
질문: LLaMA 3-70B는 약 4M 토큰의 batch size로 사전학습되었다. 이 batch size로 학습하려면 최소 몇 개의 TPU가 필요할까? bfloat16 파라미터와 float32 optimizer state를 가정하고, 레이어당 gradient를 4번 checkpoint한다고 하자.
정답 보기
정답: 이 질문은 본질적으로 메모리 사용량을 묻는 것이다. 가용 연산량에 대한 유일한 엄격한 제약이 메모리이기 때문이다. 학습 중 HBM의 주된 용도는 세 가지다: 모델 파라미터, optimizer state, gradient checkpoint. bfloat16 weight, float32 optimizer state, 그리고 아주 보수적인 gradient checkpointing 방식(레이어당 4번)을 가정하면:
| 항목 | 계산 | 용량 |
|---|---|---|
| Params | 2 * 70GB | ~140GB |
| Optimizer State | 8 * 70GB | ~560GB |
| Gradient Checkpoints | 2 * 8192 * 4e6 * 4 * 80 | ~20.9TB |
| 합계 | ~21.6TB |
총합은 약 21.6TB다. 아주 보수적인 checkpointing 방식인데도 gradient checkpoint가 메모리 그림을 강하게 지배한다. 기술적으로는 레이어당 checkpoint 1개까지 줄이거나 microbatching을 할 수도 있지만, 이 정도면 합리적인 그림이다. 이 가정하에서 TPU v5p 하나당 HBM이 96GB이므로 21.6e12 / 96e9 = 225개의 TPU가 필요하다. 사실 그렇게 많지 않다!
그런데 왜 이렇게 하지 않을까? 학습에 44 days * 8960 / 225 = 1752 days가 걸리기 때문이다. 거의 5년이다. 너무 길다. 그래도 이 계산은 대형 클러스터를 쓰는 이유가 메모리에 발목 잡혀서가 아니라 FLOPs가 더 필요해서라는 점을 분명히 보여 준다.
질문: 위 질문과 같은 가정에서, 8960개의 TPU v5p 칩을 쓴다면 칩당 메모리를 얼마나 쓰게 될까?
정답 보기
정답: 총 메모리는 여전히 약 21.6TB이므로 칩당 약 2.4GB를 쓰게 되는데 사실상 없는 것이나 다름없다. 훨씬 공격적인 checkpointing, 예컨대 레이어당 checkpoint 12개를 쓰더라도 칩당 8GB에 불과하다. 이 규모에서는 학습 중 memory-bound가 되는 것과는 거리가 한참 멀다.
요점(Takeaways): 기술적으로는 아주 큰 모델도 아주 작은 topology에서 학습할 수 있다. 다만 시간이 오래 걸릴 가능성이 높다는 단서가 붙는다. 학습 런의 총 FLOPs를 계산해 두면 적당한 MFU와 알려진 topology를 가정해 학습 시간을 어림잡을 수 있다.
LLaMA 3-70B를 학습용으로 sharding하는 법
위 설정을 그대로 유지해서 4M 토큰 batch size(배치당 길이 4096짜리 시퀀스 1024개)로 LLaMA 3-70B를 8960칩 TPU v5p pod에서 학습하고 싶다고 하자. 이 모델에 가장 좋은 sharding 전략이 무엇인지 논의해 보자.
질문: 위 가정에서 FSDP만으로 이 모델을 학습할 수 있을까? 우선 sequence/context parallelism은 전혀 할 수 없다고 하자. 이게 가장 먼저 떠올려야 할 아이디어다. 단순하고, 잘 동작한다면 추가 통신이 전혀 생기지 않기 때문이다.
정답 보기
정답: 다소 깐깐하게 따지는 답이 될 것이다. 위에서 언급했듯 LLaMA 3-70B는 처음에 길이 4K 시퀀스로 학습되므로, 4M 토큰 batch size는 시퀀스 batch size로 치면 1024가 된다. 즉 순수한 data parallelism/FSDP는 사실상 1024개 칩까지만 가능하다. data parallelism을 적용할 시퀀스가 그만큼밖에 없기 때문이다. 따라서 “추가 통신이 없는 완전한 data parallelism”이라는 단순한 의미로는 답이 ‘아니오’다. 다음 질문에서 조금 덜 깐깐한 버전에 답해 본다.
질문: sequence sharding을 하지 않는다는 요구 조건을 완화해 보자. batch 축과 sequence 축 모두에 걸쳐 FSDP를 할 수 있다면, 8960개 칩에서 FSDP만으로 LLaMA 3-70B를 학습할 수 있을까?
정답 보기
정답: 이제 sequence/context parallelism까지 허용되므로 훨씬 더 크게 확장할 수 있다. 먼저 디바이스당 batch size를 계산해 보자. 8960-way FSDP를 하면 TPU당 batch size는 4 * 1024 * 1024 / 8960 = 468 tokens가 된다. 앞 장에서 보았듯 이면 FSDP는 ICI-bound가 된다. 완전한 3D pod이므로 여기에 3개 축을 쓸 수 있고, 그러면 하한은 850이 되는데 우리는 그보다 한참 아래다. 따라서 답은 ‘아니오’다. 축 3개를 써도 안 된다. 확실하게 communication-bound가 된다.
질문: 이제 tensor parallelism과 FSDP를 섞는 경우를 보자. compute-bound를 유지할 수 있는 조합이 존재할까? 존재한다면 FSDP와 tensor parallelism을 각각 얼마나 해야 할까?
정답 보기
정답: 먼저 이게 애초에 가능한지부터 확인하자. 칩당 batch size가 보다 작으면 comms-bound가 된다는 것을 알고 있다. 위에서 보았듯 우리는 이보다 약간 위에 있다. 다행이다! 이제 최적의 FSDP 양을 고르는 데는 다음 공식을 쓰면 된다
적당한 2의 배수로 반올림하면 대략 2048-way FSDP와 4-way tensor parallelism이 된다. 이 조합이면 잘 동작할 것이다!
요점(Takeaways): data parallelism(1024-way), sequence parallelism(2-way), tensor parallelism(4-way)을 조합하면 communication-bound가 되지 않으면서 4M 토큰 batch size로 LLaMA-3를 TPU v5p pod 전체에서 학습할 수 있다. 순수 FSDP나 FSDP + sequence parallelism으로 하려고 하면 comms-bound가 된다. 앞 장에서 만들어 낸 수식들은 이렇게나 실용적이다.
연습 문제
문제 1 [LLaMA 70B를 더 많은 칩으로 확장하기]: 같은 batch size로 LLaMA 3-70B를 pod 4개에서 학습하고 싶다고 하자. 어떤 parallelism 방식을 쓰겠는가? compute-bound인가 communication-bound인가? 학습에는 대략 얼마나 걸릴까? 올바른 roofline bound를 쓰도록 주의하라.
문제 2 [LLaMA 405B]:
(a) LLaMA 3-405B config(gated 모델이라 보려면 로그인해서 접근 권한을 요청해야 할 수 있다)를 이용해, 위에서처럼 핵심 하이퍼파라미터를 모두 담은 표를 작성하라. 이 모델의 총 파라미터 수는 몇인가? 학습 스텝당 FLOPs는 몇인가? 15T 토큰으로 학습하면 총 몇 FLOPs를 수행하는가?
(b) TPU v5p pod 8개에서 학습하고 싶다고 하자. 어떤 parallelism 방식을 쓰겠는가? 학습에는 얼마나 걸릴까? compute-bound인가 comms-bound인가?
6부는 여기까지! Transformer 추론을 다루는 7부는 여기에서 볼 수 있다.