Transformer로 추론을 수행하는 것은 학습과 사뭇 다를 수 있다. 부분적으로는 추론이 고려해야 할 새로운 요소를 하나 더하기 때문이다: latency다. 이 장에서는 모델에서 새 토큰 하나를 샘플링하는 것부터, 추론 엔진의 일부로서 대형 Transformer를 여러 가속기 slice에 걸쳐 효율적으로 확장하는 것까지 전 과정을 다룬다.
Transformer 추론의 기초
Transformer를 학습시켰으니 이제 그걸로 새로운 시퀀스를 생성하고 싶다고 하자. 결국 벤치마크 점수가 오르고 loss 곡선이 내려가는 것은, 실전에 투입했을 때 뭔가 흥미로운 일이 벌어질지를 가늠하는 대리 지표일 뿐이다!1
샘플링은 개념적으로 단순하다. 시퀀스를 넣으면 우리의 사랑스러운 Transformer가 , 즉 가능한 모든 다음 토큰에 대한 로그 확률을 뱉어낸다. 이 분포에서 샘플링하면 새 토큰 하나를 얻는다. 이 토큰을 덧붙이고 과정을 반복하면 프롬프트의 연속인 토큰 시퀀스를 얻는다.
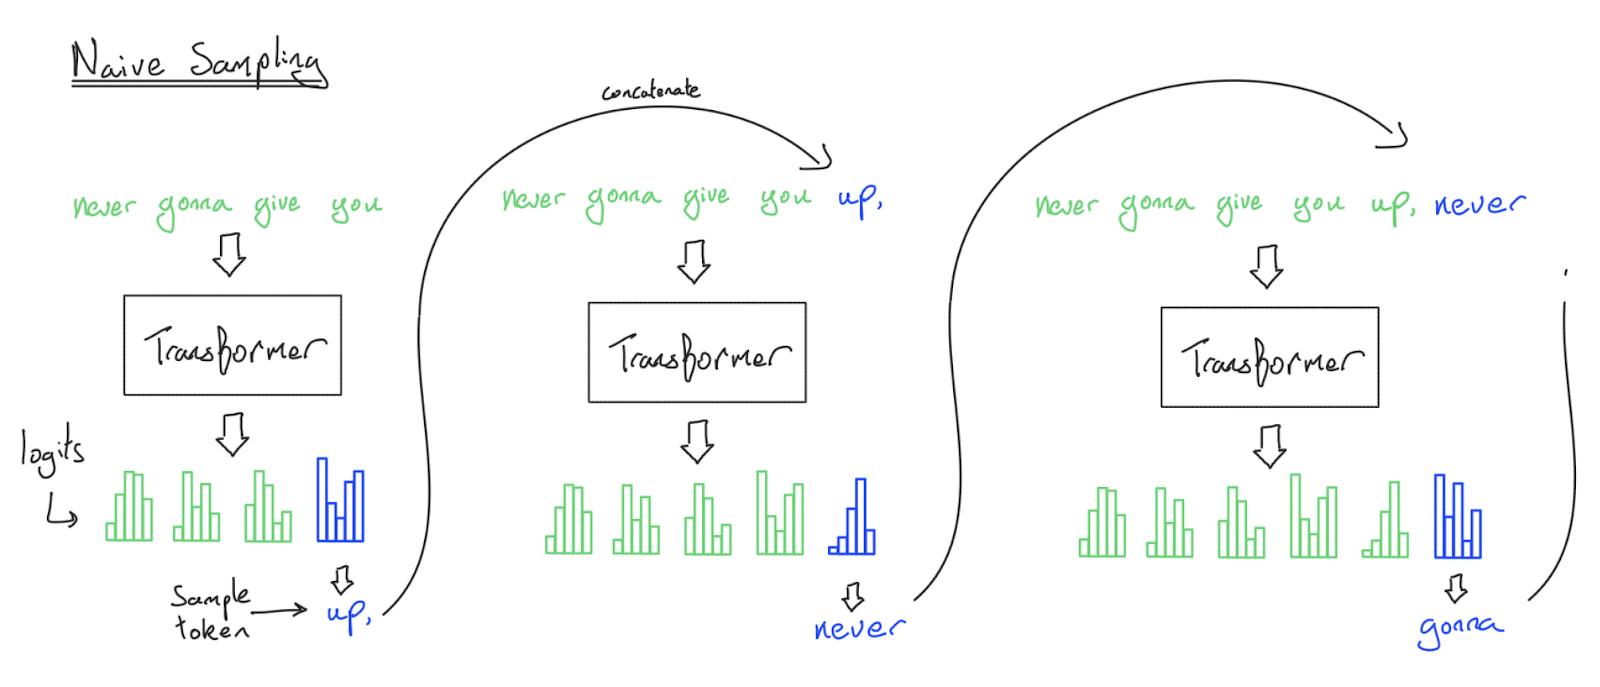
그림: Transformer에서의 나이브한 샘플링. 파란색 logits가 다음 토큰에 대한 분포를 주고, 여기서 샘플링할 수 있다. 각 스텝이 전체 prefix를 다시 처리하므로 알고리즘의 실행 시간이 이 된다는 점에 주목하라.
방금 설명한 것이 Transformer 샘플링의 나이브한 구현인데, 동작하긴 하지만 실전에서는 절대 이렇게 하지 않는다. 토큰을 하나 생성할 때마다 전체 시퀀스를 다시 처리하기 때문이다. 이 알고리즘은 개의 토큰을 생성하는 데 FFW에서 , attention 메커니즘에서 이다!
어떻게 피할까? 매번 전체 forward pass를 도는 대신, 각 forward pass의 중간 activation 일부를 저장해 두면 이전 토큰을 다시 처리하지 않아도 된다는 사실이 알려져 있다. 구체적으로, dot-product attention에서 주어진 토큰은 이전 토큰들에만 attend하므로, 각 토큰의 key와 value projection을 KV cache라는 새로운 자료구조에 써 두기만 하면 된다. 과거 토큰들의 key/value projection을 한 번 저장해 두면, 이후 토큰들은 이전 토큰에 대해 새로운 FLOPs를 전혀 쓰지 않고 자신의 곱만 계산하면 된다. 놀랍지 않은가!
이를 염두에 두면 추론은 두 가지 핵심 부분으로 나뉜다:
- Prefill: 긴 프롬프트가 주어지면 프롬프트의 모든 토큰을 동시에 처리하고, 그 결과 activation(구체적으로는 key-value projection)을 **“KV cache”**에 저장한다. 마지막 토큰의 logits도 저장한다.
- Generation: KV cache와 직전 logits가 주어지면, logits에서 토큰 하나를 점진적으로 샘플링하고, 그 토큰을 다시 Transformer에 넣어 다음 스텝을 위한 새로운 logits를 만든다. 새 토큰의 KV activation도 KV cache에 덧붙인다. 특별한
<EOS>토큰을 만나거나 최대 길이 제한에 도달할 때까지 이를 반복한다.
KV cache를 이용한 샘플링의 다이어그램은 다음과 같다:
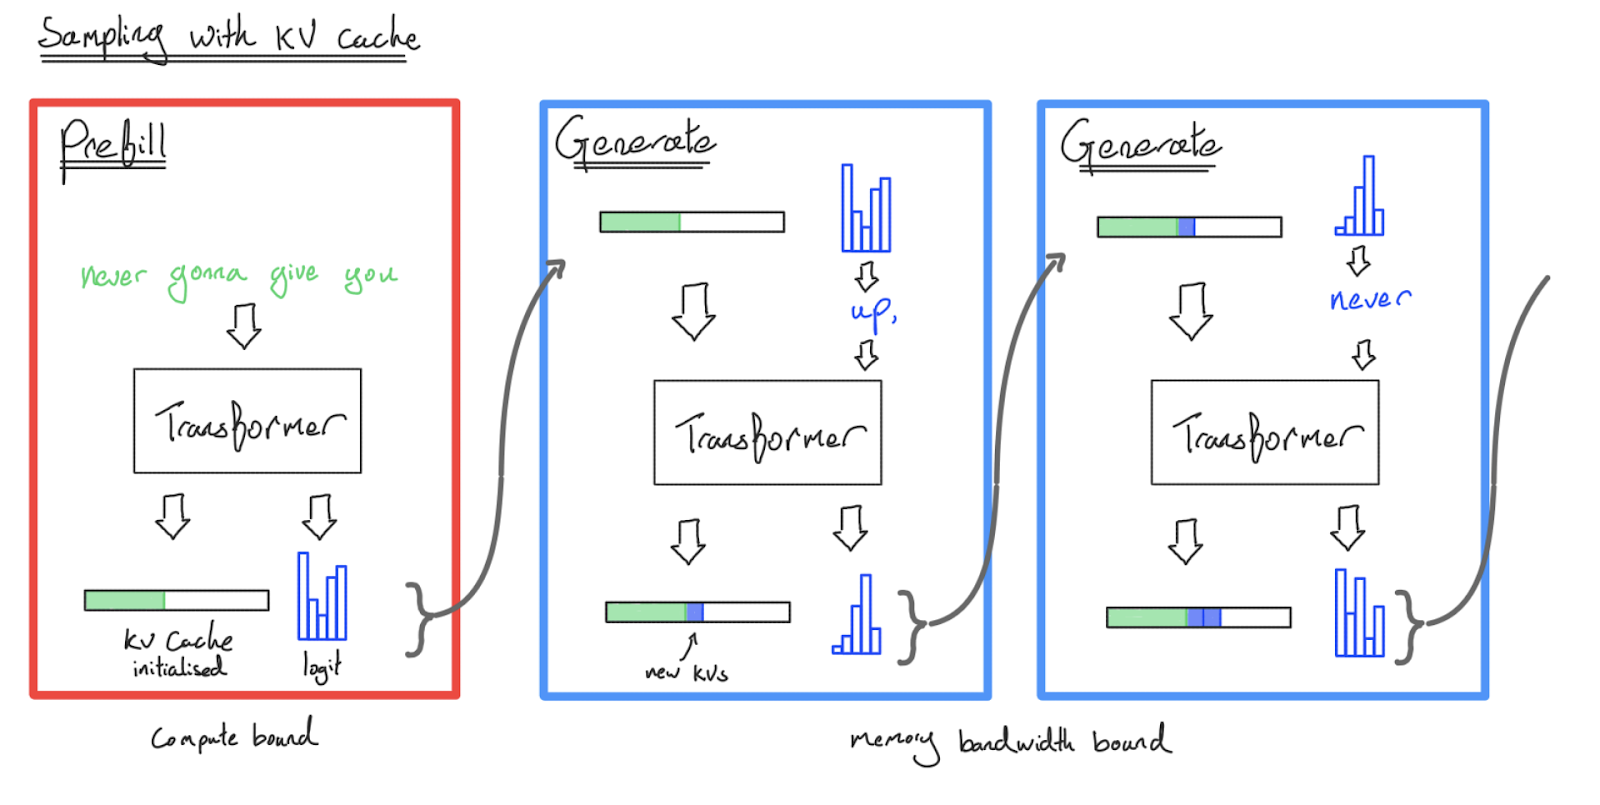
그림: KV cache를 이용한 효율적인 Transformer 샘플링의 다이어그램. Prefill은 프롬프트를 처리하고 토큰별 key-value activation을 전부 cache에 저장한다. Generation은 이 cache(와 마지막 토큰의 logits)를 받아 새 토큰을 샘플링하고, 그 토큰을 모델에 통과시키며 KV cache에 attend하고 새 토큰의 key-value projection을 cache에 다시 저장한다. MLP 블록 기준으로 알고리즘이다.
KV cache로 샘플링하면 개 토큰을 생성하는 시간 복잡도가 FFW에서 , attention에서 로 줄어든다. 이전 토큰을 다시 처리하는 일이 없기 때문이다. 그래도 시퀀스 하나를 생성하려면 여전히 많은 forward pass가 필요하다 — Gemini나 ChatGPT에 질의하면 결과가 스트리밍되어 돌아오는 동안 벌어지는 일이 바로 이것이다. 모든 토큰 하나하나가 (대개) 거대한 모델에 대한 별도의 (하지만 부분적으로 cache된) Transformer 호출이다.
곧 보겠지만 prefill과 generation은 아주 다른 짐승이다 — Transformer 추론은 사실 두 개의 과제가 하나로 위장한 것이다! 학습과 비교하면 KV cache 또한 새롭고 중요한 복잡성의 원천이다.
우리가 실제로 최적화하려는 것은 무엇인가?
더 나아가기 전에, 추론에서 완전히 새로운 측면 하나를 짚어 둘 필요가 있다: latency다. 학습 중에는 throughput(칩당 초당 처리 토큰 수)만 신경 쓰면 되지만, 추론 중에는 토큰을 얼마나 빨리 만들어내는지(**Time To First Token(TTFT)**과 토큰당 latency 둘 다)를 걱정해야 한다. 예를 들어:
- eval과 데이터 생성을 위한 오프라인 배치 추론은 추론의 총비용만 중요하고 개별 샘플의 latency에는 무관심하다.
- 챗 인터페이스/스트리밍 작업은 대규모에서 저렴하게 돌아가면서도 TTFT가 낮아야 하고, 사람의 읽는 속도를 넘어설 만큼 빠르게 토큰을 생성해야 한다.
- 엣지 추론(예: 노트북에서 도는
llama.cpp)은 한 번에 한 사용자만, 가능한 가장 낮은 latency로 서비스하면 되며, 하드웨어 제약이 심할 수 있다.
하드웨어 활용률을 극대화하는 것은 여전히 결정적이고 비용과 TTFT에 도움이 되지만, 학습과 달리 모든 맥락에서 개별 사용자의 경험 개선으로 반드시 이어지지는 않는다. 가속기, 시스템, 모델 아키텍처 수준의 많은 최적화가 latency, throughput, context 길이, 심지어 모델 품질 사이에서 트레이드오프를 만든다.
Transformer를 더 세분화해서 보기
지금까지는 Transformer를 대체로 feedforward 블록의 더미로 취급해 왔다. FLOPs와 메모리 관점에서는 이걸로 충분한 경우가 많지만, 추론을 제대로 모델링하기에는 부족하다.2 4장에서 봤듯이 Transformer forward pass의 주요 구성 요소는 다음과 같다:
- 여러 선형 연산들. MLP(, )와 attention의 QKV projection 및 output projection(, , , )이 여기에 든다. 모두 HBM에서 파라미터와 activation 배치를 읽고, FLOPs를 좀 수행하고, 결과를 HBM에 다시 쓰는 일이다.
- Dot-product attention. HBM에서 key-value projection 배치와 query activation 배치를 읽고, 내적 몇 번과 softmax 연산을 좀 하고, attention 결과를 HBM에 다시 써야 한다.
- 그 밖의 모든 것. layer norm 적용, activation 함수, 토큰 샘플링, KV cache 갱신, positional embedding 등이다. FLOPs가 좀 들긴 하지만 위 연산들에 지배되거나 그 안으로 fuse된다.
다음 몇 개 절에서는 이들 각각을 prefill과 generation의 맥락에서 보며 무엇이 성능의 병목이 될지 물을 것이다. 단일 가속기 안에서는 compute-bound인가 memory-bound인가? prefill과 generation에서 그 답이 얼마나 다른지 강조하고 싶다.
선형 연산: 무엇이 병목인가?
모든 선형 연산은 MLP 블록에 있든 attention에 있든 개념적으로 같다. 그 arithmetic intensity는 batch size에 달려 있다. 1장에서 이미 한 계산이지만 반복할 가치가 있다. 배치와 행렬의 단일 행렬 곱셈을 보자. 큰 MLP 블록( 또는 )일 수도 있고 더 작은 attention projection(, , , ) 중 하나일 수도 있다. 이 matmul을 하려면 두 배열을 HBM에서 MXU로 로드하고, 곱셈을 수행하고, 결과를 HBM에 다시 써야 한다. 이전처럼:
TPU나 GPU는 연산을 하면서 로드를 겹칠 수 있으므로, compute-bound가 되려면 , 즉:
이어야 한다. 우변은 하드웨어의 arithmetic intensity다. 이제 와 가 에 비해 매우 크다고 가정하면(보통 배치는 많아야 500이고 와 다), 라는 사실을 이용해 분모를 단순화해 다음을 얻는다:
weight를 quantize하거나 행렬 곱셈에 더 낮은 정밀도의 FLOPs를 쓰면 이 임계 batch size는 달라진다. 예를 들어 weight를 int8이나 fp8로 quantize하면 는 2배 줄어든다. FLOPs를 int8이나 fp8로 수행하면 는 2배 늘어난다. 따라서 , 로 두면 임계 batch size는 사실 이다.
요점(Takeaway): Transformer의 matmul이 compute-bound인 것은 replica당 토큰 batch size가 보다 클 때, 그리고 오직 그때뿐이다. TPU v5e에서 bf16 activation이면 240 토큰이다. H100이라면 약 280 토큰이다.
학습 중에는 같은 weight를 아주 큰 배치에 재사용하므로 모든 행렬 곱셈에서 intensity가 높다. 이 높은 arithmetic intensity는 prefill에도 그대로 이어지는데, 사용자 프롬프트가 보통 수백에서 수천 토큰에 이르기 때문이다. 앞서 봤듯 TPU v5e의 하드웨어 arithmetic intensity는 240이므로, 이 하드웨어에서 bf16으로 도는 dense 모델에 240 토큰보다 긴 시퀀스가 들어오면 compute-bound가 될 것으로 기대되고, 만사형통이다. 이보다 짧은 프롬프트도 기술적으로는 함께 배치해 활용률을 높일 수 있지만 보통 그럴 필요는 없다.
요점(Takeaway): prefill 중에는 모든 행렬 곱셈이 기본적으로 항상 compute-bound다. 따라서 하드웨어 활용률, 즉 MFU(Model FLOPs Utilization)를 극대화하는 것만으로 칩당 throughput(비용)과 latency(TTFT 형태의)를 극대화하기에 충분하다. 프롬프트가 극단적으로 짧지 않은 한, 프롬프트 단위의 batching은 prefill throughput의 작은 개선을 대가로 latency만 더할 뿐이다.
그러나 generation 중에는 스텝 사이에 순차적 의존성이 있어 요청마다 forward pass를 한 번에 한 토큰씩만 할 수 있다! 따라서 여러 요청을 함께 배치해 배치 차원으로 병렬화해야만 (쉽게) 좋은 활용률을 달성할 수 있다. 뒤에서 더 이야기하겠지만, latency에 영향을 주지 않으면서 많은 동시 요청을 실제로 배치하는 것은 어렵다. 그래서 generation으로 하드웨어 FLOPs를 포화시키기는 훨씬 어렵다.
요점(Takeaway): generation 중에 선형/feed-forward 연산에서 compute-bound가 되려면 총 토큰 batch size가 (TPU v5e의 bf16 파라미터 기준 240)보다 커야 한다. generation은 토큰 단위로 순차적으로 일어나므로 여러 요청을 함께 배치해야 하는데, 이것이 어렵다!
이 수치가 얼마나 큰지 짚어 둘 만하다! generation batch size 240이란 240개의 요청이 동시에 생성 중이고, dense 모델이라면 KV cache도 240개 따로라는 말이다. 그래서 일부 벌크 추론 환경을 제외하면 실전에서 달성하기 어렵다. 반면 prefill에서 240 토큰 이상을 밀어 넣는 것은 꽤 일상적이다. 다만 sparsity가 커질수록 어느 정도 주의가 필요하다.
이 정확한 숫자는 quantization의 종류와 하드웨어에 따라 달라진다는 점에 유의하라. 가속기는 낮은 정밀도에서 더 많은 연산을 공급하는 경우가 많다. 예를 들어 파라미터는 int8인데 연산을 bf16으로 하면 임계 batch size는 120으로 떨어진다. activation과 파라미터가 모두 int8이면, TPU v5e가 int8 x int8을 400 TOPs/s로 공급할 수 있으므로 다시 240으로 튀어 오른다.
Attention은 어떤가?
dot-product attention 연산으로 가면 이야기가 더 복잡해진다. 특히 KV cache를 감안해야 하기 때문이다. 순수한 multi-headed attention의 attention head 하나만 보자. 단일 Flash Attention fusion에서는3:
- shape 인 activation을 HBM에서 읽는다.
- 텐서 한 쌍인 cache를 HBM에서 읽는다.
- matmul에서 FLOPs를 수행한다. Flash Attention 덕분에 attention 행렬을 HBM에 다시 쓸 필요는 없다.
- attention matmul에서 를 수행한다.
- 결과로 나온 텐서를 HBM에 다시 쓴다.
모두 합치면:
prefill에서는 self-attention이므로 이고, 따라서 로 단순화된다. **prefill 중 attention의 arithmetic intensity가 **라는 뜻이니 좋은 소식이다. attention에서 compute-bound가 되기는 꽤 쉽다. 시퀀스 길이가 어느 정도만 길면 문제없다!
하지만 generation은 시퀀스 차원이 자명하고(trivial), 와 차원이 소거되므로 다음 근사를 쓸 수 있다:
나쁜 소식이다. generation 중에는 attention의 arithmetic intensity를 개선하기 위해 할 수 있는 일이 아무것도 없다. 거대한 KV cache를 로드하면서 아주 적은 양의 FLOPs만 수행하고 있는 것이다. 그래서 attention에서는 기본적으로 항상 memory bandwidth-bound다!
요점(Takeaway): prefill 중 attention은 웬만한 시퀀스 길이(대략 토큰)라면 대개 compute-bound인 반면, generation 중에는 arithmetic intensity가 낮고 상수이므로 항상 memory bandwidth-bound다.
개념적으로 왜 그럴까? 모델의 선형 부분에서 compute-bound가 되는 주된 이유는, 파라미터(메모리 bandwidth를 많이 먹는 구성 요소)가 많은 배치 원소에 재사용되기 때문이다. 그러나 KV cache는 배치 원소마다 따로 있으므로 batch size가 커지면 KV cache도 늘어난다. 아키텍처를 공격적으로 손보지 않는 한 여기서는 거의 항상 memory-bound가 된다.
파라미터 메모리가 KV cache 메모리와 비슷해지는 순간부터는 batch size를 늘려도 throughput의 수익이 체감한다는 말이기도 하다. 수익 체감이 얼마나 아픈지는 시퀀스 하나 기준 파라미터 대 KV cache 바이트의 비율, 즉 대략 비율에 달려 있다. 이므로 대략 대 (시퀀스 길이)의 비율에 의존한다. KV cache를 작게 만드는 아키텍처 수정에도 좌우된다(잠시 뒤 더 말한다).
LLM latency와 throughput의 이론적 추정
이 계산으로부터, 최적화할 때 목표로 삼을 만한 스텝 시간의 꽤 좋은 한계를 얻을 수 있다. (주의: 독자가 이 장 전체에서 단 하나만 가져가야 한다면 바로 다음 내용이다.) generation 중 batch size가 작을 때(흔한 경우), attention과 MLP 블록 모두에서 memory bandwidth bound라고 가정하면 스텝당 latency의 하한이 잡힌다:
마찬가지로 throughput은:
결국 batch size가 커지면 FLOPs가 파라미터 로딩을 지배하기 시작하므로, 실전에서는 더 일반적인 다음 식을 쓴다:
여기서 attention 항(왼쪽)은 결코 compute-bound가 되지 않으므로 FLOPs roofline이 필요 없다. 이 식들은 어림 계산에 꽤 유용하다. 예를 들어:
깜짝 퀴즈: TPU v5e 4x4 slice에서 30B 파라미터 dense 모델로, int8에 bf16 FLOPs, 8192 context, 토큰당 100 kB의 KV cache라는 조건으로 batch size 4 토큰의 generate 스텝을 밟고 싶다고 하자. 이 연산의 latency에 대한 합리적인 하한은 얼마인가? 256 토큰 배치를 샘플링하고 싶다면?
정답 보기
정답: int8이면 파라미터는 30e9 바이트를 쓰고, 주어진 스펙에서 KV cache는 각각 100e3 * 8192 = 819MB를 쓴다. 칩은 16개이고, 각각 8.2e11 bytes/s의 bandwidth와 1.97e14 bf16 FLOPs/s를 가진다. batch size가 작으므로 위 식에서 스텝 시간은 최소 (4 * 819e6 + 30e9) / (16 * 8.2e11) = 2.5 ms로 기대된다. 256 토큰이라면 MLP 블록이 확실히 compute-bound 영역에 들어가므로, 스텝 시간은 대략 (256 * 819e6) / (16 * 8.2e11) + (2 * 256 * 30e9) / (16 * 1.97e14) = 21ms가 된다.
보다시피 여기에는 throughput과 latency 사이의 명확한 트레이드오프가 있다. 작은 배치는 빠르지만 하드웨어를 잘 활용하지 못한다. 큰 배치는 느리지만 효율적이다. 다음은 몇몇 구형 PaLM 모델에 대해 계산한 latency-throughput Pareto frontier다(ESTI 논문, Pope et al. 2022에서 가져옴):
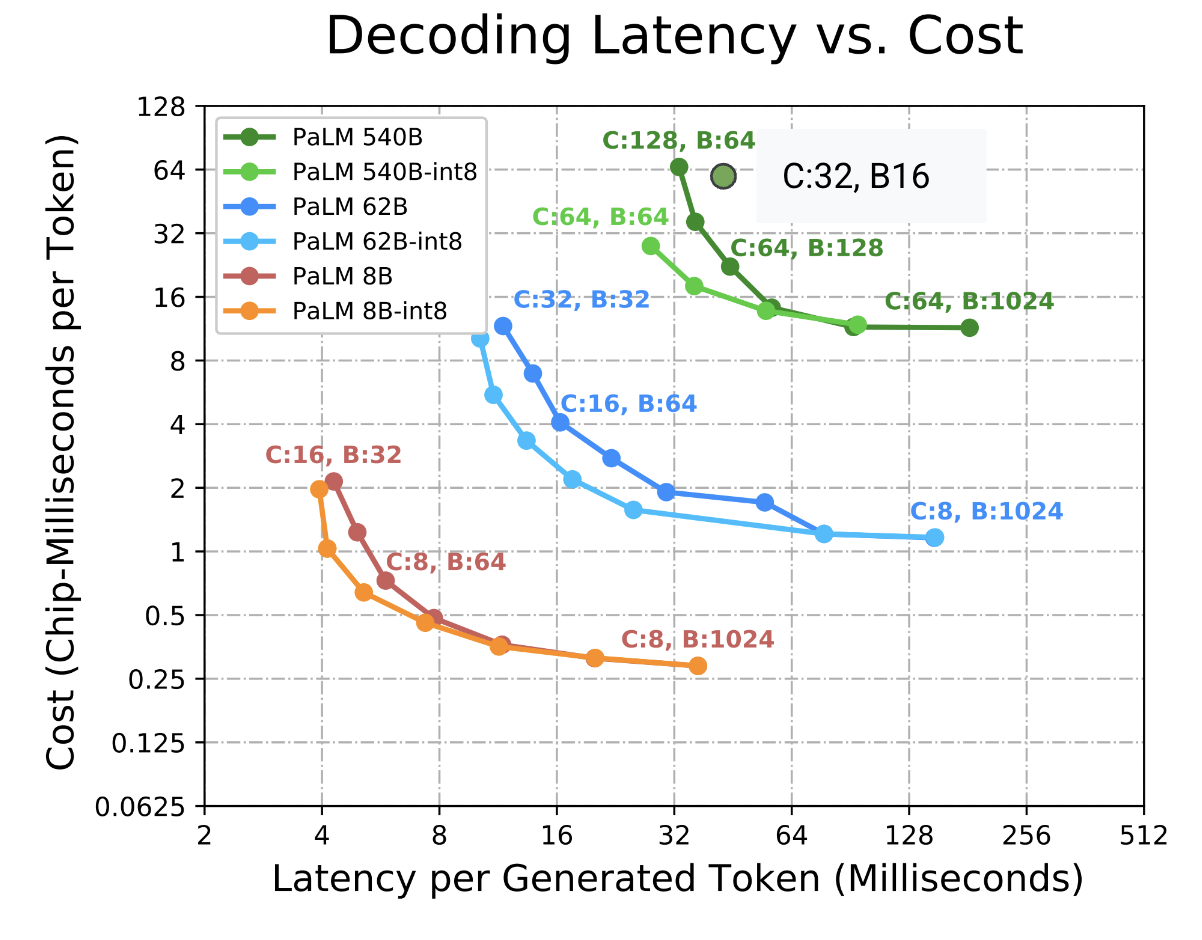
batch size라는 손잡이로 latency와 throughput을 맞바꿀 수 있을 뿐 아니라, HBM에 제약을 받는 상황이라면 더 큰 배치를 담기 위해 작은 토폴로지보다 큰 토폴로지를 선호할 수도 있다. 다음 장에서 이를 더 자세히 살핀다.
요점(Takeaway): generation throughput이 중요하다면 가능한 한 가장 큰 칩당 batch size를 써라. TPU arithmetic intensity(, 보통 120 또는 240)를 넘는 칩당 batch size라면 어느 값이든 throughput을 극대화한다. 이를 달성하기 위해 토폴로지를 키워야 할 수도 있다. batch size를 줄이면 throughput을 희생하는 대신 latency를 개선할 수 있다.
하드웨어 관점에서 몇 가지 단서가 있다. 자세히 보기
이건 모두 꽤 이론적인 이야기다. 실전에서는 몇 가지 이유로 뚜렷한 roofline이 잘 보이지 않는 경우가 많다:
- HBM 읽기가 FLOPs와 완벽하게 겹쳐진다는 가정은 현실적이지 않다. 컴파일러(XLA)는 실수를 저지를 수 있기 때문이다.
- sharding된 모델에서는 XLA가 model-sharded 행렬 곱셈의 ICI 통신을 FLOPs 자체와 효율적으로 겹치는 데 실패하는 일도 잦아서, 를 넘으면 선형 연산에서 latency 손해를 보기 시작하는 경우가 많다.
- 이론적 roofline보다 큰 batch size에서도 불완전한 겹침 때문에 throughput이 조금은 더 개선된다. 그래도 좋은 휴리스틱이다.
메모리는 어떤가?
지금까지 bandwidth와 FLOPs는 좀 들여다봤지만 메모리는 아직이다. 새 자료구조인 KV cache 덕분에 추론 시점의 메모리 그림은 사뭇 다르다. 이 절에서는 실제 모델(LLaMA 2-13B) 하나를 골라 상황이 얼마나 달라 보이는지 시연해 보자:
| hyperparam | value |
|---|---|
| L (num_layers) | 40 |
| D (d_model) | 5,120 |
| F (ffw_dimension) | 13,824 |
| N (num_heads) | 40 |
| K (num_kv_heads) | 40 |
| H (qkv_dim) | 128 |
| V (num_embeddings) | 32,000 |
추론 중 메모리를 쓰는 것은 무엇일까? 당연히, 파라미터다. 세어 보면:
| param | 공식 | 크기 (bytes) |
|---|---|---|
| FFW 파라미터 | d_model2 x ffw_multiplier x 3 (SwiGLU gate·up·down projection) x n_layers | 5,120 x 5,120 x 2.7 x 3 x 40 = 8.5e9 |
| Vocab 파라미터 | 2 (input과 output embedding) x n_embeddings x d_model | 2 x 32,000 x 5,120 = 0.3e9 |
| Attention 파라미터 | [2 (q와 output) x d_model x n_heads x d_qkv + 2 (k와 v) x d_model x n_kv_heads x d_qkv] x n_layers | (2 x 5,120 x 40 x 128 + 2 x 5,120 x 40 x 128) x 40 = 4.2e9 |
이 파라미터들을 더하면 8.5e9 + 4.2e9 + 0.3e9 = 총 13e9 파라미터로, 기대와 정확히 일치한다. 앞 절들에서 봤듯 학습 중에는 파라미터를 bfloat16으로, optimizer 상태를 float32로 저장할 수 있다. 그러면 메모리를 약 100GB 쓴다. 수 TB를 쓰기도 하는 gradient checkpoint에 비하면 아무것도 아니다.
추론은 어떻게 다른가? 추론 중에는 파라미터 사본 하나를 저장한다. bfloat16이라 하자. 그러면 26GB를 쓴다 — 실전에서는 quantization으로 흔히 이보다 훨씬 잘한다. 추적할 optimizer 상태나 gradient는 없다. checkpoint(backward pass를 위해 activation을 들고 있는 것)를 하지 않으므로 activation footprint는 prefill4과 generate 모두에서 무시할 만하다. 8k 토큰을 prefill하면 activation 하나는 겨우 8,192 x 5,120 x 2 bytes = 80MB 정도의 메모리만 쓴다. 더 긴 prefill은 여러 개의 작은 forward pass로 쪼갤 수 있으므로 긴 context에서도 문제가 되지 않는다. generation은 그보다도 적은 토큰을 쓰므로 activation은 무시할 만하다.
주된 차이는 KV cache다. 모든 과거 토큰에 대한 key와 value projection으로, 크기의 상한은 오직 허용된 최대 시퀀스 길이뿐이다. 토큰에 대한 총 크기는
여기서 는 각 head의 차원, 는 KV head 수, 은 레이어 수이고, 2는 key와 value를 둘 다 저장하는 데서 나온다.
이건 아주 빠르게 커질 수 있다. batch size와 context 길이가 온건해도 그렇다. LLaMA-13B에서 8192 시퀀스 하나의 bf16 KV cache는
이것 단 4개면 파라미터의 메모리 사용량을 넘어선다! 분명히 해 두자면 LLaMA 2는 긴 context에서의 KV cache 크기에 최적화된 모델이 아니고(항상 이렇게 나쁜 것은 아니다 — LLaMA-3처럼 보통은 가 훨씬 작다), 그래도 이 예시는 시사하는 바가 있다. 메모리나 latency 추정에서 KV cache를 무시할 수 없다.
LLaMA 2-13B의 throughput과 latency 모델링
서로 다른 batch size에서 8xTPU v5e로 generation을 완벽하게 효율적으로 수행하려 하면 어떤 일이 벌어지는지, 앞서 최대 이론 throughput 조건으로 유도한 임계 batch size(240)까지 보자.
| Batch Size | 1 | 8 | 16 | 32 | 64 | 240 |
|---|---|---|---|---|---|---|
| KV cache 메모리 (GiB) | 6.7 | 53.6 | 107.2 | 214.4 | 428.8 | 1608 |
| 총 메모리 (GiB) | 32.7 | 79.6 | 133.2 | 240.4 | 454.8 | 1634 |
| 이론적 스텝 시간 (ms) | 4.98 | 12.13 | 20.30 | 36.65 | 69.33 | 249.09 |
| 이론적 throughput (tokens/s) | 200.61 | 659.30 | 787.99 | 873.21 | 923.13 | 963.53 |
8x TPU v5e는 128GiB의 HBM, 6.5TiB/s의 HBM bandwidth(각 0.82TiB/s), 1600TF/s의 연산을 제공한다.
이 모델에서는 batch size를 늘리면 throughput이 좋아지긴 하지만, 수익 체감이 빠르게 온다. batch size 16을 넘으면 OOM이 나고, 240 근처로 가려면 메모리가 한 자릿수 배 더 필요하다. 더 큰 토폴로지로 latency는 개선할 수 있지만, 칩당 throughput은 벽에 부딪혔다.
총 파라미터 수는 그대로 두되, 마법처럼 KV cache만 5배 작게 만들었다고 하자(예컨대 1:5 GMQA — 40개의 Q head가 8개의 KV head를 공유한다는 뜻이다. 자세한 내용은 아래 절에서 다룬다).
| Batch Size | 1 | 8 | 16 | 32 | 64 | 240 |
|---|---|---|---|---|---|---|
| KV cache 메모리 (GiB) | 1.34 | 10.72 | 21.44 | 42.88 | 85.76 | 321.6 |
| 총 메모리 (GiB) | 27.34 | 36.72 | 47.44 | 68.88 | 111.76 | 347.6 |
| 이론적 스텝 시간 (ms) | 4.17 | 5.60 | 7.23 | 10.50 | 17.04 | 52.99 |
| 이론적 throughput (tokens/s) | 239.94 | 1,429.19 | 2,212.48 | 3,047.62 | 3,756.62 | 4,529.34 |
KV cache가 작아져도 수익 체감은 여전히 있지만, 칩당 이론 throughput이 batch size 240까지 계속 올라간다. 64라는 훨씬 큰 배치를 담을 수 있고, latency도 모든 batch size에서 일관되게 좋다. latency, 최대 throughput, 최대 batch size가 전부 극적으로 개선된다! 실제로 이후의 LLaMA 세대들은 정확히 이 최적화를 채택했다 — LLaMA-3 8B는 query head 32개에 KV head 8개다(출처).
요점(Takeaway): 파라미터뿐 아니라 KV cache의 크기도 모델의 최종 추론 성능에 큰 영향을 미친다. 아키텍처 결정과 런타임 최적화의 조합으로 이를 통제해야 한다.
Generation throughput과 latency를 개선하는 기법들
원조 Attention is All You Need 논문 이후, 모델을 더 효율적으로 만드는 많은 기법이 개발되었고 그중 다수는 KV cache를 정면으로 겨냥한다. 일반적으로 KV cache가 작아지면 latency를 해치지 않으면서 generation 스텝의 batch size와 context 길이를 키우기 쉬워지고, Transformer를 둘러싼 시스템들(요청 caching 같은)의 삶도 편해진다. 품질에 미치는 영향을 무시하면 다음과 같은 것들이 있다:
Grouped multi-query attention(일명 GMQA, GQA): KV head 수를 줄이고, attention 메커니즘에서 이를 여러 Q head와 공유할 수 있다. 극단적으로는 KV head 하나를 모든 Q head와 공유하는 것도 가능하다. 순수 MHA 대비 KV cache를 Q:KV 비율만큼 줄이며, 모델 성능이 이 변경에 비교적 둔감하다는 것이 관찰되어 있다.
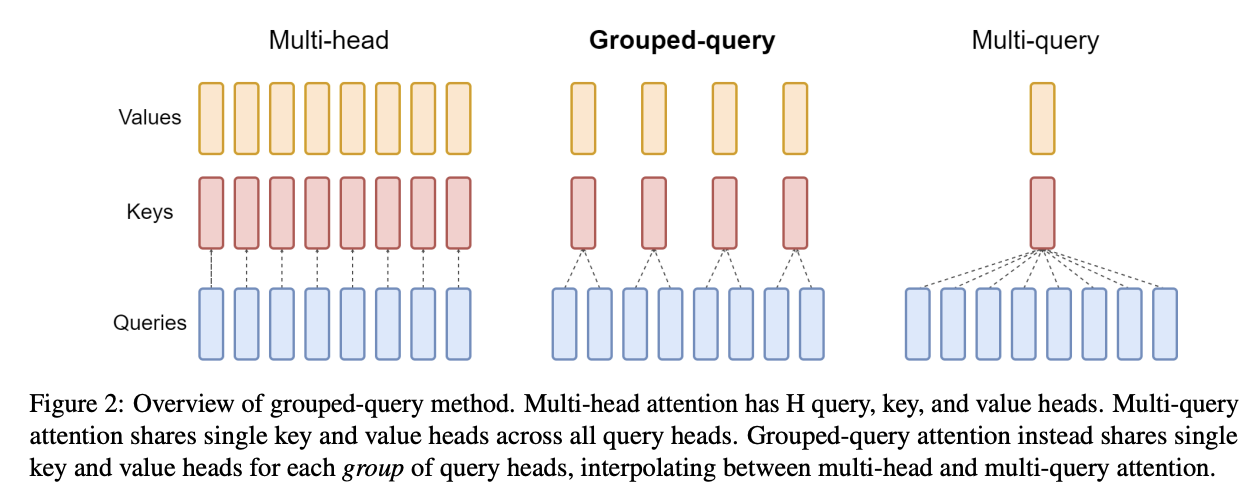
attention 연산의 arithmetic intensity를 실질적으로 높이는 효과도 있다(4장의 문제 4 참조).
Local attention 레이어 섞기: local attention은 context를 작거나 중간 크기의 최대 길이로 제한한다. 학습과 prefill 시점에는 attention 행렬을 삼각형 대신 대각선 띠(diagonal strip)로 마스킹하는 것이 되어 local 레이어의 KV cache 최대 길이를 실질적으로 제한한다. global 레이어 사이에 local 레이어를 얼마간 섞어 넣으면, local window보다 긴 context에서 KV cache 크기가 크게 줄어든다.
레이어 간 KV 공유: 모델이 일정한 패턴으로 레이어 간에 같은 KV cache를 공유하도록 학습할 수 있다. KV cache 크기가 줄어들고 batch size 증대·caching·오프라인 저장 등에서 이득이 있긴 하지만, 공유된 KV cache는 HBM에서 여러 번 읽어야 할 수 있어 스텝 시간이 반드시 좋아지는 것은 아니다.
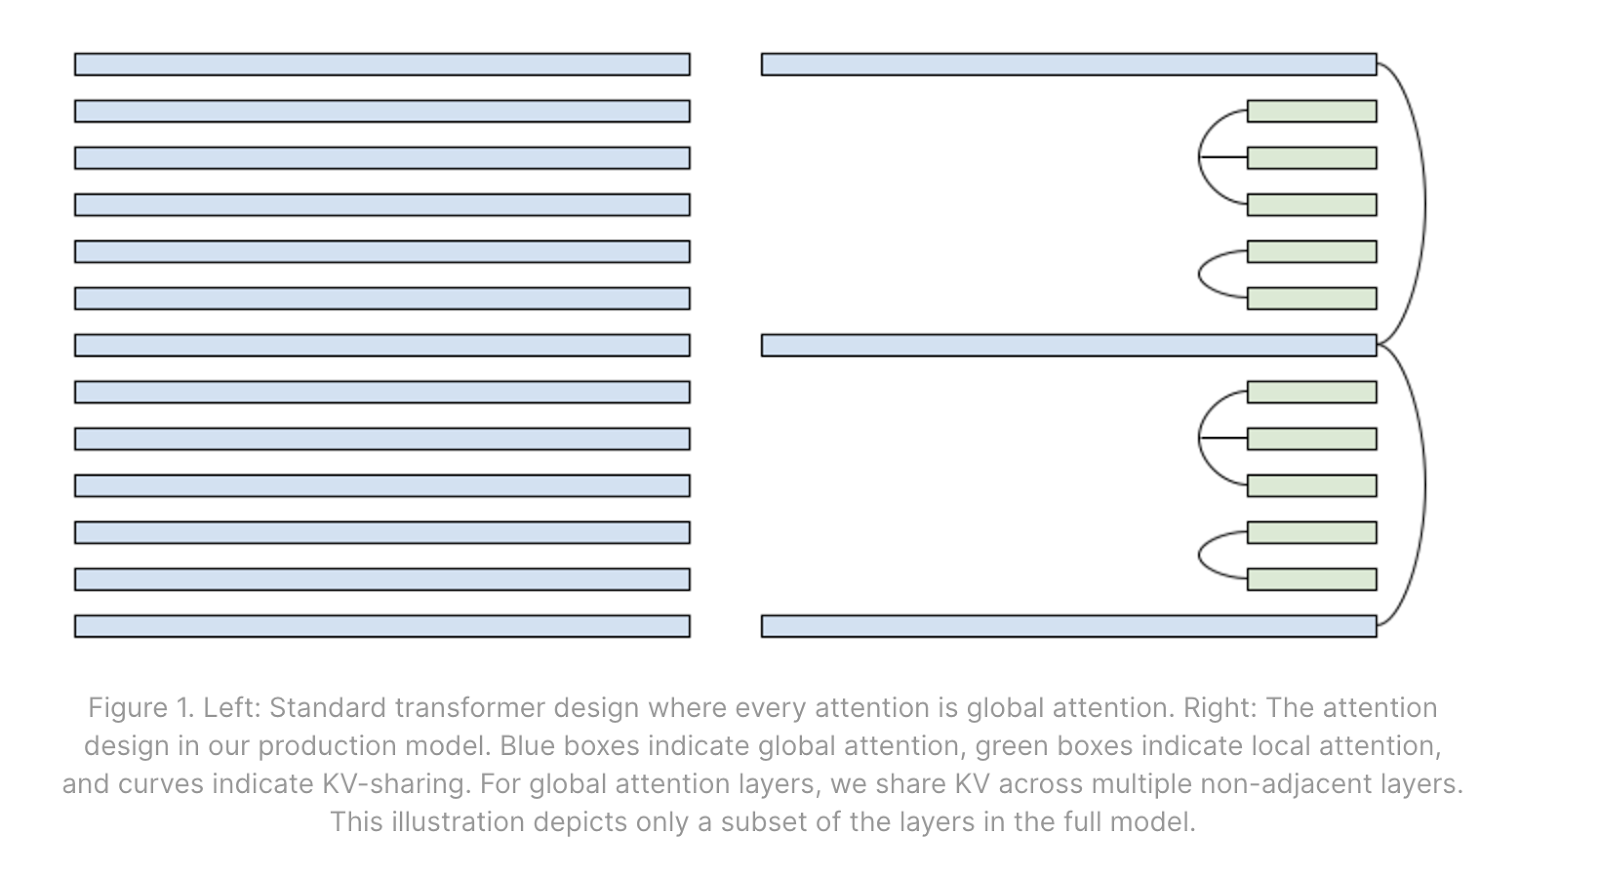
Quantization: 추론은 보통 파라미터와 KV의 정밀도에 덜 민감하다. 파라미터와 KV cache를 (예: int8, int4, fp8 등으로) quantize하면 양쪽 모두에서 메모리 bandwidth를 아끼고, compute roofline에 도달하는 데 필요한 batch size를 낮추고, 더 큰 batch size로 돌 수 있도록 메모리를 아낀다. quantization에는 모델이 quantization으로 학습되지 않았더라도 흔히 학습 후에 적용할 수 있다는 추가 장점이 있다.
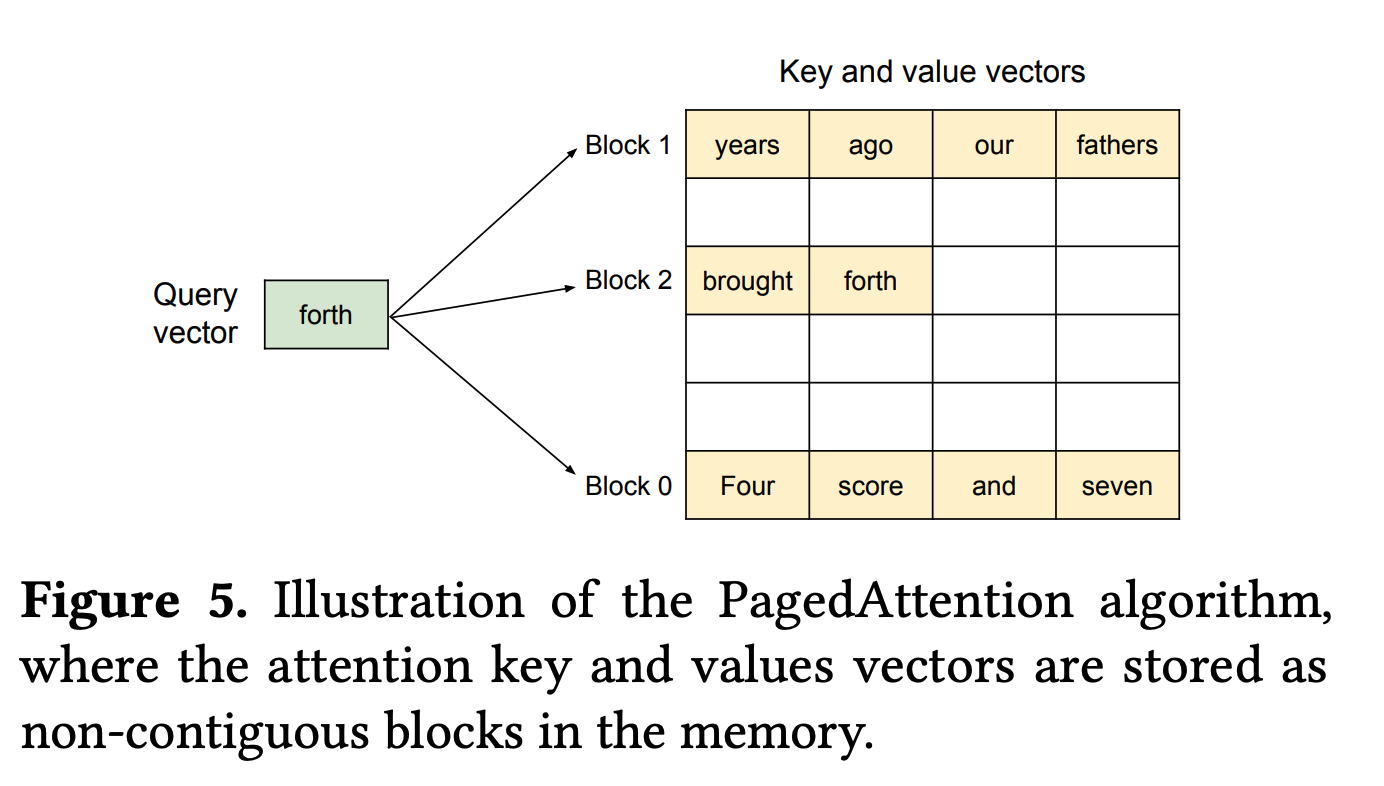
Ragged HBM 읽기와 Paged Attention 사용: 위 계산에서는 KV cache마다 8k의 context를 할당했지만, KV cache 전체를 메모리에서 읽을 필요는 없는 경우가 많다 — 요청의 길이 분포는 폭넓고 모델의 최대 context를 다 쓰지 않으므로, KV cache의 패딩이 아닌 부분만 읽는 kernel(예: Flash Attention 변형)을 구현할 수 있다.
Paged Attention(Kwon et al. 2023)은 이를 한 단계 더 다듬은 것으로, KV cache를 OS 스타일의 페이지 테이블에 저장하고 KV cache 패딩을 거의 완전히 피한다. 복잡성이 많이 추가되지만, 각 배치가 필요한 만큼만 메모리를 쓰게 된다. 런타임 최적화라서 역시 아키텍처와는 무관하다.
큰 그림(Big Picture): 종합하면, 이 KV cache 최적화들은 표준 MHA Transformer 대비 KV cache 크기를 한 자릿수 배 이상 줄일 수 있다. Transformer 전체 비용의 한 자릿수 배 개선으로 이어질 수 있다.
여러 가속기에 추론 분산하기
지금까지는 단일 칩을 넘어서는 확장을 대충 얼버무려 왔다. 5장을 따라, 쓸 수 있는 여러 전략과 그 트레이드오프를 살펴보자. 늘 그렇듯 prefill과 generation을 따로 본다.
Prefill
roofline 관점에서 prefill은 학습과 거의 동일하며, 거의 모든 기법과 트레이드오프가 그대로 적용된다 — model (Megatron) parallelism, sequence sharding(충분히 긴 context라면), pipelining, 심지어 FSDP까지 전부 가능하다! 나중에 generation을 할 수 있도록 KV를 계속 들고 있기만 하면 된다. 학습에서처럼 칩 수를 늘리면 더 많은 FLOPs/s에 접근할 수 있지만(TTFT를 낮출 수 있지만), 통신 오버헤드가 더해진다(칩당 throughput이 줄어들 수 있다).
prefill sharding의 일반 규칙: 다음은 prefill에 대한 일반 규칙 모음이다. 시퀀스 하나만 prefill한다고 가정한다(배치 차원 없음):
- Model sharding: 보통 ICI-bound가 되는 지점까지 먼저 어느 정도 model parallelism을 한다. 5장에서 봤듯 1개 axis 기준 이는 근처다(대개 4-8 way sharding).
- Sequence parallelism: 그 너머로는 sequence parallelism(데이터 parallelism과 비슷하지만 시퀀스 차원으로 sharding)을 한다. sequence parallelism은 attention에 약간의 추가 통신을 도입하지만, 긴 context에서는 보통 꽤 작다. 학습에서처럼 통신과 연산을 겹칠 수 있다(Megatron에는 collective matmul, ring attention에는 각각의 기법을 사용).
요점(Takeaway): prefill 중에는 학습에서 통하는 sharding이라면 거의 무엇이든 잘 통한다. ICI bound까지 model parallelism을 하고, 그다음 sequence parallelism을 하라.
Generation
generation은 prefill보다 복잡한 짐승이다. 우선 많은 요청을 함께 배치해야 하므로 큰 batch size를 얻기가 더 어렵다. latency 목표도 더 낮다. 이 둘이 합쳐져 보통 더 memory-bound이고 통신 오버헤드에 더 민감하며, 이는 sharding 전략을 제약한다:
-
FSDP는 불가능하다: 파라미터와 KV cache를 HBM에서 MXU로 로드하는 데서 memory-bound이므로, HBM보다 몇 자릿수 배 느린 ICI로 그것들을 옮기고 싶지 않다. 우리는 weight가 아니라 activation을 옮기고 싶다. FSDP와 비슷한 방법들은 generation에서 대개 완전히 비현실적이다.5
-
데이터 parallelism을 할 이유가 없다: 순수 데이터 parallelism은 파라미터를 복제할 뿐, 파라미터를 더 빨리 로드하는 데 도움이 안 되므로 무익하다. 그럴 바엔 모델 사본을 여러 개 띄우는 편이 낫다.6
-
시퀀스가 없다 = sequence sharding도 없다. sequence sharding은… 행운을 빈다.
dense 모델의 generation에는 결국 model sharding의 변형들만 남는다. prefill과 마찬가지로 가장 단순한 것은 단순 model parallelism(activation은 완전 복제, weight는 MLP의 hidden 차원으로 완전 sharding)을 ICI bound가 되는 4-8 way까지 하는 것이다. 그러나 종종 memory bandwidth bound이므로, 사실 이 한계를 넘어 sharding해서 latency를 개선할 수 있다!
generation의 ICI bound에 대한 노트: 학습 중에는 compute-bound가 되고 싶으므로, roofline은 ICI 통신이 FLOPs보다 오래 걸리는 시점을 본다. 그러나 generation 중에 파라미터 로딩으로 memory bandwidth bound라면, 이 지점을 넘어 model sharding을 늘려도 (tokens/sec/chip 기준) throughput 비용을 최소로 하면서 latency를 개선할 수 있다. model sharding을 늘리면 weight를 나눠 로드할 HBM이 늘어나고, FLOPs는 문제가 아니다.7 model parallelism이 병목이 되기 전까지 얼마나 할 수 있는지 보자.
여기서 이다. 이 수치는 TPU v5e와 TPU v6e에서 보통 8 근처다. 예컨대 가 16,384이고 가 32라면, 이론상 throughput에 의미 있는 타격 없이 16384 / (32 * 8) = 64 way까지 model parallelism을 할 수 있다. KV cache를 64-way로 완전히 shard할 수 있다는 가정인데, 이게 어렵다: 아래에서 논의한다.
attention 레이어에서도 와 를 Megatron 스타일로 head에 대해 model shard한다. KV weight는 꽤 작아서, -way sharding을 넘어 shard하기보다 복제하는 편이 저렴한 경우가 많다.
요점(Takeaway): generation 중 유일한 선택지는 model parallelism의 변형들이다. 더 큰 KV cache나 파라미터 대신 activation을 옮기는 것을 목표로 한다. batch size가 클 때는 FLOPs-ICI bound()까지 model parallelism을 한다. batch size가 더 작을 때는 (적당한 throughput 비용을 치르고) model sharding을 더 해서 latency를 개선할 수 있다. KV head 수보다 많은 way로 model shard하고 싶을 때는 KV를 배치 차원으로도 shard할 수 있다.
KV cache sharding
shard해야 할 자료구조가 하나 더 있다 — KV cache다. cache가 attention latency의 주된 원천이므로 역시 복제는 거의 항상 피하고 싶다. 이를 위해 먼저 KV를 head 차원으로 Megatron-shard한다. -way sharding까지로 제한되므로, head 수가 적은 모델에서는 head 차원을 최대한 shard한 뒤 배치 차원으로 shard한다. 즉 이다. 이러면 KV cache가 완전히 분산된다.
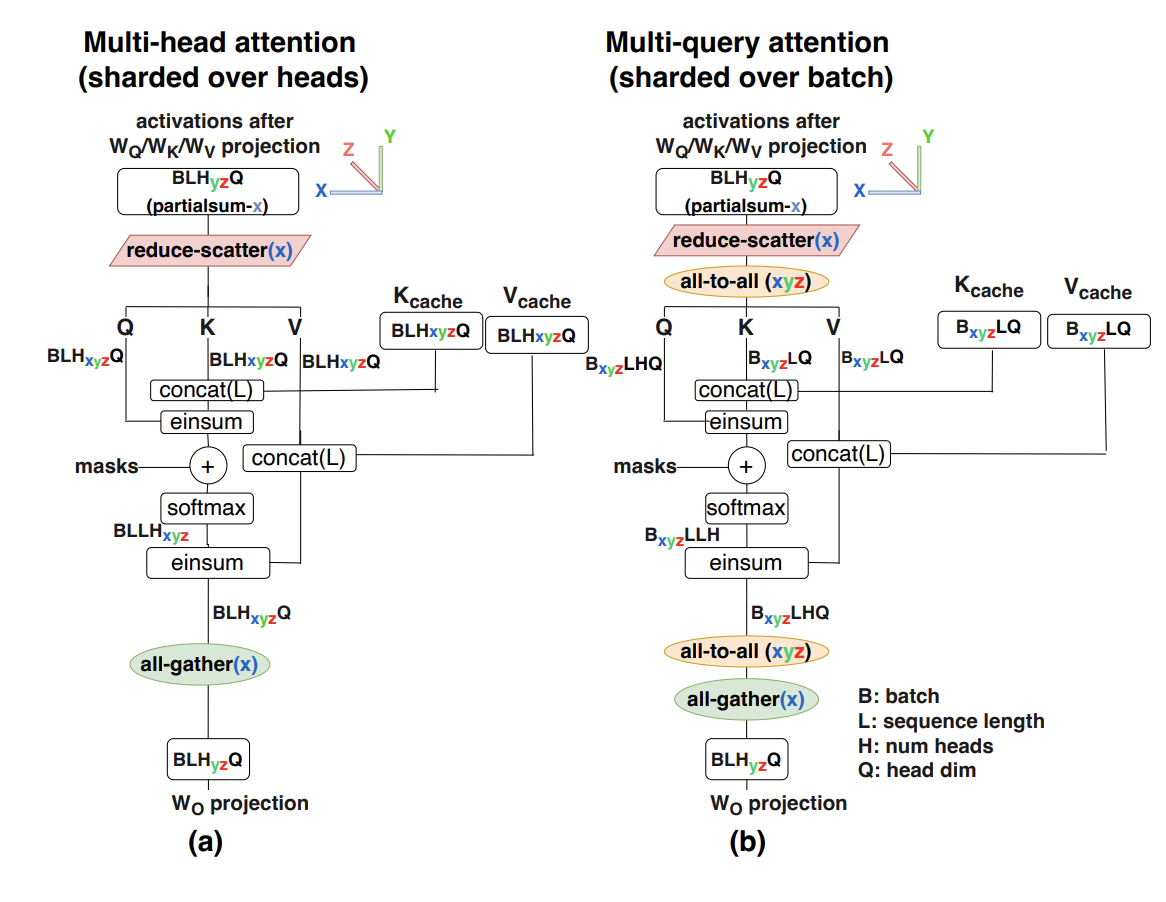
그 비용은 attention 레이어마다 두 번의 AllToAll이다 — 하나는 Q activation을 배치 sharding으로 옮겨 배치 sharding 상태로 attention을 계산할 수 있게 하는 것이고, 다른 하나는 배치 sharded attention 출력을 다시 순수 model sharded로 되돌리는 것이다.
전체 알고리즘 보기
여기서 와 둘 다에 대한 model parallelism을 포함한 전체 attention 알고리즘을 적어 보겠다. key 텐서와 KV head 차원 둘 다에 를 쓰는 점은 양해를 구한다. 라 하자.
- X[B, D] = … (기존 activation, 이전 레이어에서 unsharded)
- K[BZ, S, KY, H], V[BZ, S, KY, H] = … (기존 KV cache, 배치 sharded)
- Q[B, NYZ, H] = X[B, D] * WQ[D, NYZ, H]
- Q[BZ, NY, H] = AllToAllZ->B(Q[B, NYZ, H])
- Q[BZ, KY, M, H] = Reshape(Q[BZ, NY, H])
- O[BZ, S, KY, M] = Q[BZ, KY, M, H] *H K[BZ, S, KY, H]
- O[BZ, S, KY, M] = SoftmaxS(O[BZ, S, KY, M])
- O[BZ, KY, M, H] = O[BZ, S, KY, M] *S V[BZ, S, KY, H]
- O[B, KY, MZ, H] = AllToAllZ->M(O[BZ, KY, M, H])
- O[B, NYZ, H] = Reshape(O[B, KY, MZ, H])
- X[B, D] {UYZ} = WO[NYZ, H, D] *N,H O[B, NYZ, H]
- X[B, D] = AllReduce(X[B, D] { UYZ})
꽤 복잡하지만 대체로 어떻게 작동하는지 볼 수 있다. 새로 생긴 통신들은 작은 activation에 작용하므로 비용이 크지 않고, 그 대가로 (고정되어 있는) KV 로딩에서 어마어마한 메모리 bandwidth를 아낀다.
- Sequence sharding: batch size가 너무 작거나 context가 길면 KV cache를 sequence shard할 수 있다. 역시 여기서는 shard 간 attention을 누적하는 collective 비용을 치른다. 먼저 Q activation을 AllGather해야 하고, 그다음 Flash Attention과 비슷한 방식으로 KV를 누적한다.
효과적인 추론 엔진 설계하기
지금까지는 개별 prefill·generate 연산을 따로 떼어 효율적으로 최적화하고 shard하는 방법을 봤다. 이를 실제로 효과적으로 쓰려면, latency/throughput Pareto frontier 위 우리가 고른 지점에서 이 두 연산에 일감을 공급할 수 있는 추론 엔진을 설계해야 한다.
가장 단순한 방법은 그냥 prefill 한 배치를 돌리고, 이어서 generation 한 배치를 돌리는 것이다:
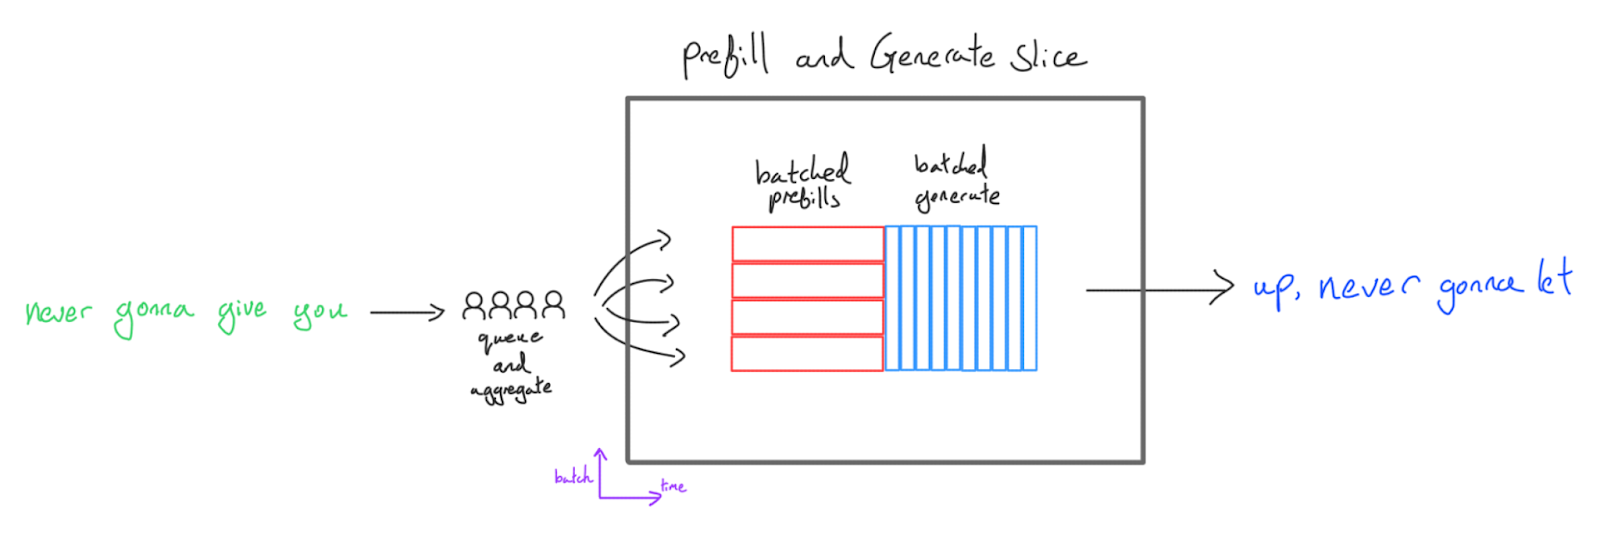
구현이 쉬워 대부분의 코드베이스에서 첫 번째 추론 셋업이 되지만, 단점이 여럿 있다:
- latency가 끔찍하다. prefill과 generate의 batch size가 서로 묶인다. 큰 prefill batch size에서는 Time to first token(TTFT)이 끔찍하다 — 어떤 사용자든 토큰을 보려면 모든 prefill이 끝나야 한다. 작은 batch size에서는 generate throughput이 끔찍하다.
- 짧은 generation이 긴 generation에 막힌다. 많은 시퀀스가 다른 것보다 먼저 끝나면서 generation 중 빈 배치 슬롯이 생기고, generate throughput을 더 해친다. batch size와 generation 길이가 커질수록 문제가 악화된다.
- prefill이 패딩된다. prefill이 가장 긴 시퀀스에 맞춰 패딩되어 연산을 많이 낭비한다. 해법이 있긴 하지만 역사적으로 XLA에서는 이 FLOPs를 건너뛰기가 꽤 어려웠다. 역시 batch size와 prefill 시퀀스 길이가 커질수록 나빠진다.
- prefill과 generation이 sharding을 공유해야 한다. prefill과 generate가 같은 slice에 살기 때문에 (weight 사본을 두 벌 두지 않는 한) 둘 다 같은 토폴로지와 sharding을 쓰게 되고, 대체로 성능에 도움이 안 된다. 예컨대 generate는 model sharding을 훨씬 더 많이 원한다.
따라서 이 방법은 엣지 응용(보통 한 사용자만 서비스하고 FLOPs/byte가 낮은 하드웨어를 쓰는 경우)과 Transformer 코드베이스 수명 초기의 빠른 반복(단순함 덕분)에만 권장된다.
약간 더 나은 접근은 prefill을 batch size 1로 수행하되(이 지점에서 compute-bound이면서 latency도 합리적이다), generation 중에는 여러 요청을 함께 배치하는 것이다:
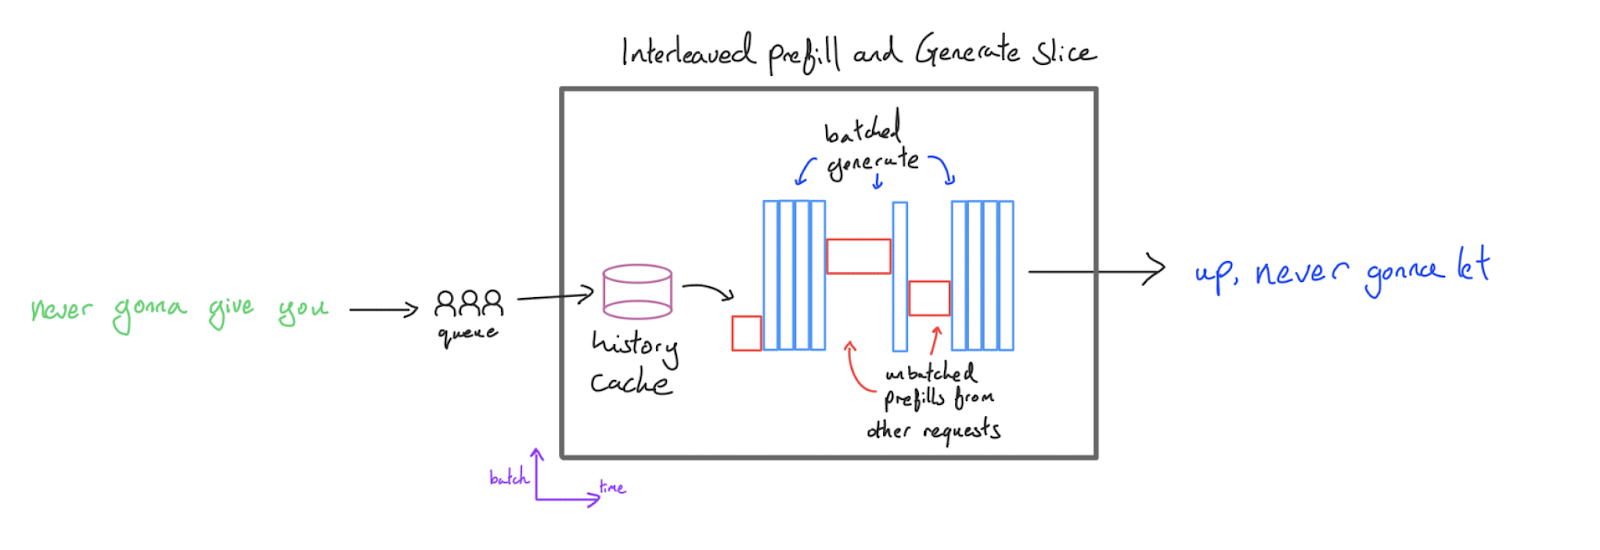
이러면 batched prefill의 TTFT 낭비를 피하면서 generation throughput을 높게 유지할 수 있다. 이를 interleaved 구성이라 부르는데, prefill과 generation 스텝을 “끼워 넣기(interleave)” 때문이다. eval처럼 throughput이 주된 목표인 벌크 generation 응용에는 아주 강력하다. 오케스트레이터는 generation 슬롯이 열리는 순간 prefill을 우선하도록 구성할 수 있어, 아주 큰 generation batch size에서도 높은 활용률을 보장한다. 다른 요청과 함께 배치되지 않으므로 prefill을 최대 길이에 맞춰 패딩하는 것도 피할 수 있다.
주된 단점은, 서버가 prefill을 수행하는 동안 다른 모든 요청의 generation이 멈춘다는 것이다. 모든 연산 자원을 prefill이 소모하기 때문이다. 응답을 한창 decode 중인 사용자 A는 prefill이 진행 중인 사용자 B에게 막힌다. TTFT는 좋아졌지만 토큰 생성이 평균적으로 들쭉날쭉하고 느려서, 많은 응용에서 좋은 사용자 경험이 아니다 — 다른 사용자의 prefill이 요청 전체 latency의 critical path에 놓이는 것이다.
이를 해결하기 위해 decode와 prefill을 분리한다. Transformer 추론을 한 서버에서 할 수도 있지만, latency 관점에서는 이 서로 다른 두 과제를 두 개의 TPU/GPU 집합에서 따로 실행하는 편이 나은 경우가 많다. prefill 서버는 KV cache를 생성해 네트워크를 통해 generate 서버로 보내고, generate 서버는 여러 cache를 배치로 묶어 각각에 대해 토큰을 생성한다. 이를 “disaggregated” serving이라 부른다.
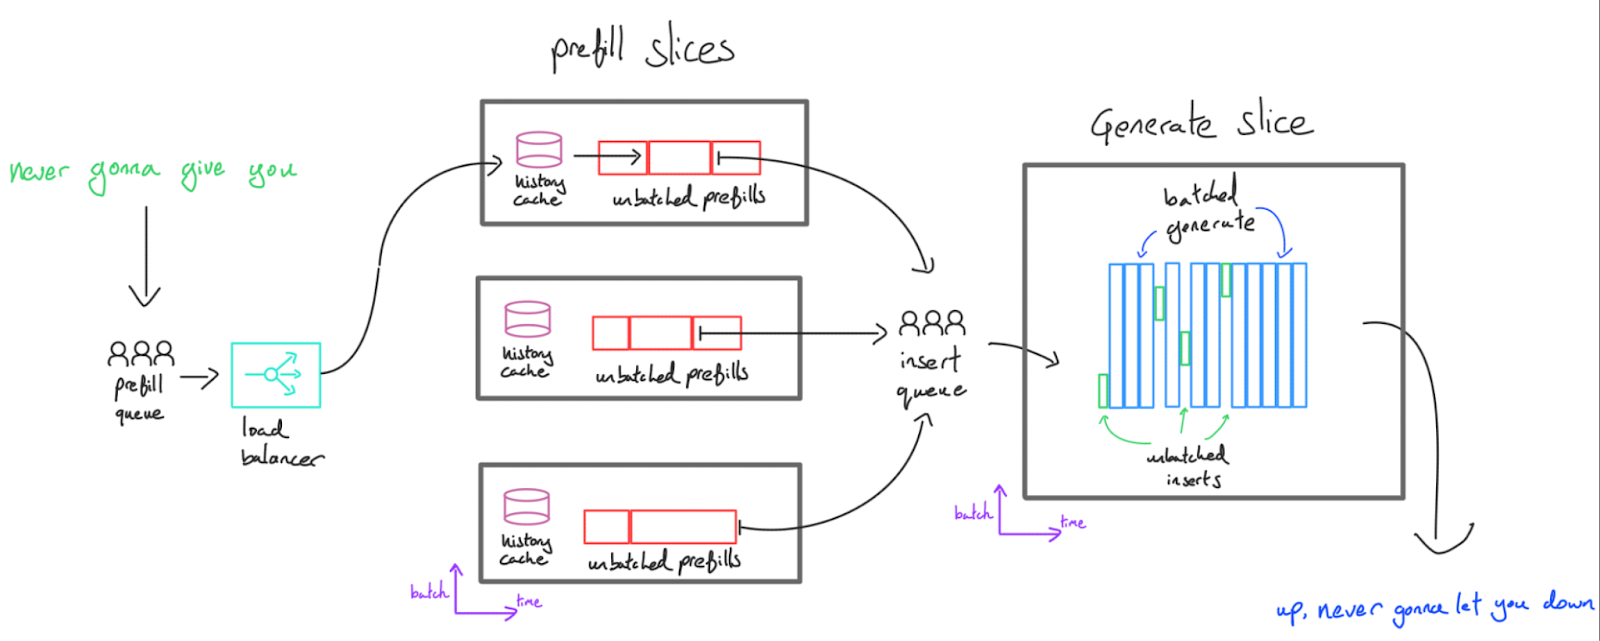
이렇게 하면 몇 가지 이점이 있다:
-
대규모에서의 낮은 latency: prefill 용량이 부족한 경우를 제외하면, 한 사용자의 요청이 다른 사용자의 요청에 막히는 일이 없다. 요청은 즉시 prefill되고, generation 서버로 보내지고, 즉시 generation 버퍼에 꽂혀야 한다. 동시 요청이 많이 들어올 것으로 예상되면, prefill 서버 수를 generate 서버 수와 독립적으로 확장해 사용자가 prefill 큐에서 오래 기다리지 않게 할 수 있다.
-
특화: prefill과 generate의 latency 최적 파라미터 sharding 전략/하드웨어 토폴로지는 꽤 다른 경우가 많다(예컨대 model parallelism을 늘리는 것은 generate에는 유용하지만 prefill에는 아니다). 두 연산을 같은 sharding에 묶으면 둘 다 성능이 상하고, weight를 두 벌 두면 메모리를 쓴다. 또 prefill을 자기만의 서버로 옮기면 현재 처리 중인 것 말고는 KV cache를 들고 있을 필요가 없다. 그만큼 history caching(다음 절 참조)이나 prefill latency 최적화에 쓸 수 있는 메모리가 훨씬 많아진다.
단점 하나는 KV cache를 이제 네트워크 너머로 옮겨야 한다는 것이다. 보통은 감내할 만하지만, 이 역시 KV cache 크기를 줄일 동기가 된다.
요점(Takeaway): latency에 민감한 고-throughput serving에서는 보통 prefill과 generation을 별도의 서버로 분리해야 한다. prefill은 batch 1로 동작하고, generation은 많은 동시 요청을 함께 배치한다.
Continuous batching
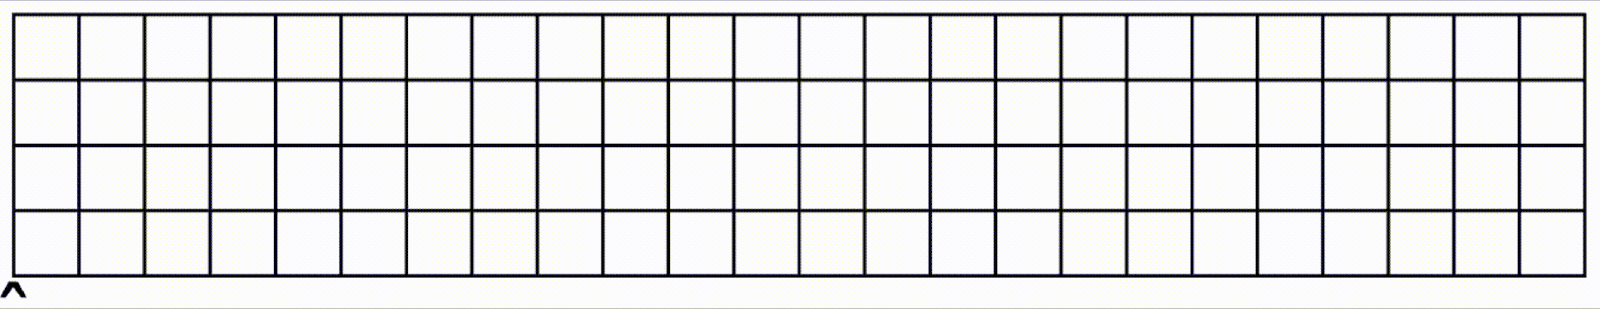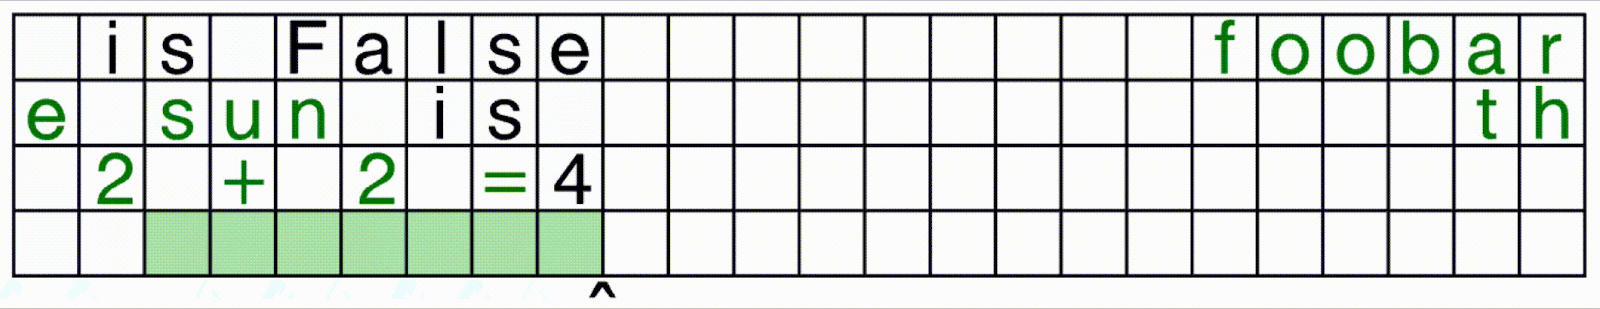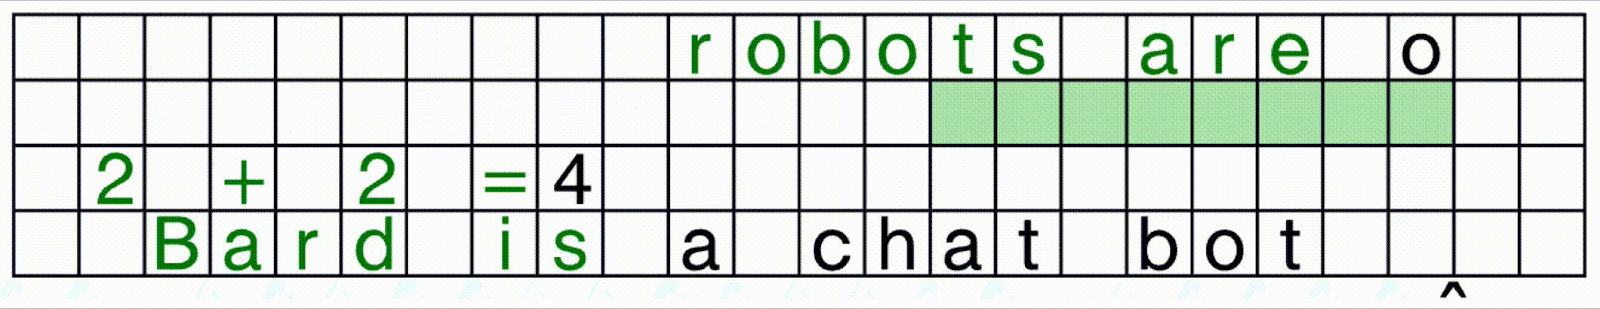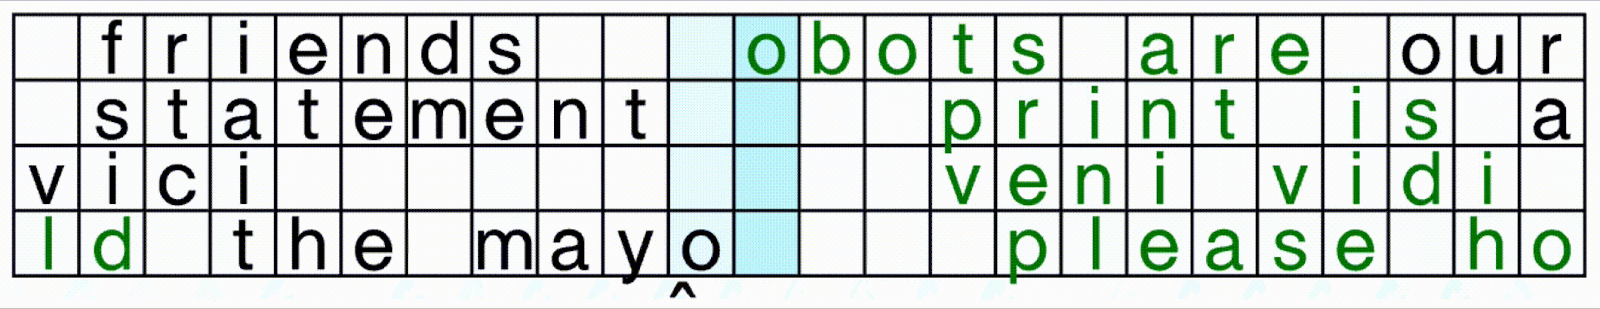
위의 문제 (2)는 continuous batching 개념의 동기가 된다. 다음을 최적화·컴파일한다:
- 가변 context 길이를 처리하고, 어떤 최대 batch size와 context 길이/페이지 수를 가진 KV 버퍼에 결과를 삽입하는 prefill 함수.
- KV cache를 받아, 현재 활성인 모든 요청에 대해 generation 스텝을 수행하는 generate 함수.
그리고 이 함수들을 오케스트레이터와 결합한다. 오케스트레이터는 들어오는 요청을 큐에 넣고, 가용 generate 슬롯에 따라 prefill과 generate를 호출하고, history caching(다음 절 참조)을 처리하고, 토큰을 스트리밍해 내보낸다.
Prefix caching
prefill은 비싸고 compute-bound라(개선 여지가 적다), 비용을 줄이는 가장 좋은 방법 중 하나는 덜 하는 것이다. LLM은 autoregressive하므로 [“I”, “like”, “dogs”]와 [“I”, “like”, “cats”]라는 쿼리는 처음 두 토큰에서 동일한 KV cache를 만든다. 원칙적으로 “I like dogs” cache를 먼저 계산하고 그다음 “I like cats” cache를 계산하면 연산의 1/3만 하면 된다는 뜻이다. cache를 재사용해 일의 대부분을 아낄 수 있는 것이다. 이 재사용은 몇 가지 특정한 경우에 특히 강력하다:
- 챗봇: 대부분의 챗봇 대화는 자기 자신에 엄격하게 덧붙여지기만 하는 주고받기 대화다. 각 대화 턴의 KV cache를 저장해 두면 최신 토큰을 제외한 모든 연산을 건너뛸 수 있다.
- Few-shot prompting: 어떤 종류든 few-shot 프롬프트가 있다면 저장해서 공짜로 재사용할 수 있다. 시스템 지시문도 흔히 이런 형태다.
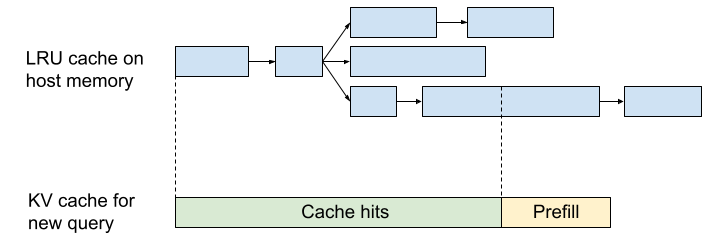
이를 어렵게 만드는 유일한 이유는 메모리 제약이다. 봤다시피 KV cache는 크고(종종 수 GB), caching이 유용하려면 후속 쿼리가 도착할 때까지 들고 있어야 한다. 보통 prefill 서버의 남는 HBM은 로컬 caching 시스템에 쓸 수 있다. 게다가 가속기의 CPU 호스트에는 대개 메모리가 많다(예: 8xTPUv5e 서버는 HBM이 128GiB이지만 호스트 DRAM은 약 450GiB다). 이 메모리는 HBM보다 훨씬 느리지만 — 보통 generation 스텝을 하기엔 너무 느리다 — cache 읽기에는 충분히 빠르다. 실전에서는:
- KV cache는 최초 요청을 처리한 TPU 집합에 로컬이므로, 후속 쿼리가 같은 replica에 도착하도록 어떤 형태의 affinity routing이 필요하다. 로드 밸런싱에 문제를 일으킬 수 있다.
- 작은 KV cache가 (또다시) 도움이 된다 — 같은 공간에 더 많은 KV cache를 저장할 수 있고, 읽기 시간도 줄어든다.
- KV cache와 그 lookup은 트리나 trie에 꽤 자연스럽게 저장할 수 있다. eviction은 LRU 기준으로 하면 된다.
구현 사례: JetStream
Google은 이 로직을 구현한 JetStream이라는 라이브러리를 오픈소스로 공개했다. 서버에는 “prefill engine”과 “generate engine”의 집합이 있고 — 보통 서로 다른 TPU slice에 있다 — 단일 컨트롤러가 이를 오케스트레이션한다. prefill은 “prefill 스레드”에서, generation은 “generate 스레드”에서 일어난다. prefill slice에서 generate slice로 KV cache를 복사하는 일을 오케스트레이션하는 “transfer 스레드”도 있다.
Engine 인터페이스(여기에 구현됨)는 어떤 LLM이든 제공해야 하는 제네릭 인터페이스다. 핵심 메서드는:
- prefill: 입력 토큰 집합을 받아 KV cache를 생성한다.
- insert: KV cache를 받아, generate가 생성에 쓰고 있는 KV cache 배치에 삽입한다.
- generate: 배치된 KV cache 집합을 받아 배치 항목당 토큰 하나를 생성하고, 토큰마다 단일 토큰의 KV cache를 decode 상태에 덧붙인다.
PyTorch 버전의 JetStream도 여기에서 쓸 수 있다.
연습 문제
이 절을 위해 LLaMA-2 13B를 기반으로 새 모델을 하나 만들어 보겠다. 세부 사항은 다음과 같다:
| hyperparam | value |
|---|---|
| L (num_layers) | 64 |
| D (d_model) | 4,096 |
| F (ffw_dimension) | 16,384 |
| N (num_heads) | 32 |
| K (num_kv_heads) | 8 |
| H (qkv_dim) | 256 |
| V (num_embeddings) | 32,128 |
문제 1: 위 모델의 파라미터는 몇 개인가? int8에서 토큰당 KV cache는 얼마나 큰가? input과 output projection 행렬을 공유한다고 가정해도 된다.
정답 보기
파라미터 수:
- MLP 파라미터 수:
- Attention 파라미터 수:
- Vocabulary 파라미터: (이 행렬들을 공유하므로)
따라서 총 파라미터 수는 이다. 위 수치를 대입하면 64 * 4096 * (3*16384 + 2 * 256 * (32 + 8)) + 4096 * 32128 = 18.4e9이다. 이 모델의 파라미터는 약 184억 개다.
KV cache는 int8에서 토큰당 , 즉 토큰당 2 * 64 * 8 * 256 = 262kB이다.
문제 2: 이 모델을 TPUv5e 4x4 slice에서 서빙하고, KV cache를 이 토폴로지에 완전히 shard할 수 있다고 하자. 모든 것에 int8을 쓰고 128k 시퀀스를 지원하고 싶다면, 담을 수 있는 최대 batch size는 얼마인가? KV head 수를 1로 줄이면 어떻게 되는가?
정답 보기
KV cache는 int8에서 토큰당 , 즉 2 * 64 * 8 * 256 = 262kB 크기다. 128k 시퀀스라면 배치 항목당 262e3 * 128e3 = 33.5GB다. 각 TPU의 HBM이 16GB이므로, 파라미터를 포함하면 담을 수 있는 최대 batch size는 (16 * 16e9 - 18.4e9) / 33.5e9 = 7이다. 이면 이것의 8배, 즉 약 56이다.
문제 3: TPU v5e 4x4 slice에 완전히 sharding되어 있다고 할 때, 모든 파라미터를 HBM에서 MXU로 로드하는 데 얼마나 걸리는가? int8 파라미터를 가정하라. 이는 스텝당 latency의 좋은 하한이다.
정답 보기
총 18.4B 파라미터, int8로 18.4e9 바이트다. 칩당 HBM bandwidth가 8.2e11이므로, HBM bandwidth를 온전히 쓸 수 있다면 대략 18e9 / (8.2e11 * 16) = 1.4ms가 걸린다.
문제 4: 이 모델을 TPUv5e 4x4 slice에서 int8 FLOPs와 int8 파라미터/activation으로 서빙한다고 하자. prefill과 decode 각각에 대해 어떻게 shard하겠는가? 힌트: 먼저 이 질문들에 답해 보라:
- 4x4에서 ICI는 어떤 모습인가?
- tensor parallelism의 roofline bound는 무엇인가?
- KV cache는 어떻게 shard할 수 있는가?
이 sharding에서 generation의 대략적인 스텝당 latency는 얼마인가?
문제 5: 위 모델이 사실은 MoE라고 해 보자. MoE 모델은 사실상 FFW 블록의 사본 E개를 가진 dense 모델이다. 각 토큰은 FFW 블록 중 k개를 통과하고, 이 k개를 평균해 출력을 만든다. 위 설정에 E=16, k=2를 쓰자.
- 총 파라미터와 activated 파라미터는 각각 몇 개인가? activated는 임의의 한 토큰이 사용하는 것을 뜻한다.
- TPU v5e에서 FLOPs bound가 되려면 어떤 batch size가 필요한가?
- 토큰당 KV cache는 얼마나 큰가?
- T 토큰의 forward pass에는 몇 FLOPs가 드는가?
정답 보기
(1) MoE이므로 각 MLP 블록의 파라미터는 이제 개다. dense 변형의 배다. 따라서 이제 , 즉 64 * 4096 * (3*16*16384 + 2 * 256 * (32 + 8)) + 4096 * 32128 = 212e9 총 파라미터로, 약 12배 증가다. activated 파라미터는 개가 아니라 개가 활성화되므로 총 64 * 4096 * (3*2*16384 + 2 * 256 * (32 + 8)) + 4096 * 32128 = 31.2e9로, dense 변형 대비 2배 미만의 증가다.
(2) FLOPs는 배만 늘어나는데 파라미터는 배 많으므로, HBM roofline이 배 올라간다. 즉 TPU v5e에서는 약 240 * (16 / 2) = 1920 토큰이 필요하다.
(3) MoE라는 성격은 attention 메커니즘에 대해 아무것도 바꾸지 않으므로 KV cache 크기는 그대로다.
(4) 여전히 다. 즉 이다.
문제 6: MoE에서는 “expert sharding”을 할 수 있다. mesh의 한 axis에 expert들을 나눠 놓는 것이다. 우리의 표준 표기로 첫 번째 FFW weight는 shape [E, D, F]이고 [EZ, DX, FY]로 shard한다. 여기서 X는 학습 중에만 FSDP 차원으로 쓰인다. TPU v5e에서 추론을 하고 싶다고 하자:
- Y=8, Z=16인 TPU v5e 8x16 slice에서 위 모델의 HBM weight 로딩 시간은 얼마인가? TPU당 남는 HBM은 얼마인가?
- 이 모델을 담을 수 있는 가장 작은 slice는 무엇인가?
문제 7 [2D model sharding]: 여기서는 ESTI 논문이 2D weight-stationary sharding이라 부르는 것의 수학을 따라가 본다. 부록 B에서 간략히 설명하지만, 수학을 스스로 유도할 수 있는지 이 문제를 먼저 풀어 보라. 2D weight stationary sharding의 기본 아이디어는 weight를 와 axis 둘 다로 shard해 각 청크가 대략 정사각형이 되게 하는 것이다. 이러면 통신 부하가 줄고 조금 더 멀리 확장할 수 있다.
2D weight stationary의 알고리즘은 다음과 같다:
- In[B, DX] = AllGatherYZ(In[B, DXYZ])
- Tmp[B, FYZ] {UX} = In[B, DX] *D Win[DX, FYZ]
- Tmp[B, FYZ] = AllReduceX(Tmp[B, FYZ] {UX})
- Out[B, DX] {UYZ} = Tmp[B, FYZ] *F Wout[FYZ, DX]
- Out[B, DXYZ] = ReduceScatterYZ(Out[B, DX] {UYZ})
이 알고리즘의 와 를 구하고, 언제 전통적인 3D model sharding을 능가하는지 알아내는 것이 목표다.
정답 보기
와 를 구해 보자. FLOPs는 완전히 sharding되어 있으므로 이전처럼 이지만, 통신은 이제
이다. AllReduce는 두 배 비싸고, 각 연산이 수행되는 axis 수만큼 통신을 나눈다는 점을 반영했다. 토폴로지를 자유롭게 고를 수 있고 (LLaMA-2처럼) 라 가정하면, (기초적인 미적분으로) , , 의 최적값은 , 이라고 주장할 수 있고, 총통신은
이다. 먼저, 위에서 가져오면 일반적인 1D model parallelism은 이므로, 새 통신이 더 작아지는 것은 언제인가?
일반적인 에 대해서는 이 조건이
이라고 주장한다. 칩이 72개보다 많으면 이 새 방식을 쓰는 편이 낫다는 말이다. 그런데 역사적으로는 ~20 way tensor parallelism 근처에서 ICI bound가 되곤 했으니, 약간 이상한 결과다. 하지만 여기서는 communication-bound라 하더라도 총 칩 수가 늘수록 총통신이 계속 줄어든다! 칩을 계속 늘리고, batch size를 키우고, 파라미터 스케일링을 더 하면서도 latency가 줄어드는 것을 볼 수 있다는 말이다.
7부는 여기까지! TPU에서 LLaMA 3를 서빙하는 방법을 살펴보는 8부는 여기에서 볼 수 있다.
부록
부록 A: batch size > 240 규칙은 얼마나 현실적인가?
위에서 제시한 단순한 규칙 — compute-bound가 되려면 batch size가 240 토큰보다 커야 한다 — 은 대체로 참이지만, 다른 연산들이 가용 HBM을 다 쓰지 않는 동안(예컨대 디바이스 간 통신 중에) TPU가 weight를 미리 가져올(prefetch) 수 있다는 점은 어느 정도 무시한 것이다.
다음은 dmodel 8192, dff 32768에 레이어당 matmul이 2개뿐인 작은 Transformer의 레이어 시간(마이크로초) 실측 플롯이다. 이 Colab 노트북에서 나온 것이다. batch 240 근처까지는 스텝 시간이 매우 천천히 늘다가, 그 뒤 선형으로 증가한다.

다음은 tokens / us 단위의 실제 throughput이다. 논지를 꽤 분명하게 보여준다. 여기서 이 레이어는 약 600M 파라미터를 4-way shard한 것이므로, 최소 약 365us의 latency를 기대할 수 있다.
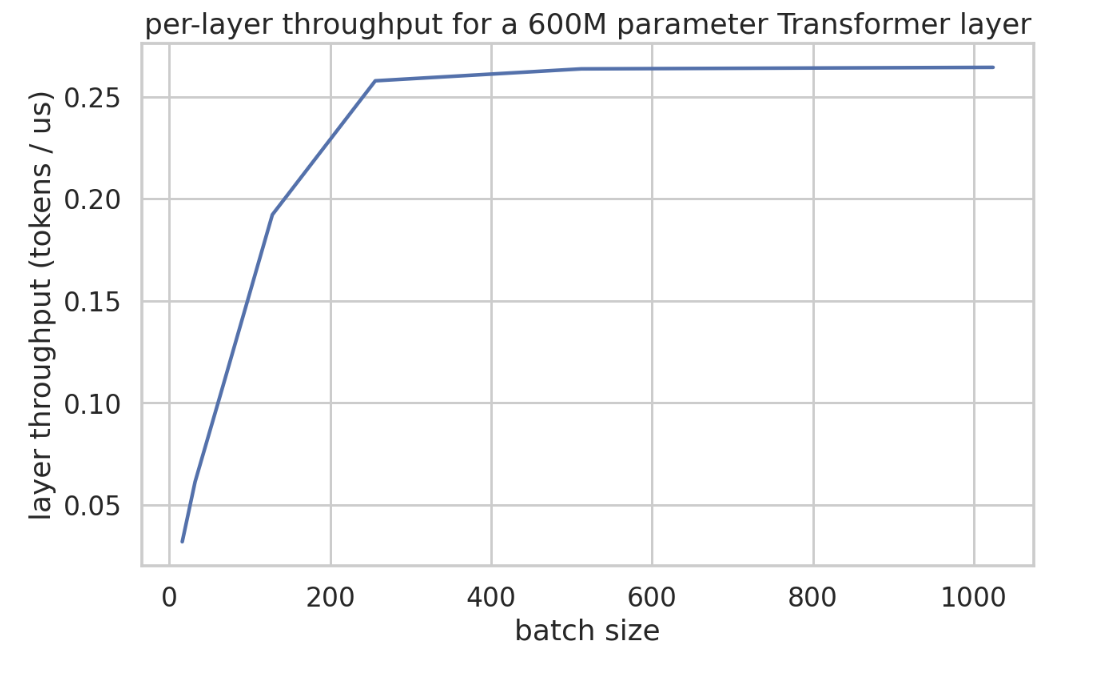
적어도 이 모델에서는 실제로 데이터 parallel shard당 BS240 근처까지 throughput이 증가한다.
부록 B: 2D Weight Stationary sharding
토폴로지가 커질 때, (TPU의 것과 같은) 더 높은 차원의 mesh에 접근할 수 있다면 두 번째 sharding axis를 도입해 이를 더 다듬을 수 있다. 이를 “2D Weight Stationary”라 부르며, Efficiently Scaling Transformer Inference 논문에 더 자세히 설명되어 있다.
Megatron에서는 hidden 차원만 shard하므로, 1D sharding에서 칩 수가 많아지면 그 shard가 ( 차원)보다 상당히 작아질 수 있다. 그래서 더 큰 batch size에서는 MLP의 첫 레이어를 적용한 뒤 hidden 차원에 대해 collectives의 일부를 수행하는 편이 더 경제적일 수 있다.
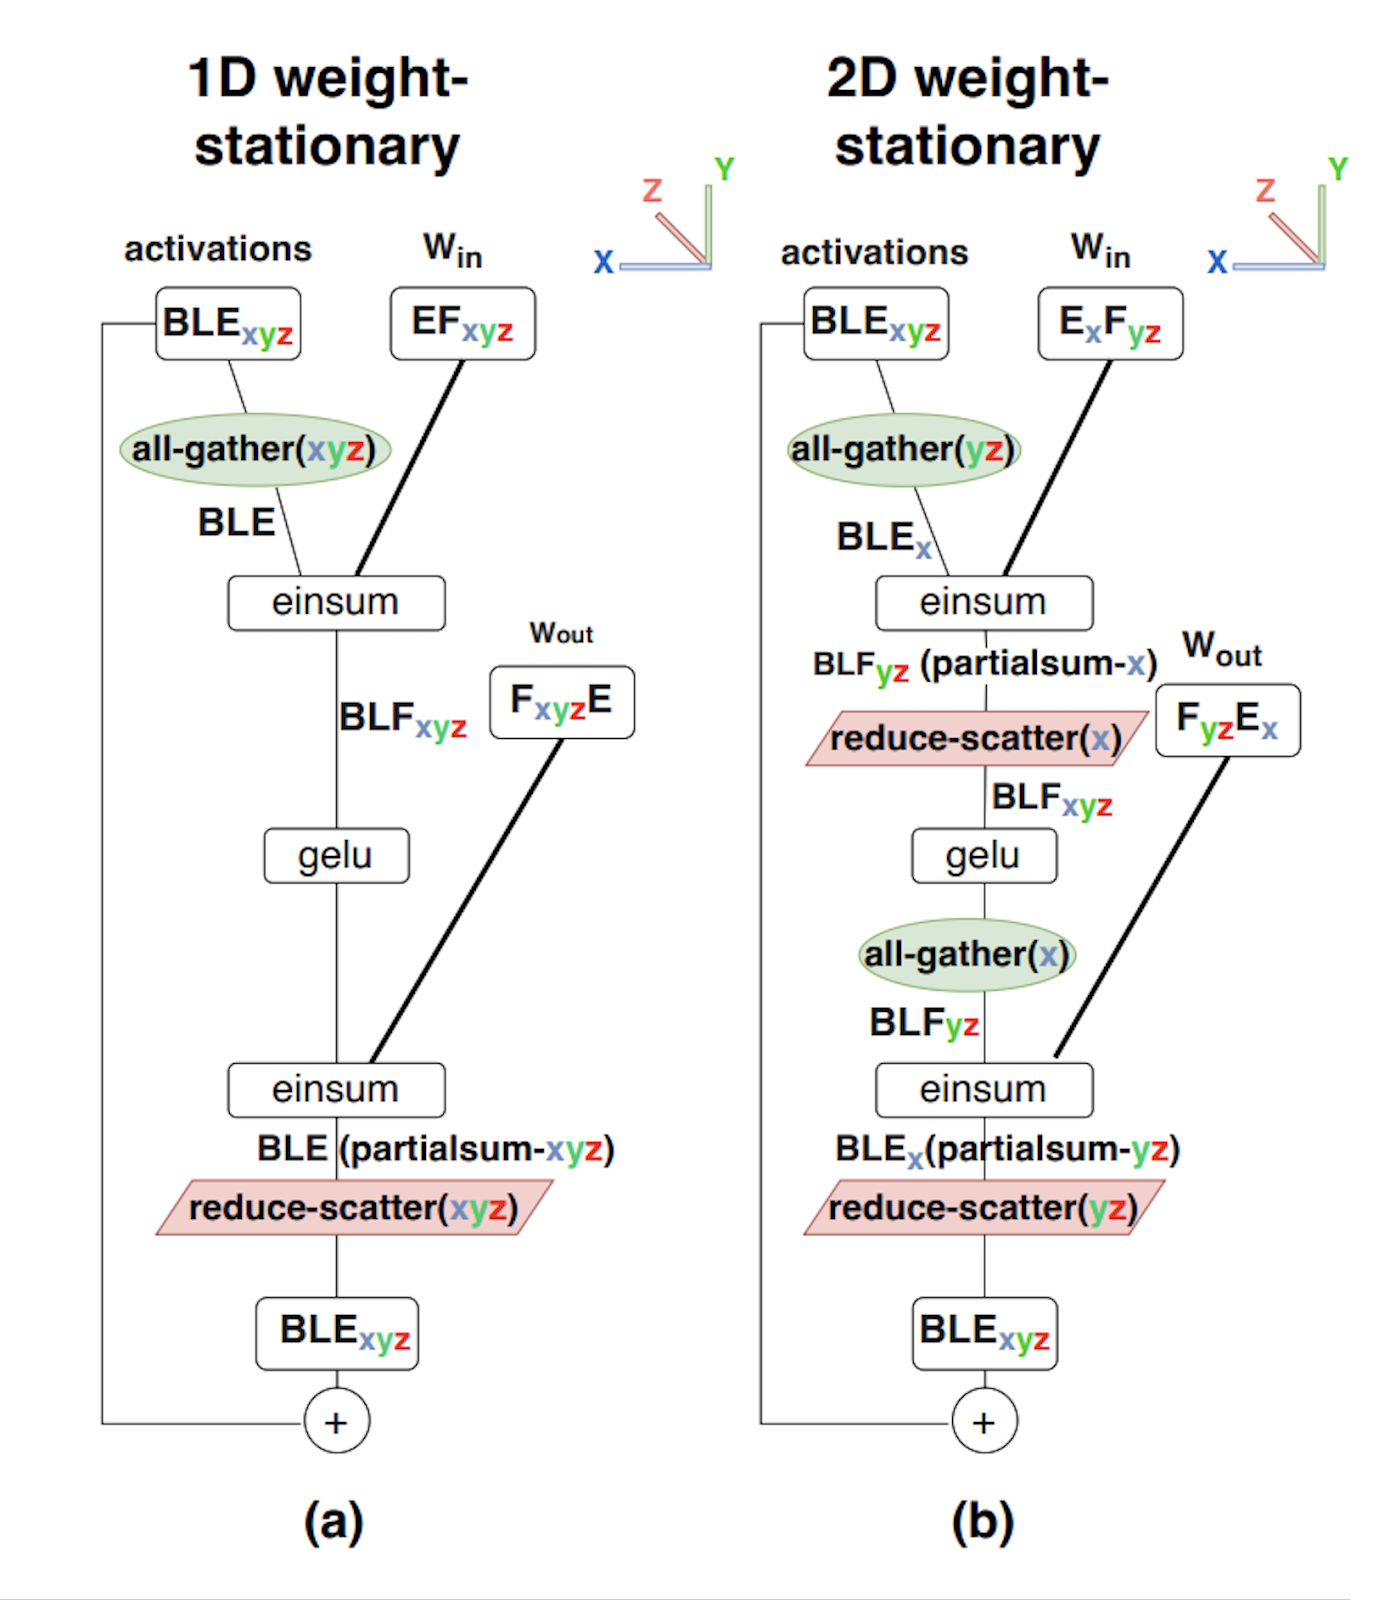
이 그림이 보여주는 것:
- 1D weight-stationary sharding, 일명 순수 Megatron sharding. AllGather 후 activation이 완전히 복제되고, weight는 hidden F 차원으로 완전히 sharding된다.
- 2D weight stationary sharding. weight가 hidden F와 reduction E 차원 둘 다로 sharding되고, activation은 E 차원으로 sharding된다. 첫 레이어 전에 (yz) axis에서 AllGather를 수행하고, 그다음 (x) axis에서 ReduceScatter를 한다.
attention 레이어의 경우에도 칩 수가 적을 때는 Megatron 스타일 sharding이 비교적 단순하다. 그러나 Megatron은 차원에서 일어나므로 가능한 sharding의 양에 한계가 있다. 2D sharding을 attention용으로 수정하면(hidden 차원 대신 차원을 shard한다), 더 멀리 확장할 수 있게 된다.
부록 C: latency에 묶인 통신
복습하자면, 3장에서 full-duplex bandwidth WICI와 latency Tmin인 링크로 연결된 1D ring 위의 X개 칩에 대해, 각 TPU에서 크기 B인 텐서로의 AllGather를 수행하는 데 걸리는 시간을 유도했다.
큰 B에서는, 시스템에 칩을 더할수록 연산 수행에 필요한 데이터 이동량과 총 가용 bandwidth가 동시에 늘어나므로 벽시계 시간이 비교적 일정하게 유지된다.
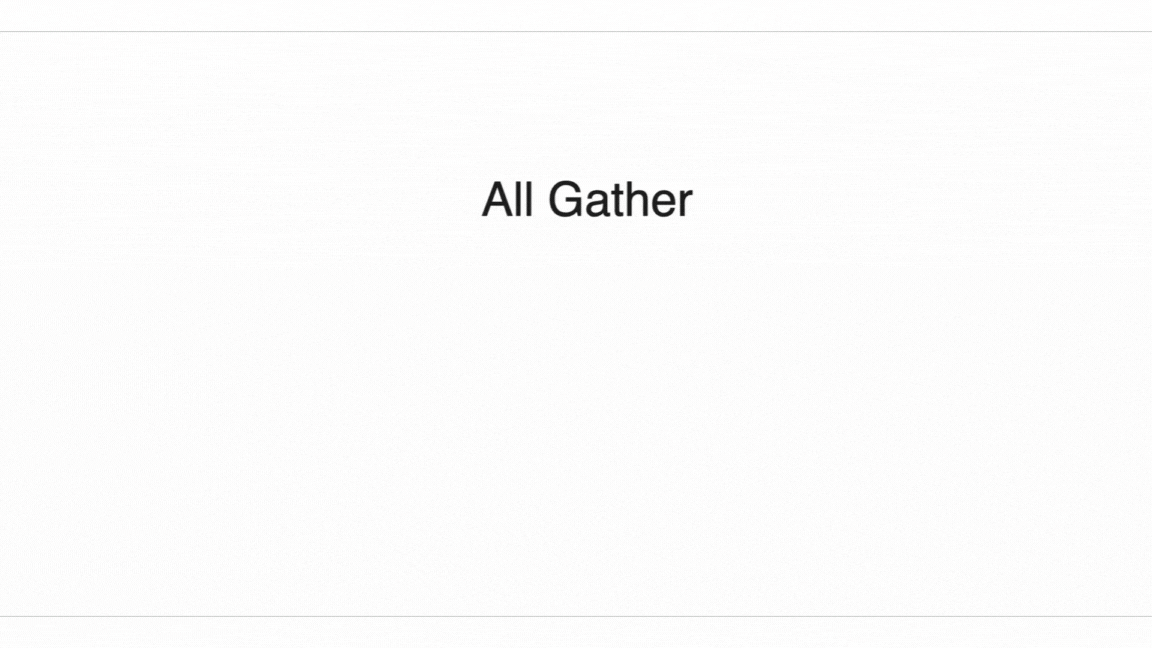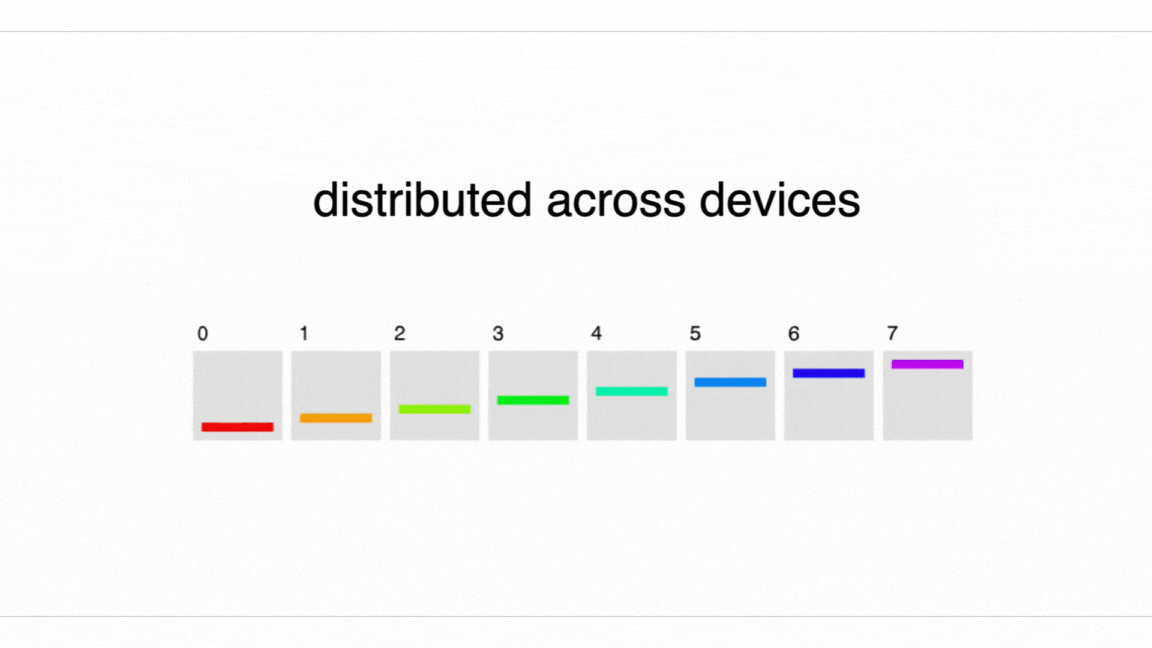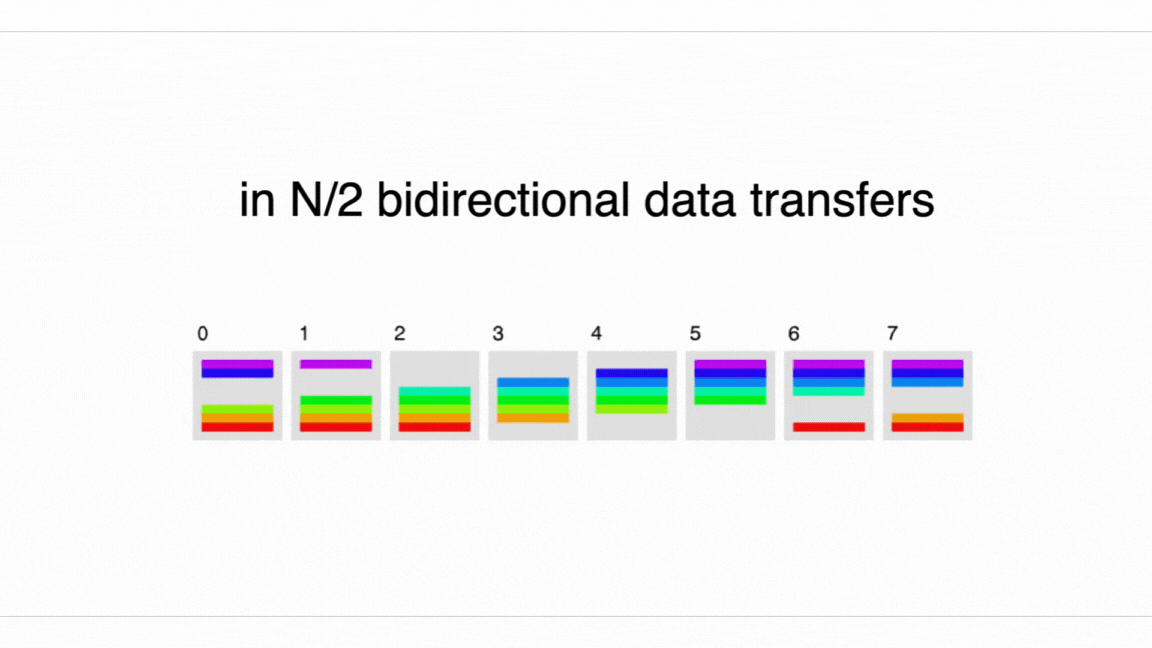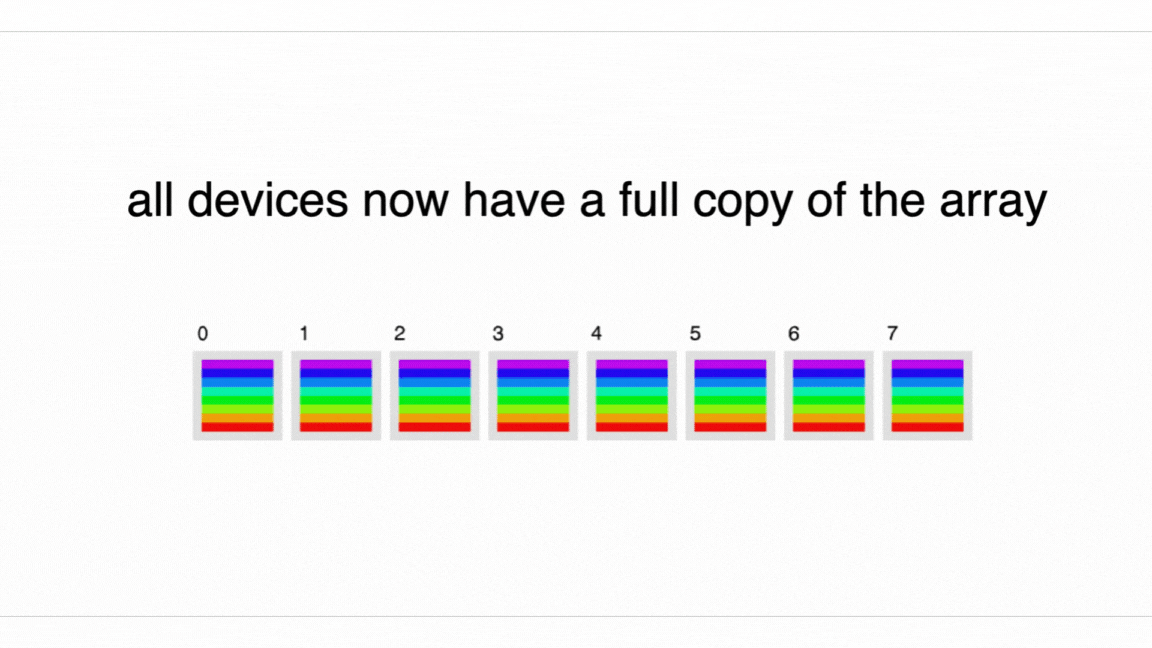
latency 최적화된 추론 중에는 옮기는 데이터 양이 비교적 적기 때문에, activation에 대한 collectives는 (특히 작은 batch size에서) latency 항에 묶이는 경우가 많다. latency는 완료까지 거쳐야 하는 hop 수를 세는 것으로 꽤 쉽게 시각화할 수 있다.
TPU에서 통신의 텐서 크기 의존 부분이 hop당 1마이크로초(hop은 인접한 두 디바이스 간의 통신) 미만이면, collective를 실제로 디스패치하는 고정 오버헤드에 병목이 걸릴 수 있다. 4.5e10의 단방향 ICI bandwidth 기준으로, ICI 통신이 latency bound가 되는 것은 일 때다. 8-way Megatron sharding이라면 buffer_size < 360kB일 때다. 추론 중에는 이게 그리 작은 값이 아니다: BS=16, D=8192의 int8이면 activation이 16*8192=131kB를 쓰므로 이미 latency bound다.
요점(Takeaway): 통신은 일 때 latency bound가 된다. 예컨대 에 대한 model parallelism은 int8 기준 일 때 bound가 된다.
여기에는 compute roofline과의 유사점이 있다 — 어떤 작은 연산들의 고정 비용(통신에서는 latency, matmul에서는 memory bandwidth)을 치르고 있는 것이다.
부록 D: Speculative Sampling
end-to-end latency가 정말로 중요할 때 쓸 수 있는 추가 트릭이 하나 있으니, speculative sampling(Leviathan et al. 2022; Chen et al. 2023)이다. 복습하자면 보통은 큰 Transformer에서 토큰을 하나씩 생성한다:
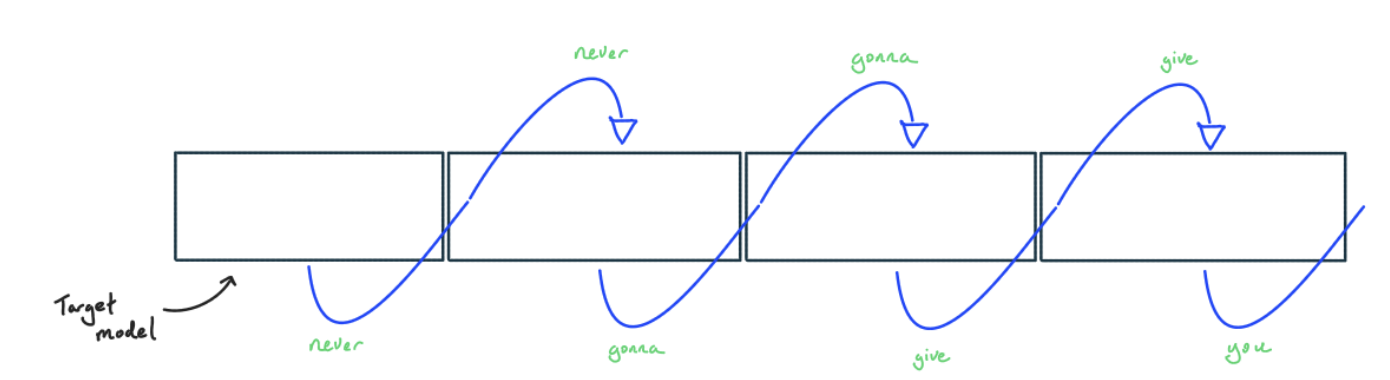
speculative sampling에서는 더 작고 저렴한 모델로 토큰을 생성한 뒤, 큰 모델로 결과를 검사한다. greedy decoding으로 이해하는 것이 가장 쉽다:
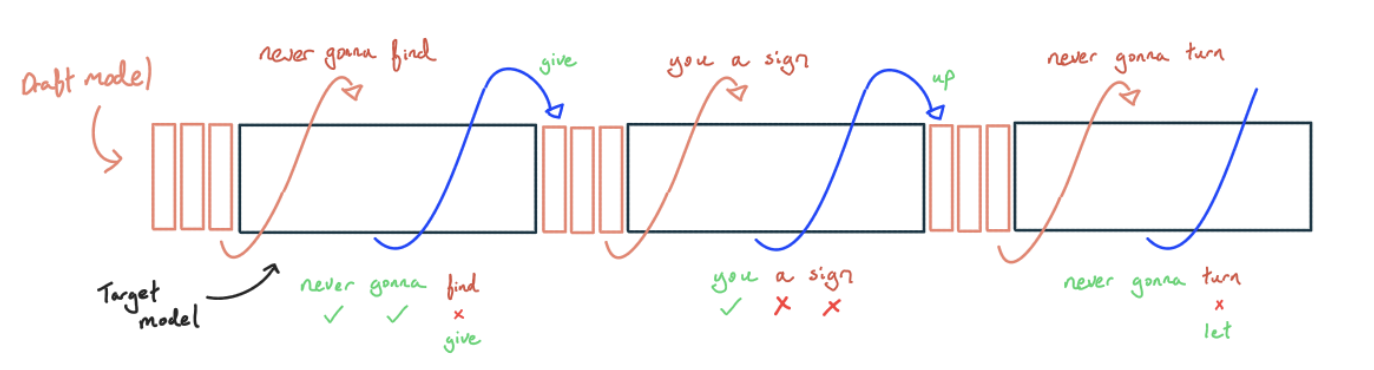
- 더 작고 저렴한 모델에서 greedy하게 샘플링한다. 이상적으로는 distillation 등으로 큰 모델에 맞도록 학습된 모델을 쓰지만, 단순히 n-gram이나 작은 텍스트 코퍼스에 대한 token matching처럼 간단한 것일 수도 있다.
- K개의 토큰을 생성한 뒤, 큰 모델로 지금까지 생성한 모든 토큰에 대한 다음 토큰 logits를 계산한다.
- greedy하게 decode하고 있으므로, 작은 모델이 생성한 토큰이 가능한 모든 토큰 중 최고 확률인지 검사하기만 하면 된다. 토큰 중 하나가 틀렸다면 가장 긴 올바른 prefix를 취하고 첫 번째 틀린 토큰을 올바른 토큰으로 교체한 뒤 (1)로 돌아간다. 모든 토큰이 맞았다면 마지막 올바른 logit으로 추가 토큰 하나를 샘플링한 뒤 (1)로 돌아간다.
이게 왜 latency 승리인가? 이 방식도 토큰마다 큰 모델의 forward pass 한 번 분량에 해당하는 FLOPs를 요구하는 것은 같지만, 여러 토큰을 배치로 묶을 수 있으므로 이 FLOPs 전부를 forward pass 한 번에 처리할 수 있고, 우리가 compute-bound가 아니라는 사실을 이용해 공짜로 더 많은 토큰을 채점할 수 있다.
수락된 토큰당 평균 FLOPs 비용은 더 비싸지지만(일부는 거부되고, draft 모델도 호출해야 하므로), 하드웨어에서 FLOPs를 더 쥐어짜고 작은 모델은 저렴하므로 전체적으로는 이득이다. KV cache 로드도 여러 스텝에 걸쳐 공유되므로, speculative decoding은 긴 context에서는 throughput 승리이기도 하다. 모든 것이 큰 모델의 검증을 거치므로 샘플링 분포는 전혀 바뀌지 않는다(다만 non-greedy에서는 정확한 궤적이 달라진다).
전통적으로 speculative decoding은 타깃 모델과 샘플링 분포가 비슷한 더 작은 모델의 존재에 의존한다. 예컨대 LLaMA-2 70B에 대한 LLaMA-2 2B처럼 — 그런 모델은 없는 경우가 많다. 있다 해도 수락률(acceptance rate)이 낮으면 그 작은 drafter조차 너무 비쌀 수 있다. 그 대신 drafter를 본 모델 안에 심는 것이 도움이 될 수 있다. 예컨대 베이스 모델 후반부 레이어 중 하나에 전용 drafter head를 추가하는 식이다(Li et al. 2024; Cai et al. 2024; DeepSeek-AI et al. 2024). 이 head는 파라미터 대부분을 본 모델과 공유하므로 실행이 더 빠르고, 샘플링 분포도 더 가깝게 맞는다.
일반적인 autoregressive 샘플링에서 token/s는 스텝 시간과 같다. 여전히 여기의 Arithmetic Intensity 절에 따른 이론적 최소 스텝 시간에 묶여 있다(사실 speculative sampling의 스텝 시간은 보통 일반 autoregressive 샘플링보다 꽤 느리지만, 스텝당 평균 1개보다 많은 토큰을 얻으므로 tokens/s는 훨씬 좋아질 수 있다).
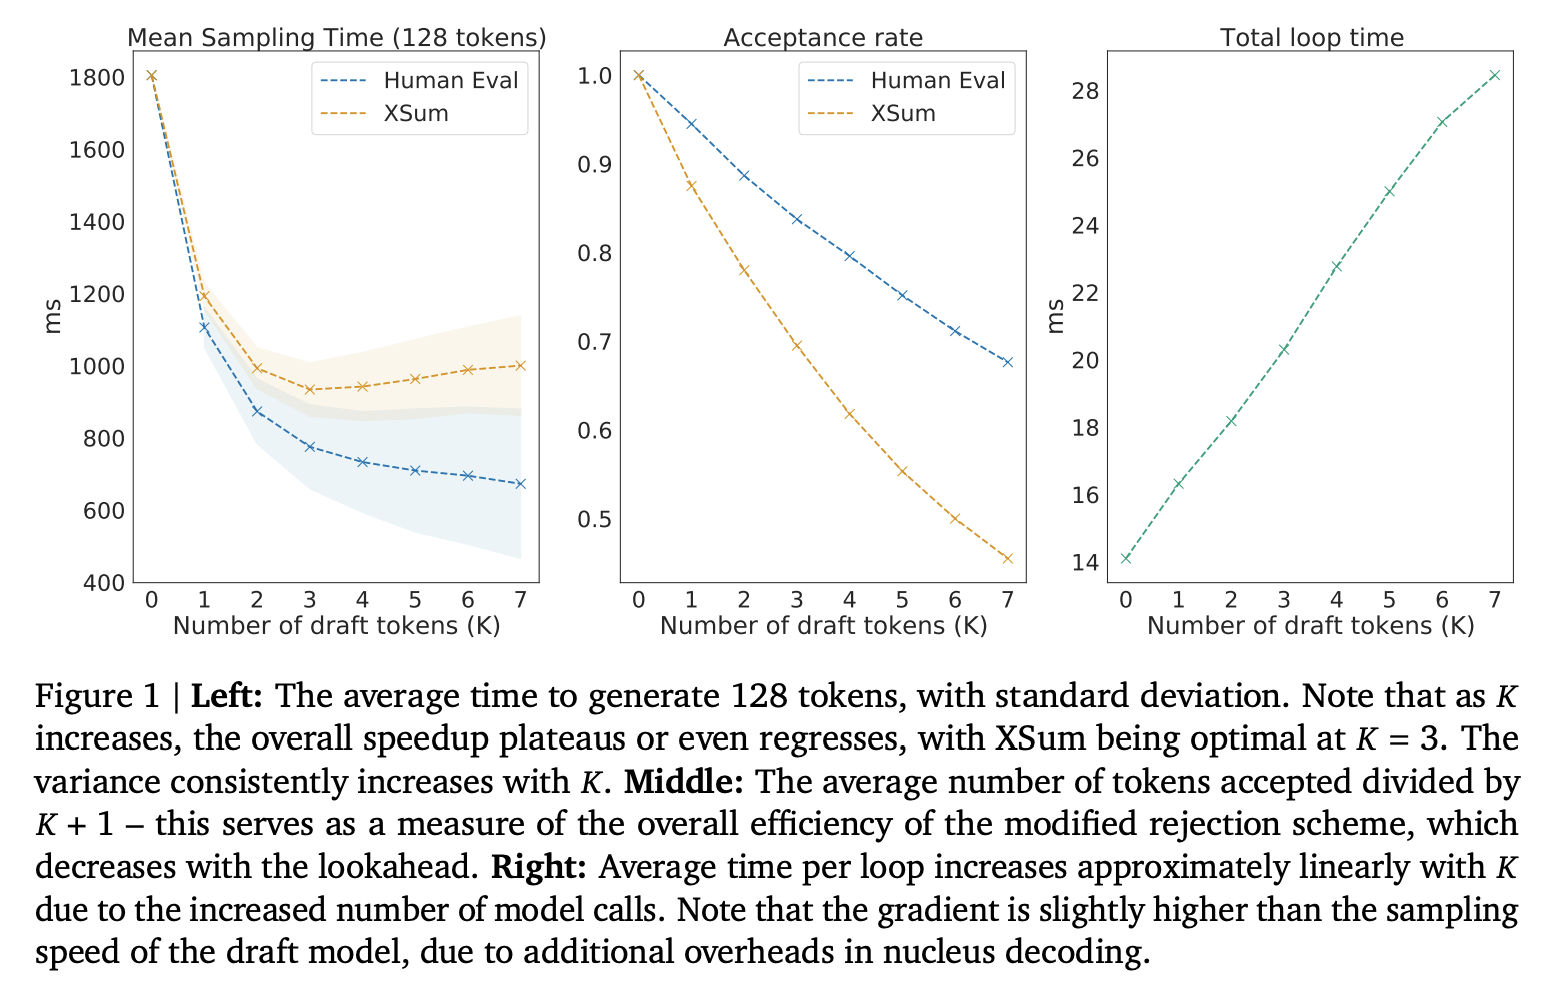
non-greedy decoding에서는 어떻게 될까? 이건 조금 더 복잡하지만, 본질적으로는 Metropolis-Hastings에서 영감을 받은 알고리즘으로 귀결된다. logits에서 유도한 와 이 있고, 이 확률들의 비율이 어떤 문턱값보다 작으면 선택된 토큰을 확률적으로 거부하는 것이다.
이 두 논문이 이를 동시에 유도했으며, 실제로 어떻게 동작하는지에 대한 좋은 예시가 실려 있다.
요점(Takeaway): speculative sampling은 throughput을 내주고 더 나은 토큰당 latency를 얻는 또 하나의 강력한 지렛대다. 그러나 batch size가 제한된 상황(예: 작은 하드웨어 풋프린트 또는 큰 KV cache)에서는 win-win이 된다.
Footnotes
-
역사적으로, 추론을 전혀 건드리지 않고도 Transformer 연구를 놀랄 만큼 많이 할 수 있었다 — scoring 기반 객관식 벤치마크는 제대로 된 KV cache나 generation 루프 구현 없이도 효율적으로 돌릴 수 있다. 그래서 특히 연구용 코드베이스에는 추론 코드패스에 낮게 매달린 과일이 많이 남아 있는 경우가 흔했다. ↩
-
이 장 전체에서 알아차리게 되겠지만, 추론은 학습보다 훨씬 덜 관대하다. 보통 FLOPs는 훨씬 적고, batching의 기회도 적고, latency에 대한 민감도는 훨씬 크다. KV cache 역시 추론을 극적으로 복잡하게 만든다. ↩
-
여기서는 softmax·마스크 적용 등에 드는 non-matmul FLOPs를 무시해 상당히 단순화하고 있다. 이들은 연산이나 HBM 읽기와 겹쳐져야 하지만, 특정 TPU 세대에서는 그게 만만치 않을 수 있다. 이 세부 사항이 핵심 메시지 — KV cache는 대개 memory bound다 — 를 바꾸지는 않지만, 주의를 기울일 가치는 있다. ↩
-
특히 attention 행렬을 materialize하지 않게 해 주는 Flash Attention 덕분이다. ↩
-
학습이 끝난 뒤 실수로 켜진 채로 두는 것은, 성능이 자릿수 단위로 퇴보하는 쉽고 흔한 원인이다. ↩
-
더 작은 batch size로 모델 사본을 실은 서버를 여러 대 띄우라는 뜻이다. 모델 수준의 데이터 parallelism은 엄격히 더 나쁘다. ↩
-
FLOPs 시간이 병목이 아니므로, 걱정해야 할 것은 ICI 시간이 파라미터 로딩 시간을 넘어서는 것이라는 의미에서다. ↩