How to Scale Your Model · Part 4
알아야 할 모든 Transformer 수학
All the Transformer Math You Need to Know
여기서는 Transformer 아키텍처를 빠르게 복습한다. 특히 FLOPs, 바이트 수를 비롯해 관심 있는 여러 양을 어떻게 계산하는지 살펴본다.
내적 개수 세기
다음 shape을 갖는 벡터 , 와 행렬 , 에서 출발하자:
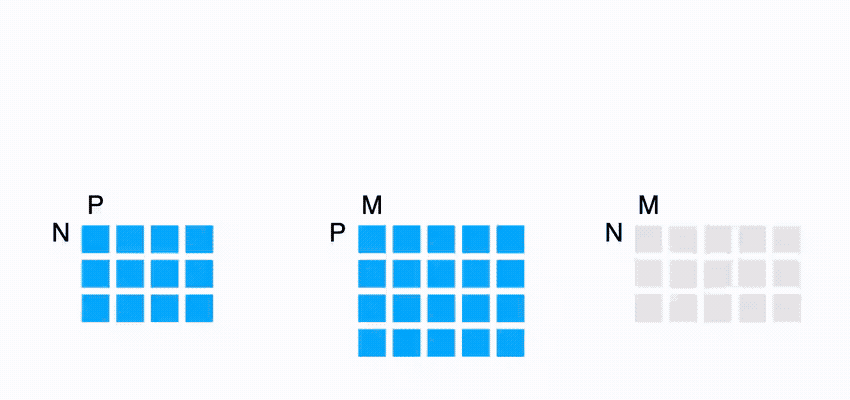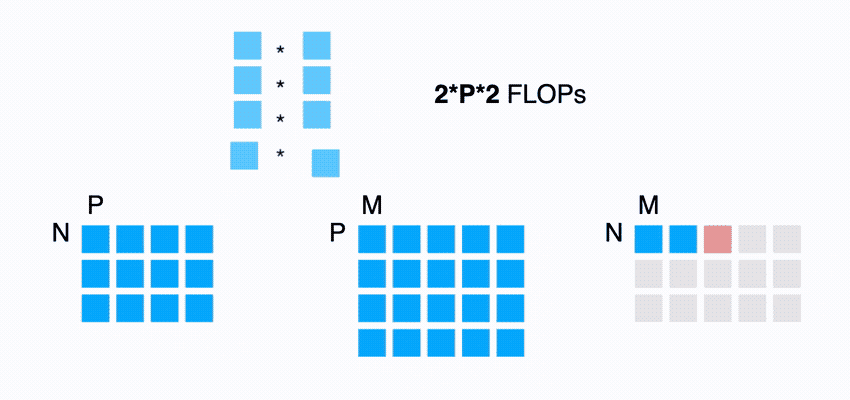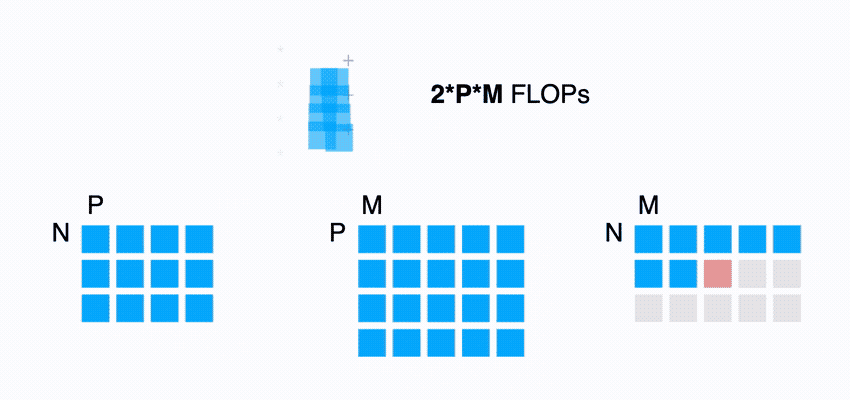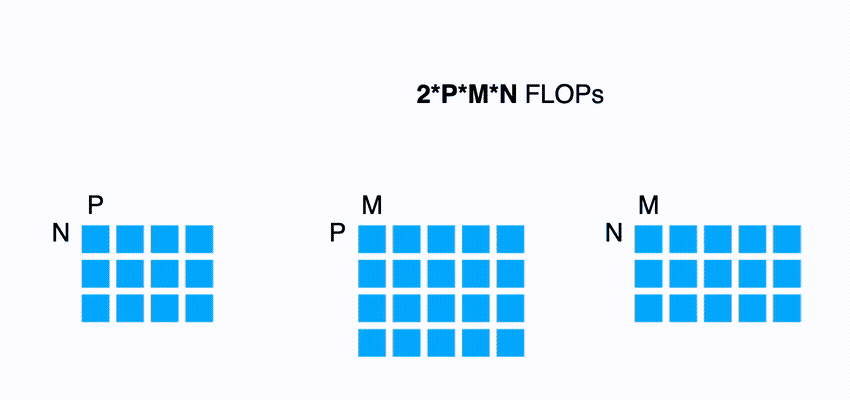
- 의 dot product는 번의 _덧셈_과 곱셈, 즉 총 번의 부동소수점 연산이 필요하다.
- 행렬-벡터 곱 는 의 행을 따라 번의 dot product를 수행하므로 FLOPs다.
- 행렬-행렬 곱 는 의 개 열 각각에 대해 행렬-벡터 곱을 수행하므로 총 FLOPs다.
- 일반적으로 두 고차원 배열 와 가 있고 일부 차원은 CONTRACTING(축약), 일부 차원은 BATCHING(배칭)이라면(예: ), 이 축약(contraction)의 FLOPs 비용은 와 의 모든 차원의 곱의 2배인데, 이때 batch 차원과 contraction 차원은 한 번만 센다(예: ). 어떤 차원이 batching이 되는 것은 두 피연산자 모두에 등장할 때뿐이라는 점에 유의하라. (또 contracting 차원이 하나도 없으면 이것은 그냥 원소별 곱이므로 2배 인자가 적용되지 않는다는 점에도 유의.)1
행렬-행렬 곱에서는 연산량이 세제곱 으로 늘어나는 반면 데이터 이동은 제곱 으로만 늘어난다는 사실을 눈여겨보자. 곧 matmul 크기를 키울수록 compute-포화 한계에 도달하기가 오히려 쉬워진다. 극히 이례적인 성질이며, 행렬 곱셈이 지배하는 아키텍처를 쓰는 이유를 상당 부분 설명해 준다 — scaling에 적합하기 때문이다!
Forward와 reverse FLOPs
학습 중에는 어떤 행렬 곱셈의 결과 자체에는 별로 관심이 없다. 정말 관심 있는 것은 그 미분이다. 그런데 그 미분을 계산하는 비용은 matmul 자체를 수행하는 것보다 약 3배 크다.
B가 더 큰 네트워크 안의 행렬 하나이고 A가 입력 activation이며 C = A B라고 하면, loss L의 B에 대한 미분은 연쇄 법칙(chain rule)으로 주어진다:
이를 계산하는 데는 ( 차원에 대해 축약하므로) FLOPs가 필요하다. 마찬가지로 loss의 A에 대한 미분은
인데, dL/dC가 크기의 행렬이므로 이것도 FLOPs다. 이 양은 파라미터에 대한 미분은 아니지만, 네트워크의 이전 레이어들의 미분을 계산하는 데 쓰인다(위에서 dL/dC가 dL/dB를 계산하는 데 쓰인 것과 마찬가지다).
이를 모두 더하면 추론의 2NPM와 달리 학습 중에는 총 6NPM FLOPs가 든다: forward pass에 2NPM, backward pass에 4NPM이다. PM이 이 행렬의 파라미터 수이므로, 이것이 학습 중 Transformer FLOPs에 대한 그 유명한 근사의 가장 단순한 형태다: 토큰 하나마다 FLOPs가 필요하다는 것. 아래에서 더 정확한 유도를 보인다.
Transformer 회계
Transformer는 미래다. 뭐, 적어도 현재이긴 하다. 몇 년 전만 해도 여러 아키텍처 중 하나였을지 모르지만, 오늘날에는 이 아키텍처의 거의 모든 세부 사항을 알아 둘 가치가 있다. 아키텍처를 여기서 다시 소개하지는 않겠지만 이 블로그와 원조 Transformer 논문이 유용한 참고 자료가 될 것이다.
다음은 Transformer 디코더 아키텍처의 기본 다이어그램이다:
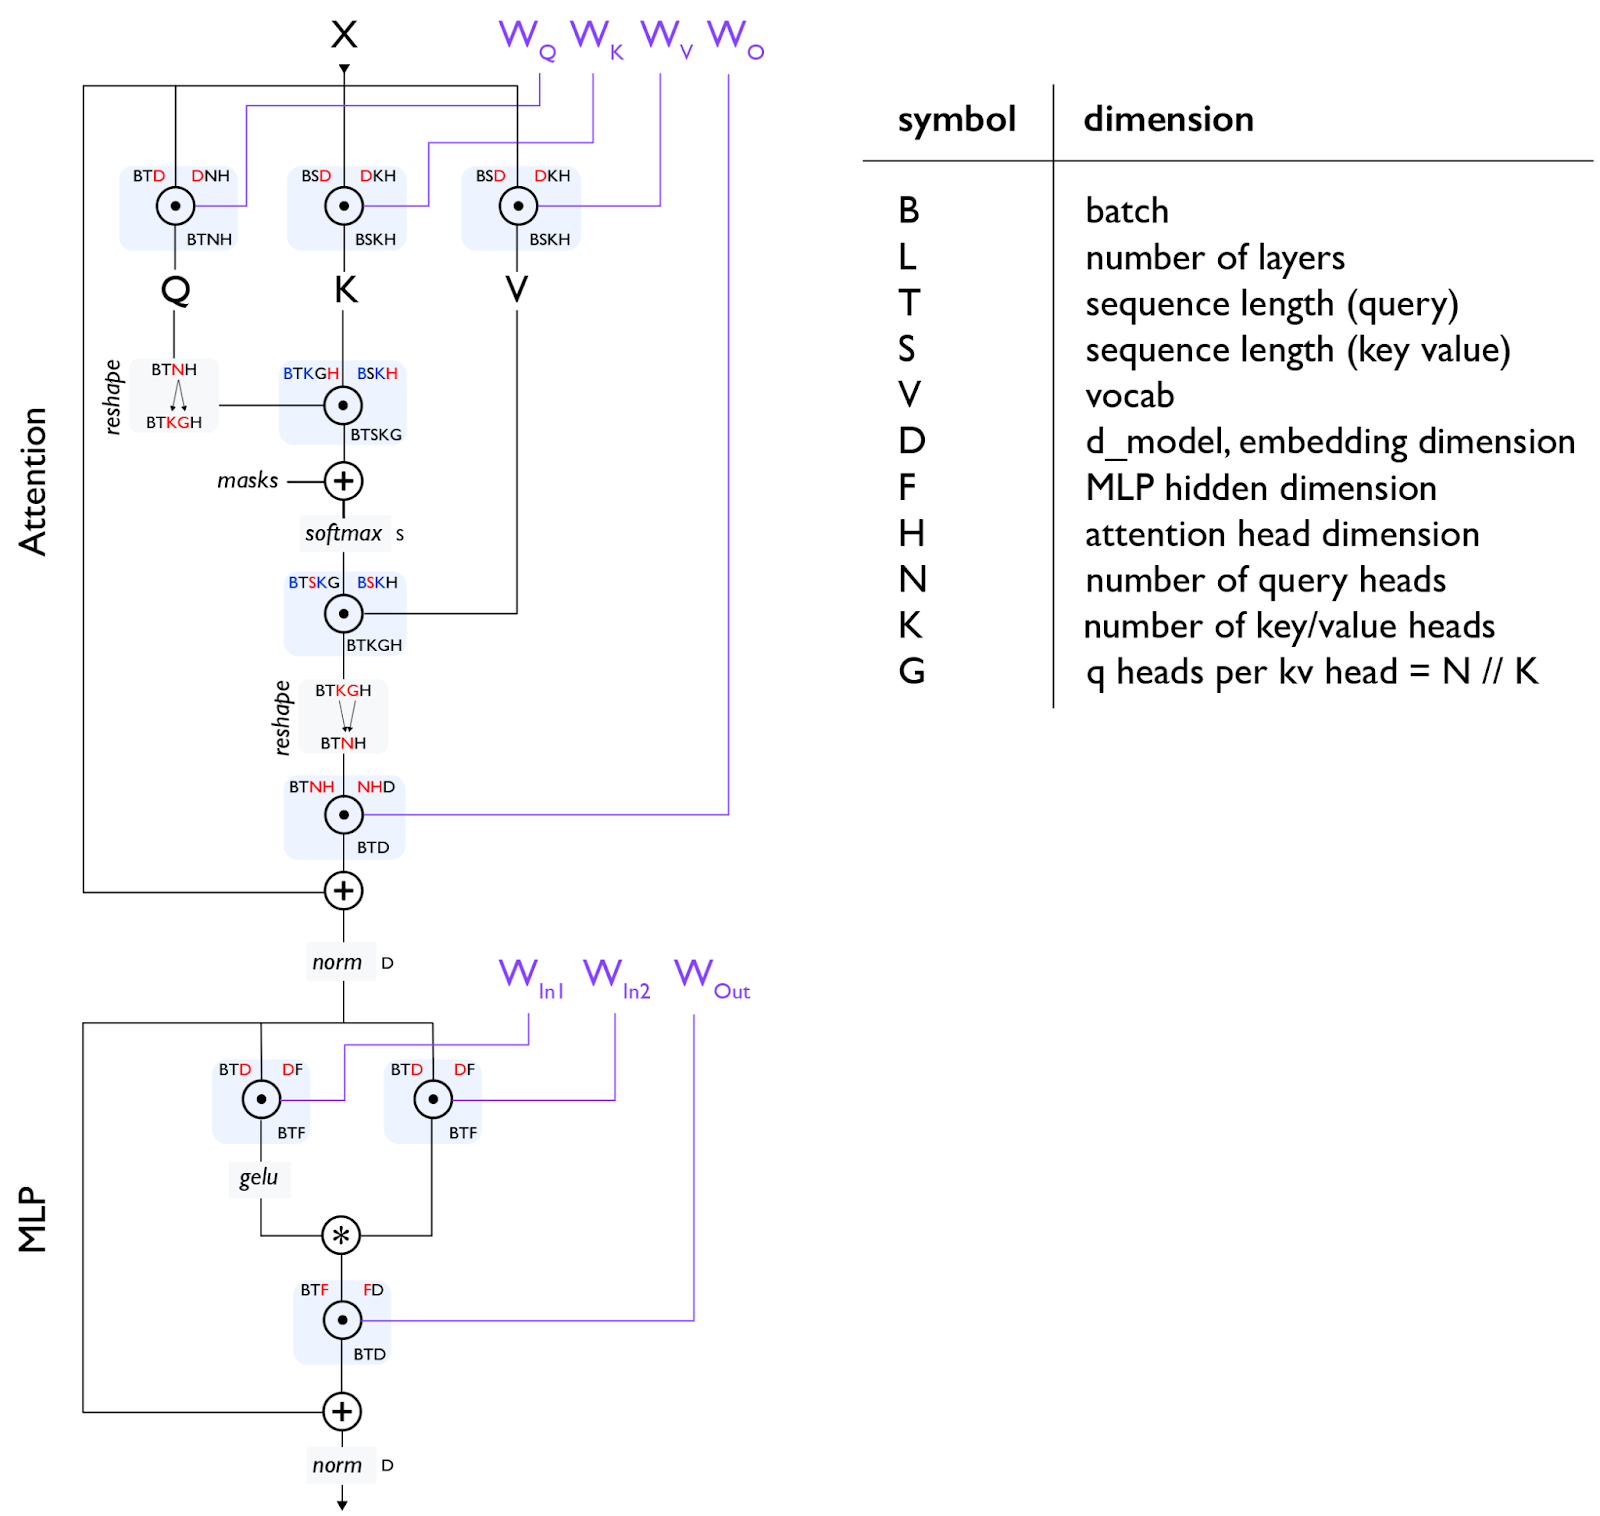
노트 [gating einsum]: 위 다이어그램은 “gating einsum”(Shazeer 2020)을 사용한다. up-projection 행렬을 두 개의 행렬(위의 과 )로 쪼개고, 두 출력을 원소별로 곱해 일종의 “gating 함수”로 쓰는 방식이다. 모든 LLM이 이를 쓰는 것은 아니므로, 행렬이 하나뿐이고 MLP 파라미터 수가 3DF가 아니라 2DF인 경우도 종종 보게 될 것이다. 보통 이 경우에는 파라미터 수를 행렬 3개짜리 경우와 같게 유지하도록 D와 F를 키운다. 어쨌든 LLaMA, DeepSeek을 비롯한 많은 모델이 어떤 형태로든 gating einsum을 사용한다.
노트 2 [MHA attention]: self-attention에서는 T와 S가 같지만 cross-attention에서는 다를 수 있다. 기본적인 Multi-Head Attention(MHA)에서는 N과 K가 같은 반면, Multi-Query Attention(MQA)(Shazeer 2019)에서는 K=1이고, Grouped MQA(GMQA)(Ainslie et al. 2023)에서는 K가 N의 약수이기만 하면 된다.
노트 3 [pre-norm 대 post-norm]: 위 다이어그램은 “pre-norm” 아키텍처라고 불리는 형태를 보여준다. norm이 residual connection 앞에 오며 보통 x + attn(norm(x)) 꼴이다. 오늘날 LLaMA-3 같은 모델들이 이를 쓴다. 원조 Transformer 논문은 layernorm이 residual connection 뒤에 오는 “post-norm” 아키텍처, 즉 norm(x + attn(x))를 사용했다.
전체 FLOPs와 파라미터 계산
Transformer의 레이어당 FLOPs를 계산해 보자(그래야 온갖 곳에 L 인자를 붙이지 않아도 된다). 아래의 학습 FLOPs는 거의 항상 추론 FLOPs의 3배이므로, 어떤 총량이든 3으로 나누면 forward pass만의 비용이 된다는 점을 기억하자.
MLP
Transformer의 MLP는 보통 원소별로 결합되는 입력 matmul 2개와 출력 matmul 1개로 구성된다:
Attention
Q와 KV의 head 수가 서로 다른 일반적인 grouped-query attention의 경우에 대해, Q, K, V projection의 head 차원이 모두 H로 같다고 가정하고 QKVO matmul의 비용을 추정해 보자:
dot-product attention 연산은 좀 더 미묘하다. 사실상 , 차원에 대해 배칭된 matmul, softmax, 그리고 다시 , 차원에 대해 배칭된 matmul이다. 배칭되는 차원은 파란색으로 강조한다:
노트 [causal masking]: 최근 대부분의 Transformer는 완전한 양방향 attention이 아니라 causal mask를 사용한다. 이 경우 dot product 연산의 유효 FLOPs는 절반으로 줄어든다. 실제로 이 절감을 달성하려면 naive한 einsum이 아니라 attention kernel을 사용해야 한다.
기타 연산
Transformer에는 이 밖에도 여러 연산이 있다. layernorm은 상대적으로 저렴해서 1차 비용 추정에서는 무시해도 된다. 각 레이어에는 보통 layernorm이 두 개(attention 앞에 하나, MLP 앞에 하나) 있다는 점만 기억하자. 그리고 마지막에는 (레이어당은 아니지만) 거대한 unembedding 행렬 곱셈이 있다.
Transformer FLOPs의 일반 경험 법칙
(짧은 컨텍스트 학습에서는 합리적인 가정으로) dot-product attention의 비용을 무시하면, 전체 레이어에 걸친 총 FLOPs는
이다. 여기서 attention FLOPs를 무시하고 dense Transformer의 FLOP 수를 추정하는 유명한 경험 법칙이 나온다. (unembedding 역시 FLOPs와 파라미터를 갖는 단순한 matmul이라 같은 경험 법칙을 따른다.)
컨텍스트 길이에 따른 attention 비용의 비중
위의 dot-product attention까지 계산에 넣고 (통상적인 설정대로) , 그리고 를 가정하면, dot-product attention FLOPs와 (attention projection을 포함한) 전체 matmul FLOPs의 비는 다음과 같다:
결론은 학습 중 dot-product attention FLOPs는 T>8D가 되어야 비로소 지배적이 된다는 것이다. D ~ 8k라면 약 64K 토큰에 해당한다. MLP 크기가 커질수록 attention FLOPs의 중요도가 떨어진다는 뜻이니 어느 정도 말이 된다. 큰 모델에서 attention의 제곱 비용은 사실 긴 컨텍스트 학습에 그리 큰 장애물이 아니다. 하지만 더 작은 모델, 예컨대 D=4608인 Gemma-27B에서는 시퀀스 길이 37k 근처부터 attention이 지배적이 된다.2 Flash Attention 역시 긴 컨텍스트의 비용을 완화하는 데 도움이 되는데, 아래 부록 A에서 간단히 다룬다.
기타 수학
Sparsity와 Mixture-of-Experts
Mixture of Experts(MoE) 모델(Shazeer et al. 2017)을 짧게라도 짚고 넘어가지 않을 수 없다. MoE는 표준 Transformer의 단일 dense MLP 블록을, 동적으로 라우팅할 수 있는 독립적인 MLP들의 집합으로 바꾼 것이다. 1차 근사로는 MoE는 레이어당 MLP 블록이 1개가 아니라 E개인 평범한 dense 모델일 뿐이다. 각 토큰은 이 expert들 중 개를 활성화하며, 보통 다. 비율 를 sparsity라고 부르며 대개 8과 64 사이다(예: DeepSeek v3는 사실상 , ). dense 버전과 비교하면 파라미터 수를 배로 늘리는 한편, 토큰당 총 활성 파라미터 수를 배로 만든다.
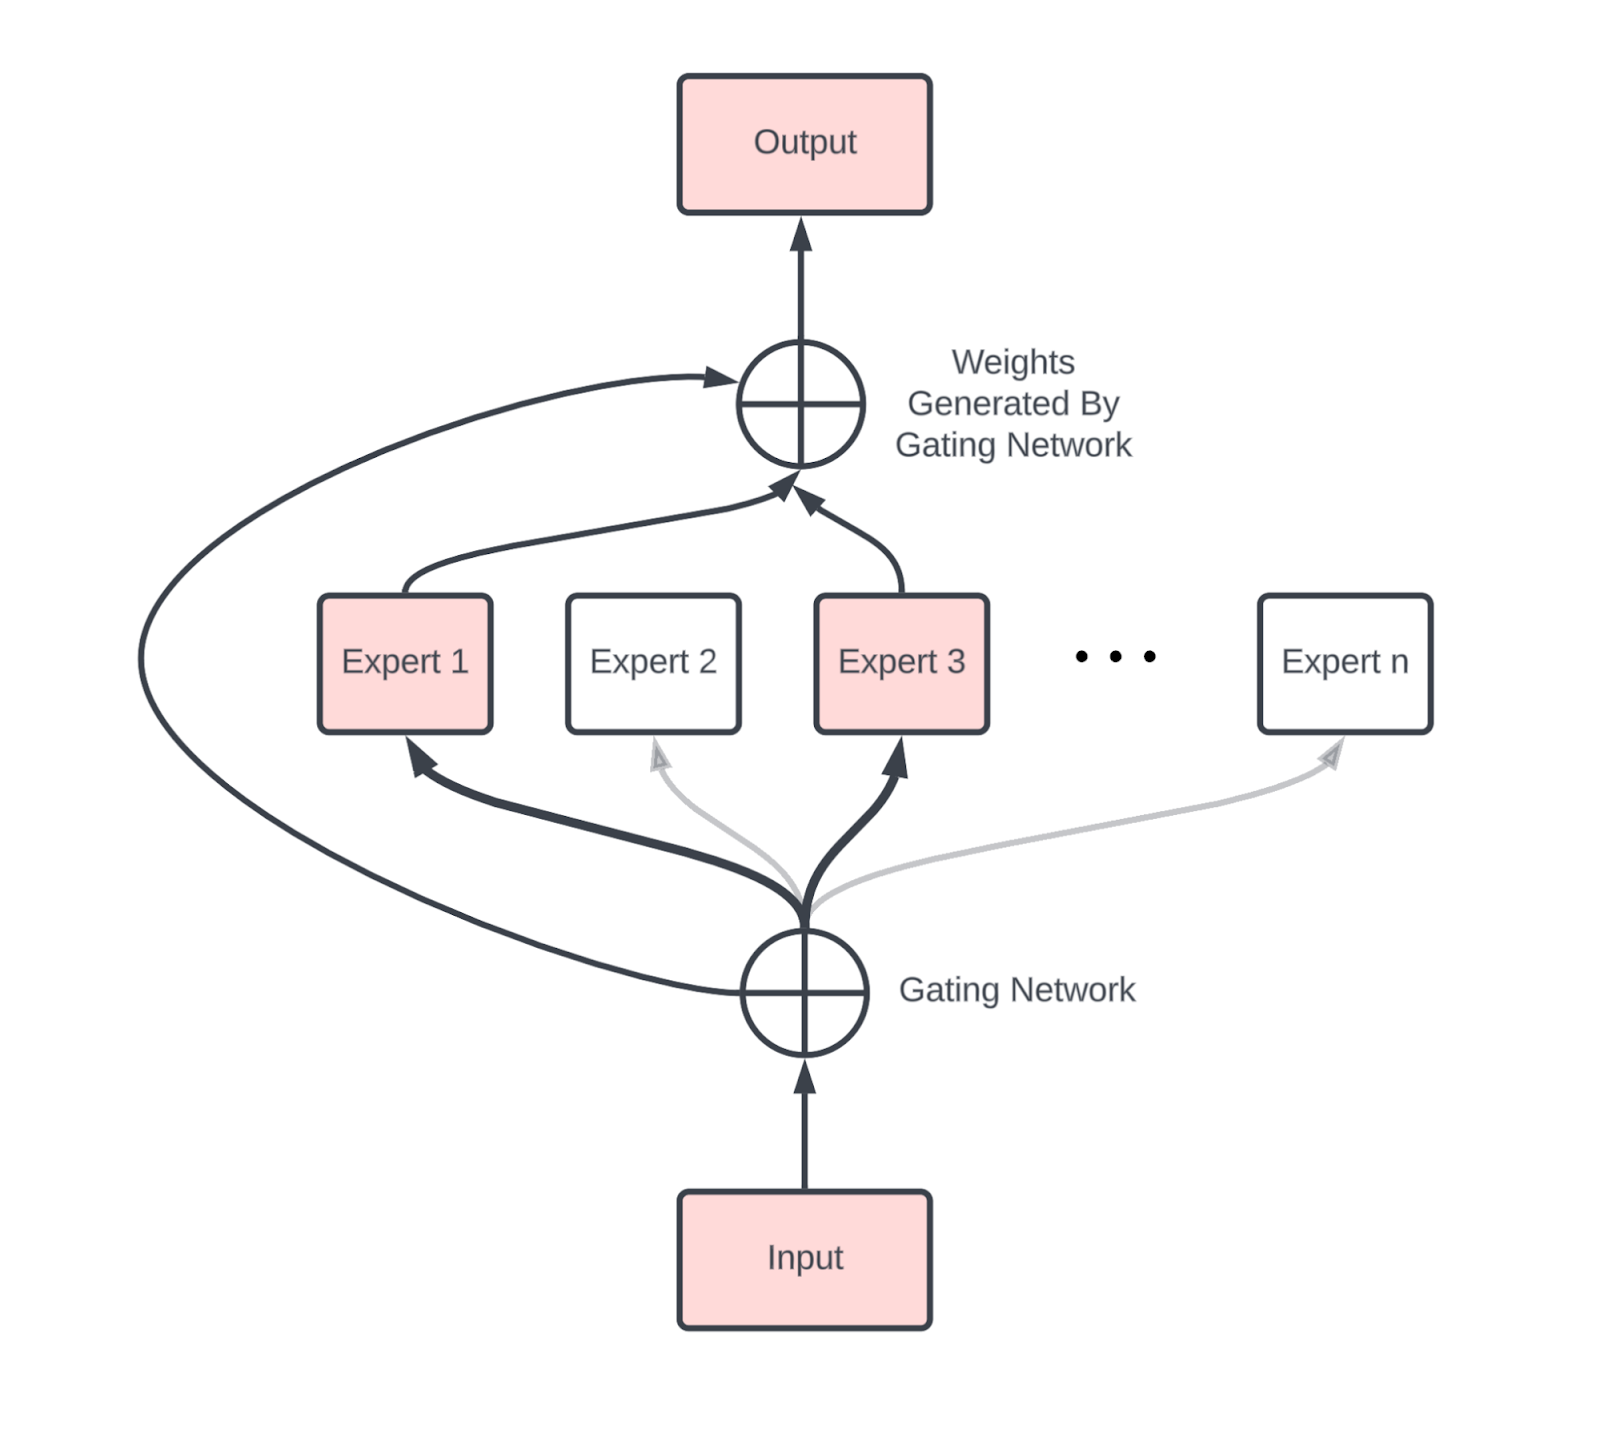
그림: expert가 개인 MoE 레이어 예시. gating expert가 각 토큰을 그중 개로 라우팅하고, 그 개 MLP의 출력이 합산된다. 파라미터 수는 expert 하나 크기의 배지만 토큰마다 그중 개만 사용된다. 출처.
dense 모델과 비교하면 MoE는 새로운 통신을 도입한다. 주로 토큰을 올바른 expert로 보내고 다시 원래 디바이스로 데려오는 두 번의 AllToAll(MoE 블록 앞뒤로 한 번씩)이다.3 다만 앞 장에서 봤듯이 AllToAll 한 번의 비용은 (양방향 링에서는) 단일 axis를 따라 수행하는 비슷한 규모의 AllGather의 1/4에 불과하다.
Gradient checkpointing
알고리즘으로서의 역전파(backpropagation)는 연산을 메모리와 맞바꾼다. backward pass에 FLOPs가 필요한 대신, 의 메모리가 필요하다 — forward pass에서 생성된 모든 중간 activation을 저장하는 것이다. 제곱 연산보다야 낫지만 메모리 면에서는 끔찍하게 비싸다: (배치당 총 4M 토큰), L=64, D=8192인 모델이 불필요한 backward pass 연산을 전부 피하려면 대략 의 activation을 bfloat16으로 저장해야 한다. 20이라는 값은 위 Transformer 다이어그램의 모든 중간 노드를 (대략) 센 데서 나온다. 예를 들어
이므로, 재계산을 피하려면 forward pass의 와 를 저장해 둬야 한다. 이만큼의 메모리를 쓰지 않으려면 중간 activation의 일부만 저장하는 선택지도 있다. 우리가 쓰는 전략 몇 가지는 다음과 같다.
- Block remat: 각 레이어의 입력만 저장한다. 우리가 쓰는 방법 중 가장 공격적인 것으로, 레이어당 checkpoint를 1개만 저장한다. 위 예시라면 4.2TB만 저장하게 된다. 대신 backward pass에서 forward pass FLOPs를 사실상 전부 다시 계산해야 하므로, FLOPs가 에서 대략 로 늘어난다.
- 큰 matmul만 저장: 또 다른 단순한 정책은 큰 matmul의 출력만 저장하는 것이다. 이렇게 하면 backward pass에서 큰 matmul을 다시 계산하는 일은 피할 수 있지만, 다른 활성 함수들과 attention의 일부는 여전히 다시 계산해야 한다. 이 방식은 위의 레이어당 20을 7 근처로 줄여 준다.
이것이 전부는 결코 아니다. JAX를 쓸 때는 보통 jax.remat/jax.checkpoint로 이를 제어한다(자세한 내용은 여기에서 읽을 수 있다).
Key-Value(KV) caching
7장에서 보겠지만, LLM 추론에는 두 가지 핵심 부분, 즉 prefill과 generation이 있다.
- Prefill은 긴 프롬프트를 처리하고 그 attention activation — 구체적으로는 attention 블록의 key-value projection — 을 generation에서 쓸 수 있도록 Key-Value Cache(KV Cache)에 저장한다.
- Generation은 이런 KV cache 여러 개를 배치로 묶어 각각에서 토큰을 샘플링한다.
각 KV cache는 사실상 크기 의 배열이며, 여기서 2는 key와 value의 몫이다. 꽤 크다! int8 기준 Key-Value cache의 총 크기는 이다. 8k 컨텍스트 길이, 64개 레이어, 인 중간 크기 모델이라면 이다. 인 GMQA를 쓰고 싶어지는 이유를 알 수 있다.
이 장에서 무엇을 얻어 가야 하는가?
- Transformer의 전체 파라미터 수와 FLOPs는 계산하기 꽤 쉬우며, MHA를 가정하면 아래에 요약되어 있다(batch size B, vocab size V, 길이 T의 시퀀스, D=dmodel, F=dff 기준):
| 구성 요소 | 레이어당 파라미터 | 레이어당 학습 FLOPs |
|---|---|---|
| MLP | 3DF | 18BTDF |
| Attention | 4DNH | 24BTDNH + 12BT2NH |
| 기타 | 2D | BTD |
| Vocab | DV (전체, 레이어당 아님) | 12BTDV |
- MLP 블록의 파라미터 수가 전체 파라미터 수를 지배하며, 시퀀스 길이가 인 한 FLOPs 예산 역시 MLP 블록이 지배한다.
- 학습 중 총 FLOPs 예산은 합리적인 컨텍스트 길이에서 로 잘 근사된다.
- 추론 중 KV cache는 cache 하나당 대략 이다(K는 KV head 수). 다만 흔히 아키텍처 수정으로 이를 줄인다.
연습 문제
문제 1: , , , 인 모델의 파라미터 수는 몇인가? 그중 attention 파라미터의 비율은 얼마인가? 토큰당 KV cache는 얼마나 큰가? 이고 int8 KV를 쓰는 multi-head attention을 가정해도 좋다.
정답 보기
- 총 파라미터 수는 대략 이다(레이어당 layernorm 2개까지 센 것). 주어진 수치로는 , 즉 16B 파라미터다.
- attention 파라미터 대 전체 파라미터의 비는 일반적으로 이다. 곧 파라미터의 약 1/4이 attention에 쓰인다.
- 토큰당 KV cache는 int8로 , 즉
512 KiB / token이다.
문제 2: {'X': 4, 'Y': 8, 'Z': 4} 위에서 A[BX, DY] *D W[DY, F]를 수행하는 데 필요한 총 FLOPs는 몇인가? 각 TPU가 수행하는 FLOPs는 몇인가?
정답 보기
이 연산의 총 “이론적” FLOPs는 이다. 하지만 연산이 Z 차원에 대해서는 sharding되어 있지 않으므로 실제로는 Z배의 추가 FLOPs를 수행하게 되어, 총 FLOPs다. 연산이 나머지 차원들에 대해서는 sharding되어 있으므로 디바이스당 총량은 대략 이다.
문제 3: 를 수행하는 데 드는 FLOPs는 몇인가?
정답 보기
위의 규칙을 따르면 I와 J가 contracting 차원이고 K, L, M, N, O가 non-contracting 차원이다. “batching 차원”은 없으므로 답은 그냥 , 즉 모든 axis의 곱이다. 공유되는 axis가 있었다면 그 축은 한 번만 셌을 것이다.
문제 4: (Q/K/V/O projection을 무시할 때) self-attention의 arithmetic intensity는 얼마인가? Q 길이 T와 KV 길이 S의 함수로 답하라. attention은 어떤 컨텍스트 길이에서 FLOPs-bound가 되는가? 우리 TPU의 HBM bandwidth가 주어졌을 때, 컨텍스트 길이가 늘어남에 따라 attention의 FFW 블록 대비 유효 상대 비용을 플롯해 보라.
정답 보기
self-attention은 , , activation을 로드한 다음 를 계산하고, 그 결과를 HBM에 다시 써야 한다. 실제로는 Flash Attention으로 수행되므로 이 계산에는 몇 가지 단서가 붙지만, 기본적으로 bf16에서 self-attention은 다음을 수행한다
따라서 총 바이트는 이고, 총 FLOPs는 이며, arithmetic intensity는 이다.
요컨대 prefill 중에는 이므로 arithmetic intensity가 이다. generation 중에는 이므로, 가 아주 크다고 가정하면 이다. 질문을 어떻게 해석하느냐에 따라 다르지만, prefill 또는 학습 중에는 (시퀀스 sharding이 없다고 가정하면) self-attention이 S=240에서 compute-bound가 된다. generation 중에는 가 작기 때문에 결코 compute-bound가 되지 않는다. 그래도 를 키우면 compute-bound에 가까워진다는 것은 알 수 있다.
문제 5: self-attention FLOPs가 QKVO projection FLOPs와 같아지는 시퀀스 길이는 얼마인가?
정답 보기
순전히 가 언제 성립하는가의 문제다. 정리하면 이므로, 예컨대 이면 가 된다. 곧 웬만한 합리적인 컨텍스트 길이에서는 matmul FLOPs가 더 크다.
문제 6: forward pass에서 Transformer 레이어의 주요 matmul 7개(Q, K, V, O + FFW 행렬 3개)의 출력만 저장한다고 하자. backward pass에서 “rematerialize”하는 데 필요한 추가 FLOPs는 몇인가?
정답 보기
7개 matmul 출력(Q, K, V, O, W₁, W₂, W₃)만 저장하면, backward pass에서 를 얻기 위해 두 개의 attention matmul
을 다시 계산해야 한다.
각각은 개의 시퀀스와 개의 head에 대해 배칭된 matmul이므로, 추가 FLOPs는
이다. 그 밖에 다시 계산되는 연산은:
- 과 를 위한 .
- 그리고 을 위한 .
문제 7: DeepSeek v3는 14.8T 토큰에 대해 2.79M H800 시간 동안 학습되었다고 한다(출처). 활성 파라미터가 37B일 때, 대략 어느 정도의 하드웨어 활용률을 달성한 것인가? 힌트: structured sparsity 없이 FP8 FLOPs를 사용했다는 점에 주목하라.
정답 보기
여기의 스펙 시트에서 sparsity 포함 FP8 성능이 3,026 TFLOPs/s임을 확인할 수 있는데, sparsity가 없으면 통상 그 절반(1.513e15 FLOPs/s)이다. 2.79M H800 시간이면 2.79e6 * 1.513e15 * 60 * 60 = 1.52e25 총 FLOPs다. 활성 파라미터 수가 37B이므로 이 학습에는 약 6 * 37e9 * 14.8e12 = 3.3e24 FLOPs가 쓰였어야 한다. 따라서 FLOPs 활용률은 약 3.3e24 / 1.52e25 = 21.7%이다.
문제 8: Mixture of Experts(MoE) 모델은 표준 dense MLP 블록의 복사본을 개 가지며, 각 토큰은 이 expert들 중 개를 활성화한다. TPU v5e에서 weight가 int8인 MoE가 compute-bound가 되려면 토큰 기준 batch size가 얼마나 필요한가? (라우팅되는) expert가 256개이고 인 DeepSeek의 경우 이 수치는 얼마인가?
정답 보기
각 expert의 복사본이 개 있으므로, int8에서는 weight 행렬 하나마다 바이트를 로드해야 한다. 각 토큰이 개의 expert를 활성화하므로 weight 행렬 하나마다 FLOPs는 이다. int8 weight와 bfloat16 FLOPs로 compute-bound가 되려면 arithmetic intensity(로드한 바이트당 FLOPs)가 TPU의 ~240 FLOPs/byte를 넘어야 하는데, 이는 , 즉 일 때다.
따라서 compute-bound가 되려면 가 필요하다. DeepSeek이라면 이다. generation 시점에는 놀랄 만큼 큰 batch size다.
4부는 여기까지! Transformer 학습의 scaling을 다루는 5부는 여기에서 볼 수 있다.
부록
부록 A: Flash Attention은 어떻게 동작하는가?
Transformer를 아주 긴 컨텍스트로 scaling하는 데 대한 전통적인 반론은, attention FLOPs와 메모리 사용량이 컨텍스트 길이에 대해 제곱으로 늘어난다는 것이다. attention의 QK 곱이 shape(B는 batch size, T와 S는 Q와 K의 시퀀스 차원, N은 head 수)을 갖는 것은 사실이지만, 이 주장에는 심각한 단서가 몇 개 붙는다:
- 앞서 언급했듯이 제곱이긴 해도 attention FLOPs는 가 되어야 지배적이 되며, 학습 중에 attention 행렬 하나의 메모리는 메모리에 상주하는 전체 weight와 activation checkpoint에 비하면 작다. sharding까지 되어 있으면 더욱 그렇다.
- attention을 계산하기 위해 attention 행렬 전체를 materialize할 필요가 없다! 국소 합과 국소 최댓값을 계산하면 이 배열의 작은 청크 이상을 materialize하는 일을 아예 피할 수 있다. 총 FLOPs는 여전히 제곱이지만 메모리 부담은 극적으로 줄어든다.
이 두 번째 관찰은 Rabe et al. 2021이 처음 제시했고, 이후 Flash Attention 논문(Dao et al. 2022)에서 다시 등장했다. 기본 아이디어는 attention을 K/V의 청크 단위로 계산하는 것이다. 각 청크에서 국소 softmax와 몇 가지 보조 통계량을 계산한 뒤 다음 청크로 넘기면, 다음 청크가 이를 자신의 국소 청크와 결합한다. 구체적으로 다음을 계산한다:
- M: 시퀀스 차원에 대한 의 누적(running) 최댓값
- O: 시퀀스 차원에 대한 누적 전체 attention softmax
- L: 누적 분모
이것들만 있으면 상수 크기의 메모리만으로 새 최댓값, 새 누적 합, 새 출력을 계산할 수 있다. 어떻게 동작하는지 대략 그려 보면, attention은 다음과 비슷한 연산이다:
최댓값은 수치 안정성을 위해 빼는 것인데, 이므로 빼도 결과에 영향을 주지 않는다. 위 식의 분모만 보자. 연속된 두 개의 key 벡터 청크 과 가 있고 각각에 대해 국소 softmax 합 과 를 계산했다고 하면
다음을 이용해 이 둘을 두 청크를 합친 전체 softmax 합으로 결합할 수 있다.
여기서
이다. 전체 softmax에 대해서도 같은 일을 할 수 있으므로, 임의로 큰 softmax 합을 누적해 나가는 방법이 된다. 다음은 Flash Attention 논문에 실린 전체 알고리즘이다.
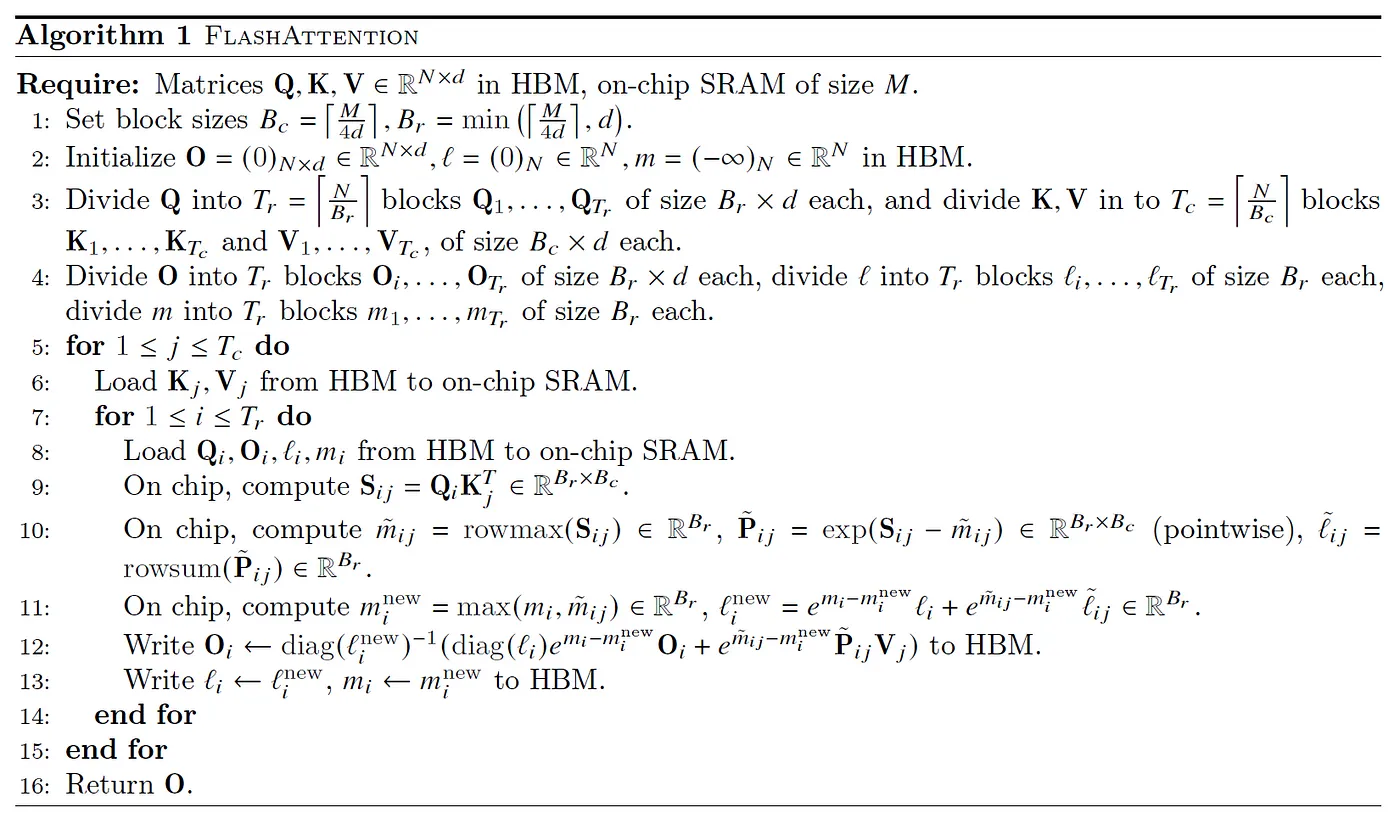
하드웨어 관점에서 보면, 이 방식은 Q 청크를 VMEM(위 알고리즘이 on-chip SRAM이라고 부르는 것)에 넣어 둘 수 있게 해 주어 매 반복마다 KV 청크만 로드하면 되고, 그 결과 arithmetic intensity가 올라간다. 누적 통계량들도 VMEM에 유지할 수 있다.
마지막으로 강조할 만한 미묘한 포인트 하나는, 학습을 위한 Flash VJP(reverse mode 미분) 계산을 실용적으로 만드는 데 쓰이는 attention softmax의 성질이다. 중간 softmax 배열을 다음과 같이 정의하자:
attention에서는 reverse-mode의 dO와 V 배열로부터 dS를 얻는다:
이 gradient를 Q와 K로 역전파하는 과정에서
가 나오는데, 여기서 큰 key 길이(length) 차원에 대한 축약을 국소적인 feature 깊이(depth) 차원에 대한 축약으로 맞바꿀 수 있게 해 주는 항등식을 이용한다.
이 치환은 VJP를 시퀀스-블록 국소 계산으로 구현할 수 있게 하는 데 결정적이며, ring attention 같은 한층 영리한 sharding 스킴도 가능하게 한다.
Footnotes
-
Contracting 차원은 연산 중에 합산되어 사라지는 axis다(두 입력에는 나타나지만 출력에는 나타나지 않는다). 행렬 곱의 안쪽 차원이 그 예다. Batching 차원은 두 입력 모두에 나타나고 출력에도 그대로 전달되는 공유 axis다. 이들은 서로 독립적인 부분 문제들을 인덱싱하며, FLOP 계산에서 서로 곱해지지 않는다. einsum 용어로 말하면: 두 입력과 출력에 모두 있는 라벨은 batching이고, 두 입력에는 있지만 출력에 없는 라벨은 contracting이다. ↩
-
일부 최신 OSS 모델들은 attention 비용을 줄이는 local attention 등의 최적화를 도입하며, 이 경우 이 roofline이 달라진다는 점에 유의하라. ↩
-
엄밀히 말하면 이 통신은 data 또는 sequence sharding이 expert와 같은 axis를 따라 이루어진 경우에만 발생한다. ↩