하드웨어에서 알고리즘을 실행할 때는 세 가지 제약을 받는다: 컴퓨터가 얼마나 빨리 수학 연산을 수행할 수 있는가(OPs/second), 데이터를 옮기는 데 쓸 수 있는 bandwidth(bytes/second), 그리고 데이터를 저장할 총 메모리(bytes). 이 “roofline” 제약 조건들을 이용하면 주어진 연산에 걸리는 시간의 상한과 하한을 어림할 수 있다.
시간은 어디에 쓰이는가?
아주 단순한 질문에서 시작하자: 어떤 알고리즘은 왜 50s나 5ms가 아니라 50ms가 걸리는가? 모델 내부에서 실제로 많은 시간이 걸리는 일은 무엇이고, 얼마나 걸릴 것이라고 기대해야 하는가?
연산(computation): 딥러닝 모델은 사실상 행렬 곱셈 덩어리이며, 각 행렬 곱셈은 부동소수점 곱셈과 덧셈 ‘operation’(FLOPs)으로 구성된다. 이 연산에 걸리는 시간은 가속기의 속도가 결정한다:
예를 들어 NVIDIA H100은 초당 약 9.89e14개의 bfloat161 FLOPs를, TPU v6e는 초당 9.1e14 FLOPs를 수행할 수 있다.2 따라서 1e12 FLOPs를 수행하는 데 H100에서는 (대략) 1e12 / 9.89e14 = 1.01ms, TPU v6e에서는 1e12 / 9.1e14 = 1.1ms가 걸린다.3
칩 내부의 통신: 가속기 내부에서는 텐서가 가속기 메모리(HBM)와 연산 코어 사이를 오가야 한다. 이 링크의 bandwidth는 “HBM bandwidth”라고 불린다.4 H100에서는 약 3.35TB/s이고 TPU v6e에서는 약 1.6TB/s이다.
칩 사이의 통신: 모델을 여러 가속기에 걸쳐 분산하면 텐서를 칩 사이에서 자주 주고받아야 한다. 하드웨어에 따라 이를 위한 선택지가 몇 가지 있고(ICI, DCN, PCIe), 각각 bandwidth가 다르다.
칩 내부 통신이든 칩 간 통신이든 이를 bytes/s로 측정하며, 총 통신 시간은 다음과 같이 추정한다:
일반적으로(항상은 아니지만) 단일 칩 내부의 연산은 칩 내부 및 칩 간 통신과 겹쳐서(overlap) 수행할 수 있다. 곧 연산 시간과 통신 시간 중 최댓값으로 학습·추론 시간의 하한이 잡히고, 둘의 합으로 상한이 잡힌다. 실전에서는 최댓값을 기준으로 최적화한다. 수식이 더 단순하고, 통신과 연산을 겹치면 대개 이 하한에 근접하기 때문이다. 최댓값을 염두에 두고 최적화하면 이므로 하한과 상한의 차이는 최대 2배다. 그 이상의 정확도는 ‘겹침 구간(overlap region)‘과 오버헤드를 모델링해서 얻는데, 이 둘은 특정 모델과 대상 시스템을 프로파일링해서 알아낼 수 있다.
통신과 연산을 완벽히 겹칠 수 있다고 가정하면, 일 때 하드웨어를 온전히 활용하게 된다. 이를 “compute-bound” 상태라고 부른다. 반대로 이면 “communication-bound” 상태가 되기 쉽고,5 가속기 FLOPs/s의 적어도 일부는 데이터가 오가기를 기다리며 낭비된다. 어떤 연산이 compute-bound일지 communication-bound일지 가늠하는 한 가지 방법은 그 연산의 “arithmetic intensity”(연산 강도) 또는 “operational intensity”를 보는 것이다.
정의: 알고리즘의 arithmetic intensity는 수행하는 총 FLOPs를 통신해야 하는 바이트 수(칩 내부든 칩 간이든)로 나눈 비율이다.
Arithmetic intensity는 어떤 연산의 “바이트당 FLOPs”를 측정한다. 1차 근사로, arithmetic intensity가 높으면 가 에 비해 크고 대개 가용 FLOPs의 대부분을 활용한다. 반대의 경우에는 통신에 더 많은 시간을 쓰고 FLOPs를 낭비한다. 이 교차가 일어나는 지점이 하드웨어의 “peak arithmetic intensity”, 즉 가속기의 peak FLOPs/s를 가속기 bandwidth로 나눈 비율이다.
는 가속기가 peak FLOPs/s에 도달하는 arithmetic intensity 값이다. TPU v5e MXU의 경우 약 240 FLOPs/byte다. TPU v5e가 1.97e14 FLOPs/s를 수행하면서 HBM에서 8.2e11 bytes/s를 로드할 수 있기 때문이다.6 어떤 알고리즘의 arithmetic intensity가 240 FLOPs/byte보다 낮으면 바이트 로딩에 발목을 잡혀 하드웨어를 제대로 활용하지 못한다.7 그런 예를 하나 보자:
예시 (dot product): bfloat16 정밀도로 두 벡터의 dot product를 계산하려면, 즉 x • y: bf16[N], bf16[N] → bf16[1]을 계산하려면, 각각 바이트인 와 를 메모리에서 로드하고, 번의 곱셈과 번의 덧셈을 수행한 뒤, 바이트를 HBM에 다시 써야 한다.
일 때 그렇다. 따라서 dot product의 arithmetic intensity는 이다. dot product는 로드한 바이트당 0.5번의 부동소수점 연산을 수행하는 셈이다. 이 값은 하드웨어의 arithmetic intensity보다 낮으므로 communication-bound 상태가 된다.8
Roofline 시각화하기
메모리와 연산 사이의 트레이드오프는 roofline plot으로 시각화할 수 있다. 하드웨어에서 어떤 알고리즘이 달성 가능한 peak FLOPs/s(처리량, y축)를 그 알고리즘의 arithmetic intensity(x축)에 대해 그린 것이다. 다음은 log-log 플롯 예시다:
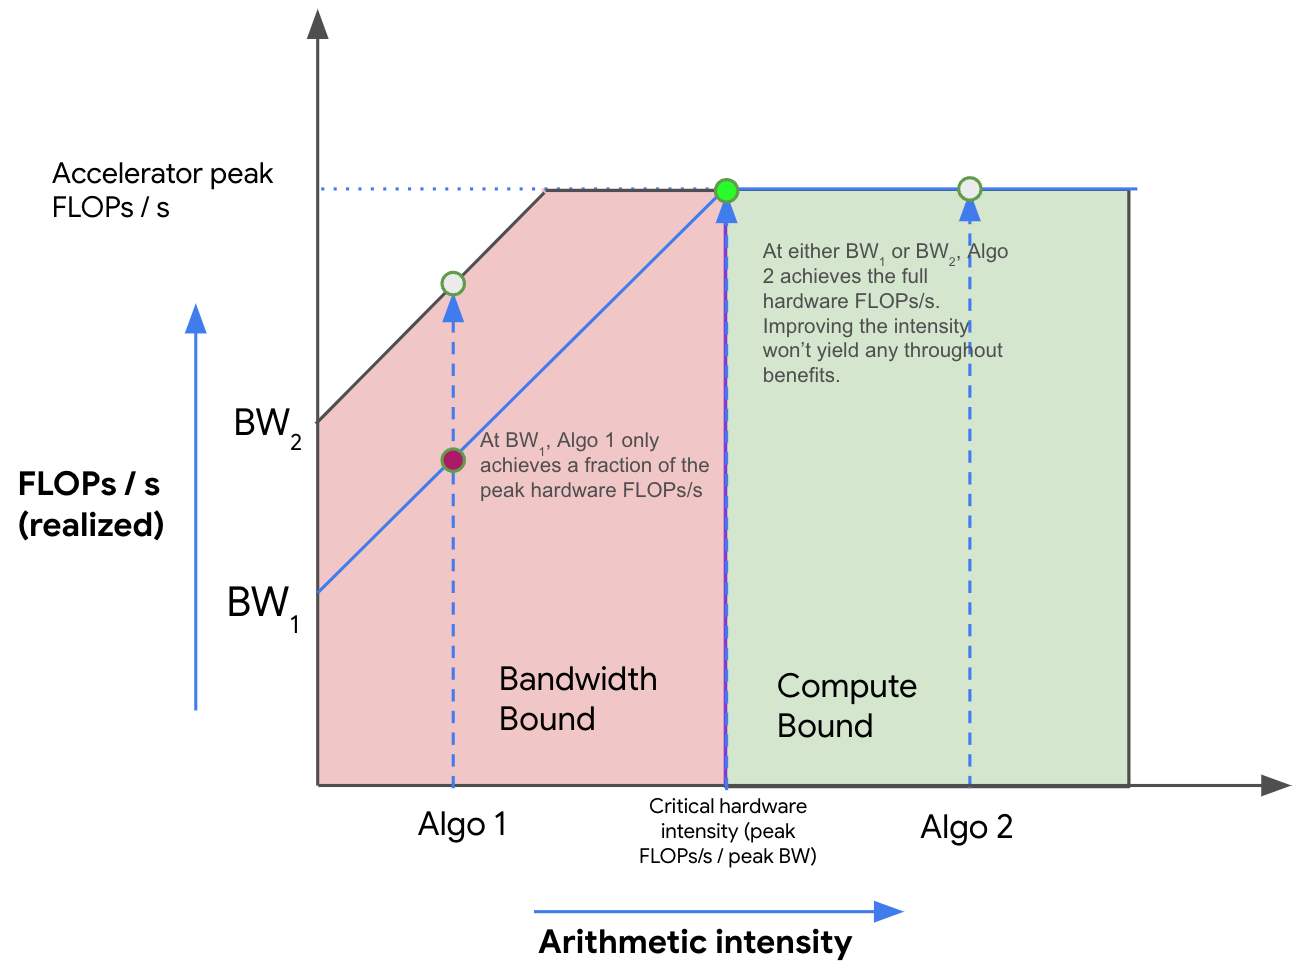
위 그림에서 intensity가 커질수록(왼쪽에서 오른쪽으로) 알고리즘의 성능(FLOPs/s)은 처음엔 선형으로 증가하다가 하드웨어의 임계 arithmetic intensity — TPU v5e의 경우 240 — 에 도달한다. 그보다 intensity가 낮은 알고리즘은 bandwidth(BW)-bound가 되어 peak 메모리 bandwidth에 제한된다(빨간색). 오른쪽에 있는 알고리즘은 FLOPs를 온전히 활용한다(초록색). 여기서 Algo 1은 comms-bound여서 전체 하드웨어 FLOPs/s의 일부만 사용하고, Algo 2는 compute-bound이다. 알고리즘의 성능은 일반적으로 arithmetic intensity를 높이거나 가용 메모리 bandwidth를 늘리면(BW1에서 BW2로) 개선된다.
행렬 곱셈
앞으로 우리의 최애 알고리즘이 될 행렬 곱셈(matmul)을 보자. 로 쓰고, 의 shape은 , 는 , 는 라고 하자. matmul을 수행하려면 바이트를 로드하고, FLOPs를 수행하고, 바이트를 다시 써야 한다.910 따라서:
“batch size” 가 와 에 비해 작다고 가정하면 깔끔하게 단순화된다:
Transformer의 matmul에서는 합리적인 가정이다. 보통 로컬(replica당) batch size가 토큰(시퀀스가 아니라)인 반면 와 이기 때문이다. 따라서 replica당11 batch size가 240 토큰을 넘으면 대체로 compute-bound가 된다. 아주 단순한 규칙이다!
요점(Takeaway): bfloat16 matmul이 대부분의 TPU에서 compute-bound가 되려면 replica당 토큰 batch size가 240보다 커야 한다.12
이 규칙에는 아래 문제들에서 살펴볼 몇 가지 중요한 단서가 붙는다. 특히 quantization과 관련해서 그렇다(예: activation을 quantize했지만 FLOPs는 full-precision으로 수행하는 경우). 그래도 기억해 둘 만한 좋은 규칙이다. GPU에서는 이 수치가 조금 더 높지만(300에 가깝다) 결론은 대체로 같다. 큰 matmul을 작은 matmul들로 분해할 때는 타일 크기도 중요하다.13 더 낮은 수준의 GPU·TPU 세부 사항은 다음 장에서 다룬다.
네트워크 통신 roofline
지금까지 다룬 roofline은 전부 단일 칩 내부의 메모리-bandwidth roofline이었다. 이것이 전부라고 생각하면 안 된다. 사실 이 책에서 중요하게 다룰 roofline의 대부분은 칩 사이의 통신에 관한 것이다. 보통은 여러 TPU에 걸쳐 sharding된 행렬들의 곱셈이 여기에 해당한다.
다소 작위적인 예를 들어 보자. 두 개의 큰 행렬 와 가 2개의 TPU/GPU에 ( 차원을 따라) 균등하게 나뉘어 있고, 이 둘을 곱하고 싶다. (3장에서 보겠지만) 각 TPU에서 각 행렬의 절반씩을 곱한 다음(TPU 0에서 Z0 = X[:, :D // 2] @ Y[:D // 2, :], TPU 1에서 Z1 = X[:, D // 2:] @ Y[D // 2:, :]), 결과로 나온 “partial sum”을 상대 TPU로 복사해 더하면 된다. 각 방향으로 4.5e10 bytes/s를 복사할 수 있고 각 칩에서 1.97e14 FLOPs/s를 수행할 수 있다고 하자. 와 는 얼마인가?
는 각 TPU가 일을 절반씩 하므로 이전의 절반이 된다:14
그럼 는? 이제 이것은 칩 사이의 통신 시간을 가리킨다! 보낸 총 바이트를 네트워크 bandwidth로 나누면 된다:
따라서 (이제는 칩 간 네트워크에 대해) compute-bound가 되는 조건은 즉 , 곧 이다. 이전과 달리 임계값이 가 아니라 에 의존한다는 점에 주목하라. 왜 그런지 생각해 보자. 이것은 하나의 예시일 뿐이지만, 이런 종류의 roofline이 연산을 여러 TPU로 병렬화할 수 있는 시점을 아는 데 결정적이라는 점을 강조해 둔다.
연습 문제
문제 1 [int8 matmul]: TPU/GPU는 낮은 정밀도에서 matmul을 더 빨리 수행할 수 있으므로, matmul 15를 bfloat16(파라미터당 2바이트) 대신 int8 정밀도(파라미터당 1바이트)로 수행하고 싶다고 하자.
- 메모리에서 로드해야 하는 바이트는 몇인가? 메모리에 다시 써야 하는 바이트는 몇인가?
- 총 몇 OPs가 수행되는가?
- Arithmetic intensity는 얼마인가?
- 와 의 roofline 추정치는? 전체 연산 실행 시간의 합리적인 상한과 하한은?
HBM bandwidth는 8.2e11 bytes/s, int8 peak OPs/s는 3.94e14(bfloat16의 약 2배)라고 가정한다.
정답 보기
- 파라미터를 int8로 저장하므로 파라미터당 1바이트다. HBM에서 바이트를 로드하고 바이트를 다시 쓴다.
- bfloat16과 같지만 이론상 int8 OPs/s가 더 빠르다. 여전히 OPs다.
- Arithmetic intensity는 이다. 위와 같이 , 를 가정하면 arithmetic intensity는 가 되어 규칙은 가 된다. 주어진 수치로 int8 intensity는
3.94e14 / 8.2e11 = 480이므로 규칙은 이다. 사실상 달라지지 않았다는 점에 주목! - 이고 이므로, 합리적인 하한은 , 상한은 이다.
문제 2 [int8 + bf16 matmul]: 실전에서는 weight와 activation의 quantization을 다르게 하는 경우가 많다. weight는 아주 낮은 정밀도로 저장하되 activation(과 연산)은 더 높은 정밀도로 유지하는 식이다. weight를 int8로 quantize하되 activation(과 연산)은 bfloat16으로 유지한다고 하자. 어느 batch size에서 compute-bound가 되는가? bfloat16 FLOPs/s는 1.97e14로 가정한다.
힌트: 구체적으로 bf16[B, D] * int8[D, F] -> bf16[B, F]이며 가 “batch size”다.
정답 보기
역시 가 작다고 가정하면 bfloat16 FLOPs는 이지만 weight는 (bfloat16의 가 아니라) 바이트뿐이다. 따라서 , 즉 일 때 compute-bound가 된다. 훨씬 낮아졌다. int8 weight quantization을 할 수 있다면(비교적 쉽다) bfloat16 FLOPs를 그대로 쓰더라도 효율에서 의미 있는 이득을 얻는다(int8 OPs면 더 좋겠지만).
문제 3: 문제 2의 설정에서, 과 에 대해 peak FLOPs/s 대 의 roofline plot을 그려라. 근사가 아니라 정확한 로드 바이트 수를 사용할 것.
정답 보기
문제의 플롯은 다음과 같다:
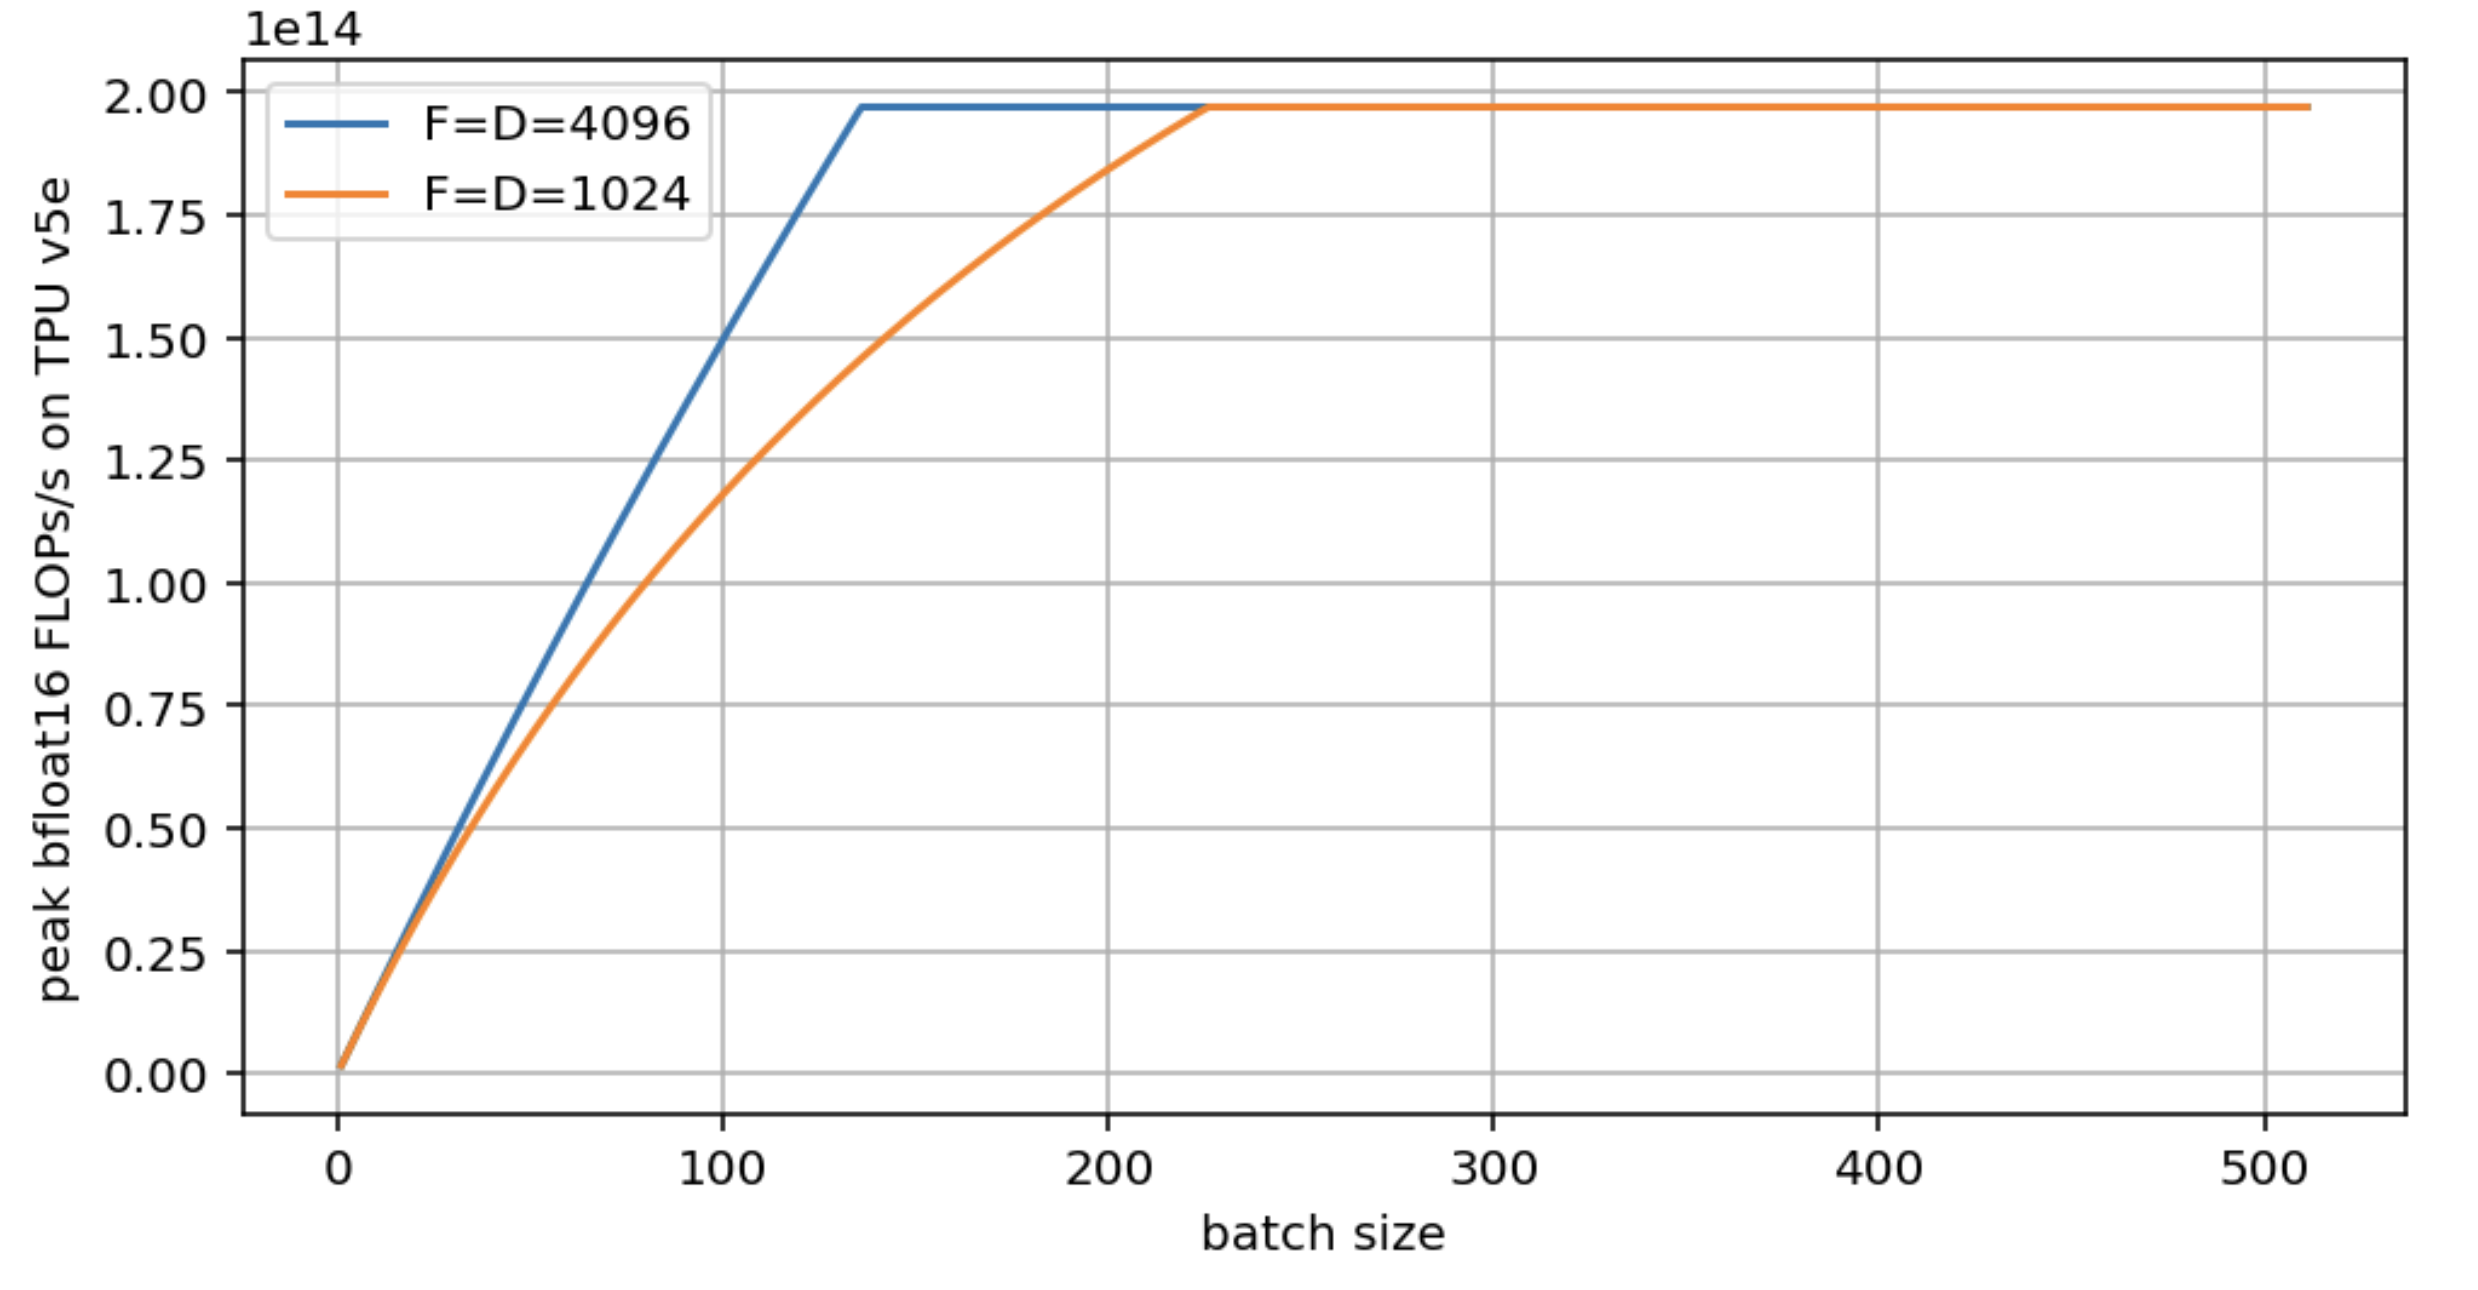
두 모델 모두 결국 하드웨어 peak FLOPs/s에 도달하지만, /가 큰 쪽이 더 빨리 도달한다. 는 임계 batch size가 거의 두 배가 된다. 이 그림을 생성하는 코드는 다음과 같다:
import matplotlib.pyplot as plt
import numpy as np

bs = np.arange(1, 512)

def roofline(B, D, F):
  total_flops = 2*B*D*F
  flops_time = total_flops / 1.97e14
  comms_time = (2*B*D + D*F + 2*B*F) / 8.2e11
  total_time = np.maximum(flops_time, comms_time)
  return total_flops / total_time

roofline_big = roofline(bs, 4096, 4096)
roofline_small = roofline(bs, 1024, 1024)

plt.figure(figsize=(8, 4))
plt.plot(bs, roofline_big, label='F=D=4096')
plt.plot(bs, roofline_small, label='F=D=1024')
plt.legend()
plt.xlabel('batch size')
plt.ylabel('peak bfloat16 FLOPs/s on TPU v5e')
plt.grid()
문제 4: 배치 원소마다 다른 행렬을 곱하는 를 수행한다면? 이 연산의 arithmetic intensity는 얼마인가?
정답 보기
총 FLOPs와 통신량부터 보자.
- 총 FLOPs: 개의 독립적인 곱을 수행하므로 FLOPs는 기본적으로 같다. 단일 matmul과 같은 총 작업량이다(4장에서 더 다룬다). 곧 이다.
- 총 통신량: 여기서는 통신이 훨씬 많다: .
- 따라서 arithmetic intensity는 가 된다. 분모에서 가 지배적이므로 대략 이다. batch size에 의존하는 대신 사실상 상수가 되었다. 무엇을 하든 거의 항상 comms-bound가 된다는 뜻이니 나쁜 소식이다.
문제 5 [GPU의 메모리 roofline]: NVIDIA가 제공하는 H100 SXM 스펙 시트를 이용해, bfloat16 행렬 곱셈이 compute-bound가 되는 batch size를 계산하라. Tensor Core FLOPs 수치는 structured sparsity에서만 달성 가능한 값이라 실제 값의 2배로 적혀 있다는 점에 주의.
정답 보기
스펙 시트에 보고된 bfloat16 FLOPs 값은 1.979e15 FLOPs/s인데 “with sparsity”라는 각주가 붙어 있다. sparsity가 없는 실제 값은 그 절반, 즉 9.89e14 FLOPs/s이다. 메모리 bandwidth는 3.35TB/s, 곧 3.35e12 bytes/s이다. 따라서 는 9.89e14 / 3.35e12 = 295로, TPU와 꽤 비슷하다.
1부는 여기까지! 실제 TPU가 FLOPs와 통신을 어떻게 처리하는지 다루는 2부는 여기에서 볼 수 있다.
Footnotes
-
H100과 B200은 보통 공칭 peak FLOPs의 80–85% 정도만 달성하는 반면, TPU는 일반적인 사용에서 95%에 가깝게 도달할 수 있다. ↩
-
두 칩의 가격이 다르다는 점에 유의하라. 이 비교는 비용으로 정규화한 것이 아니다. ↩
-
NVIDIA는 이를 “memory bandwidth”라고도 부른다. ↩
-
이 책에서는 “communication-bound”, “comms-bound”, “memory-bound”, “bandwidth-bound”를 서로 바꿔 가며 쓴다. ↩
-
MXU는 TPU의 행렬 곱셈 유닛(matrix multiply unit)이다. TPU에는 원소별(elementwise) 연산을 담당하는 VPU 등 peak FLOPs/s가 다른 가속 유닛들도 있으므로 여기서 MXU를 특정했다. ↩
-
알고리즘이 weight를 HBM에서 로드하고 MXU에서 실행되는 경우에만 성립한다. 다음 장에서 다루겠지만 파라미터를 훨씬 bandwidth가 높은 VMEM에 저장할 수도 있다. 또 많은 알고리즘은 성능 특성이 다른 VPU에서 실행된다. ↩
-
위의 240이라는 수치는 여기서 올바른 비교 기준이 아니다. 다음 장에서 보겠지만 dot product는 MXU가 아니라 VPU에서 수행된다. TPU v5p의 VPU는 코어당 초당 약 7e12 FLOPs를 수행할 수 있으므로 임계 intensity는 약 3이고, 따라서 여전히 어느 정도 comms-bound다. 어느 쪽이든 intensity가 낮고 상수라는 사실은 대부분의 하드웨어에서 compute-bound가 되기 어렵다는 뜻이다. ↩
-
엄밀히는 FLOPs를 수행하지만 이 정도면 충분히 가깝다. 번의 곱셈과 번의 덧셈에서 나온 값이다. 자세한 내용은 4장에 있다. ↩
-
matmul의 출력은 엄밀히는 float32이지만 보통 HBM으로 복사하기 전에 bfloat16으로 캐스팅한다. ↩
-
“replica당”이라고 말하는 이유: matmul에 쓰는 칩 수를 늘리기 위해 모델을 sharding하면 가용 연산량과 메모리 bandwidth가 같은 비율로 늘어난다. 따라서 임계 batch size는 모델 weight의 독립적인 복사본 하나당 기준으로 성립한다. ↩
-
통상적인 의미의 batch size(시퀀스 단위)가 아니라는 점에 유의하라. 대부분의 roofline은 토큰이 같은 시퀀스에 속하든 아니든 순전히 토큰 수에만 의존한다. 예컨대 2048개의 GPU에서 4096 토큰짜리 시퀀스 512개의 배치를 돌리면 총 batch size는
512 * 4096 = 2M토큰이고 로컬 batch size는 1k 토큰이다. ↩ -
큰 행렬 곱셈을 할 때는 이를 더 높은 bandwidth의 온칩 메모리인 VMEM/SMEM/TMEM에 들어가는 작은 타일로 쪼개야 한다. 이 때문에 청크를 여러 번 로드하게 되어, 바이트만 로드한다는 말이 더 이상 정확히 성립하지 않는다. 타일 크기 , , 으로 matmul을 생각하자. 등으로 두면, 총 FLOPs는 이고 총 바이트는 이다. 마지막 항을 무시하면 intensity는 으로, 위 결과와 비슷하다. ↩
-
두 partial sum을 더하는 데 필요한 FLOPs(번의 덧셈)는 무시했는데, 기본적으로 무시해도 될 수준이다. ↩
-
이 책 전반에서 표기는 차원에 대해 축약(contraction)하는 곱셈을 뜻한다. einsum 표기를 남용한 것이다. ↩