LLM 학습은 종종 연금술처럼 느껴지지만, 모델의 성능을 이해하고 최적화하는 일까지 그럴 필요는 없다. 이 책의 목표는 언어 모델 스케일링의 과학을 신비의 영역에서 끌어내리는 것이다: TPU(와 GPU)는 어떻게 동작하고 서로 어떻게 통신하는지, LLM은 실제 하드웨어에서 어떻게 실행되는지, 그리고 학습과 추론에서 모델을 어떻게 병렬화해야 대규모에서도 효율적으로 돌아가는지. “이 LLM을 학습시키는 데 비용이 얼마나 들어야 하지”, “이 모델을 직접 서빙하려면 메모리가 얼마나 필요하지”, “AllGather가 뭐지” 같은 궁금증을 품어 본 적이 있다면, 이 책이 유용하기를 바란다.
딥러닝의 많은 부분은 여전히 일종의 흑마법으로 귀결되지만, 모델의 성능을 최적화하는 일은 그럴 필요가 없다 — 아무리 큰 규모라 해도! 비교적 단순한 원리들이 어디에나 — 가속기 하나를 다룰 때부터 수만 개를 다룰 때까지 — 적용되며, 이를 이해하면 다음과 같은 유용한 일들을 할 수 있다:
- 모델의 각 부분이 이론적 최적치에 얼마나 가까운지 어림잡는다.
- 서로 다른 규모에서 서로 다른 병렬화(parallelism) 방식(연산을 여러 디바이스에 어떻게 나눌지)에 대해 근거 있는 선택을 한다.
- 큰 Transformer 모델을 학습시키고 실행하는 데 필요한 비용과 시간을 추정한다.
- 특정 하드웨어의 특성을 활용하는 알고리즘을 설계한다.
- 현재 알고리즘의 성능을 무엇이 제한하는지에 대한 명시적 이해를 바탕으로 하드웨어를 설계한다.
요구되는 배경지식: LLM과 Transformer 아키텍처에 대한 기본적인 이해는 있다고 가정하지만, 대규모에서 어떻게 동작하는지까지 알 필요는 없다. LLM 학습의 기초는 알고 있어야 하고, JAX에 기본적으로 친숙하다면 이상적이다. 유용한 배경 읽을거리로는 Transformer 아키텍처에 관한 이 블로그 글과 원조 Transformer 논문이 있다. 함께 읽거나 이후에 읽을 만한 자료는 이 목록도 참고하라.
목표와 피드백: 이 책을 다 읽고 나면, 주어진 하드웨어 플랫폼에서 Transformer 모델에 가장 적합한 병렬화 방식을 추정하고 학습과 추론이 대략 얼마나 걸릴지 가늠하는 일이 편안하게 느껴져야 한다. 그렇지 않다면 이메일을 보내거나 댓글을 남겨 달라! 어떻게 하면 더 명확해질지 우리도 알고 싶다.
NVIDIA GPU를 다루는 새로 추가된 12부도 재미있게 읽어볼 만하다!
왜 신경 써야 하는가?
3~4년 전만 해도 대부분의 ML 연구자가 이 책의 내용을 알아야 할 일은 없었을 것이다. 하지만 오늘날에는 “작은” 모델조차 하드웨어 한계에 바짝 붙어 돌아가기 때문에, 새로운 연구를 하려면 대규모에서의 효율을 고민할 수밖에 없다.1 벤치마크에서의 20% 향상이 roofline 효율의 20% 손해를 대가로 얻은 것이라면 의미가 없다. 유망한 모델 아키텍처들이 대규모에서 효율적으로 실행될 수 없어서, 혹은 아무도 그렇게 만드는 수고를 들이지 않아서 실패하는 일이 반복된다.
“모델 스케일링”의 목표는 학습이나 추론에 쓰는 칩 수를 늘릴 때 throughput이 그에 비례해 선형으로 증가하도록 만드는 것이다. 이를 “strong scaling”이라고 부른다. 칩을 추가하는 것(“병렬화”)은 보통 연산 시간을 줄여 주지만, 칩 사이의 통신이 늘어나는 비용이 따라온다. 통신이 연산보다 오래 걸리면 “communication-bound” 상태가 되어 strong scaling이 불가능해진다.2 이런 병목이 어디서 생길지 예상할 수 있을 만큼 하드웨어를 잘 이해한다면, 병목을 피하도록 모델을 설계하거나 재구성하면 된다.3
이 책의 목표는 TPU(와 GPU) 하드웨어가 어떻게 동작하는지, 그리고 Transformer 아키텍처가 현재 하드웨어에서 잘 돌아가도록 어떻게 진화해 왔는지 설명하는 것이다. 새로운 아키텍처를 설계하는 연구자와 현세대 LLM을 빠르게 돌리기 위해 애쓰는 엔지니어 모두에게 유용하기를 바란다.
전체 개요
이 책의 전체 구조는 다음과 같다:
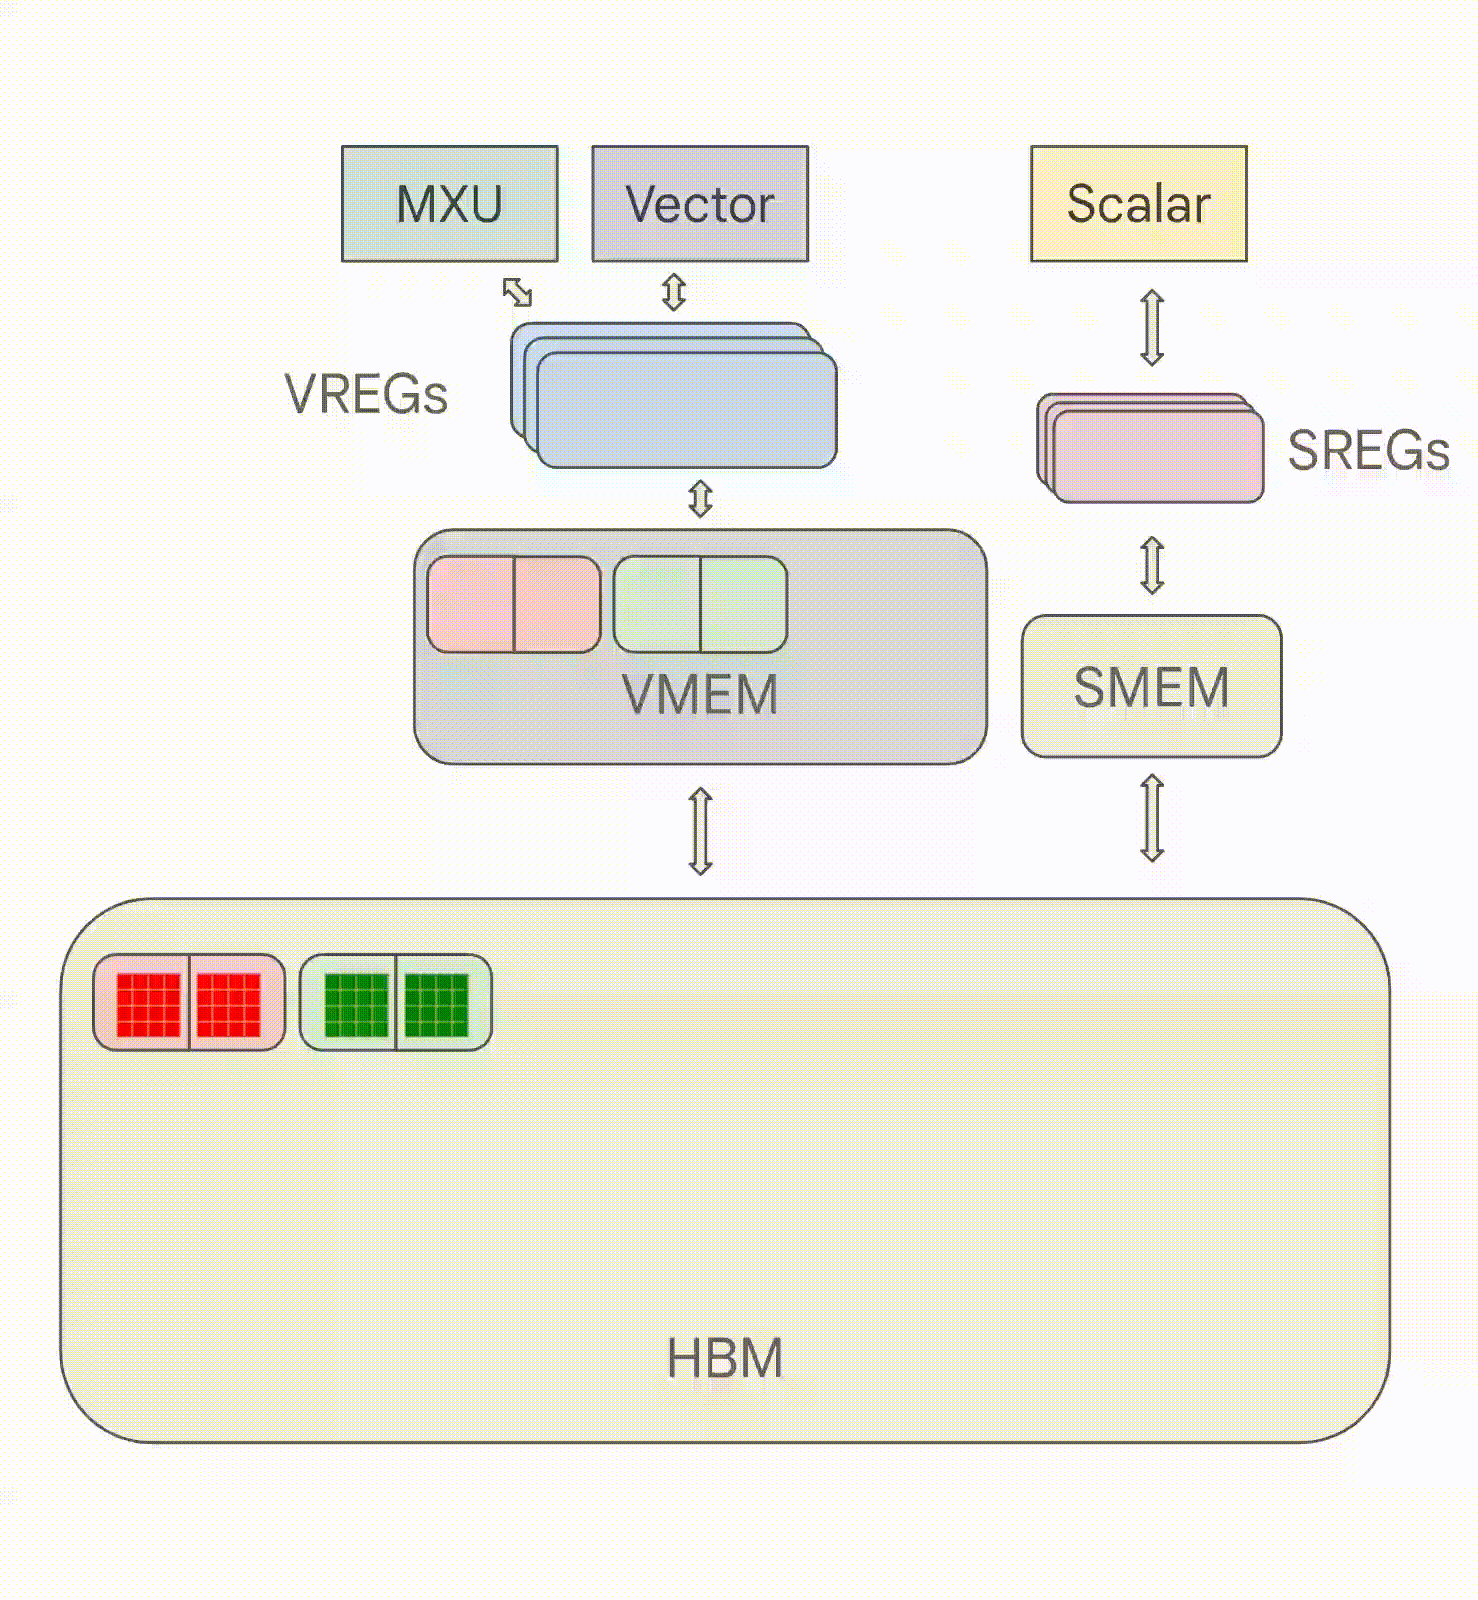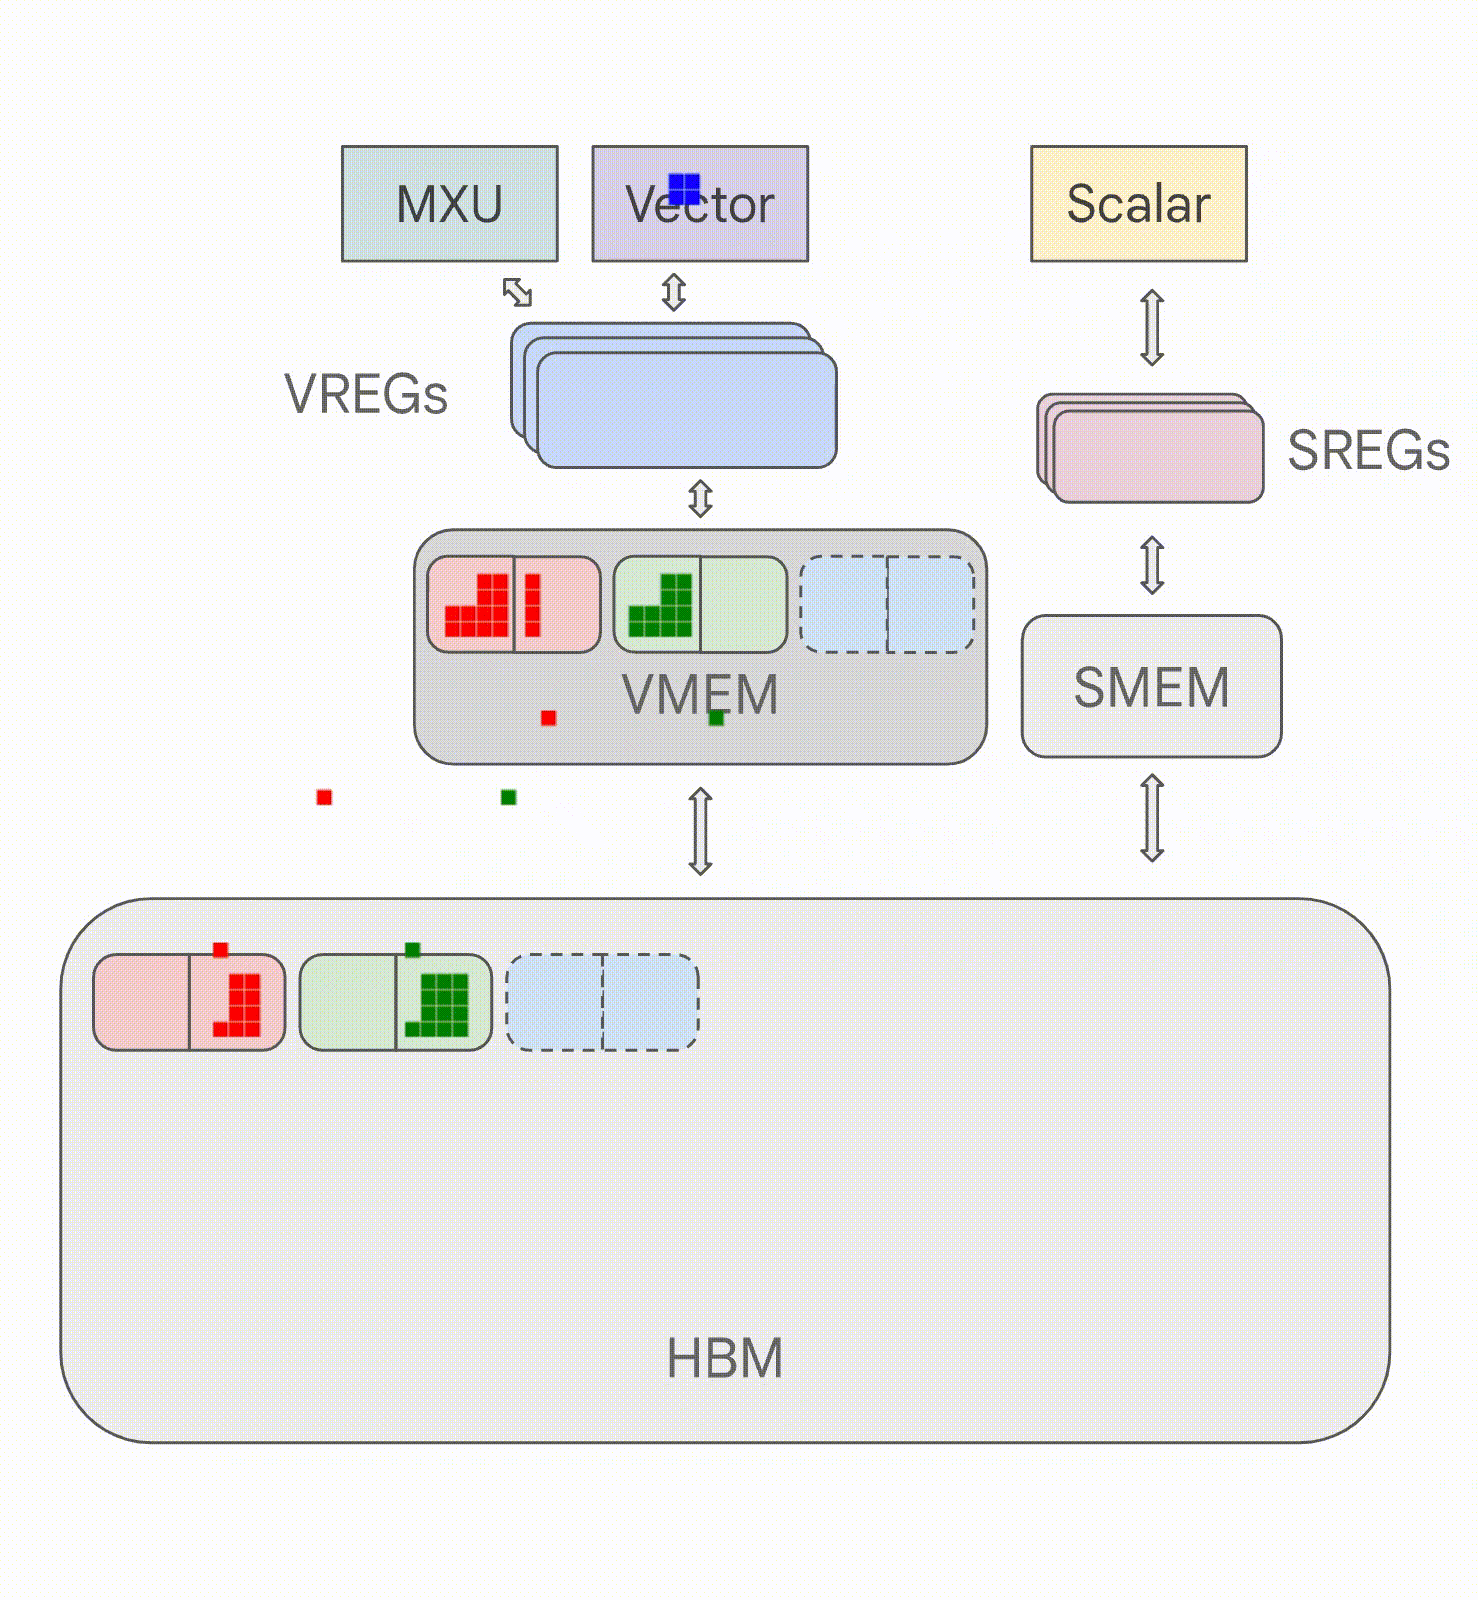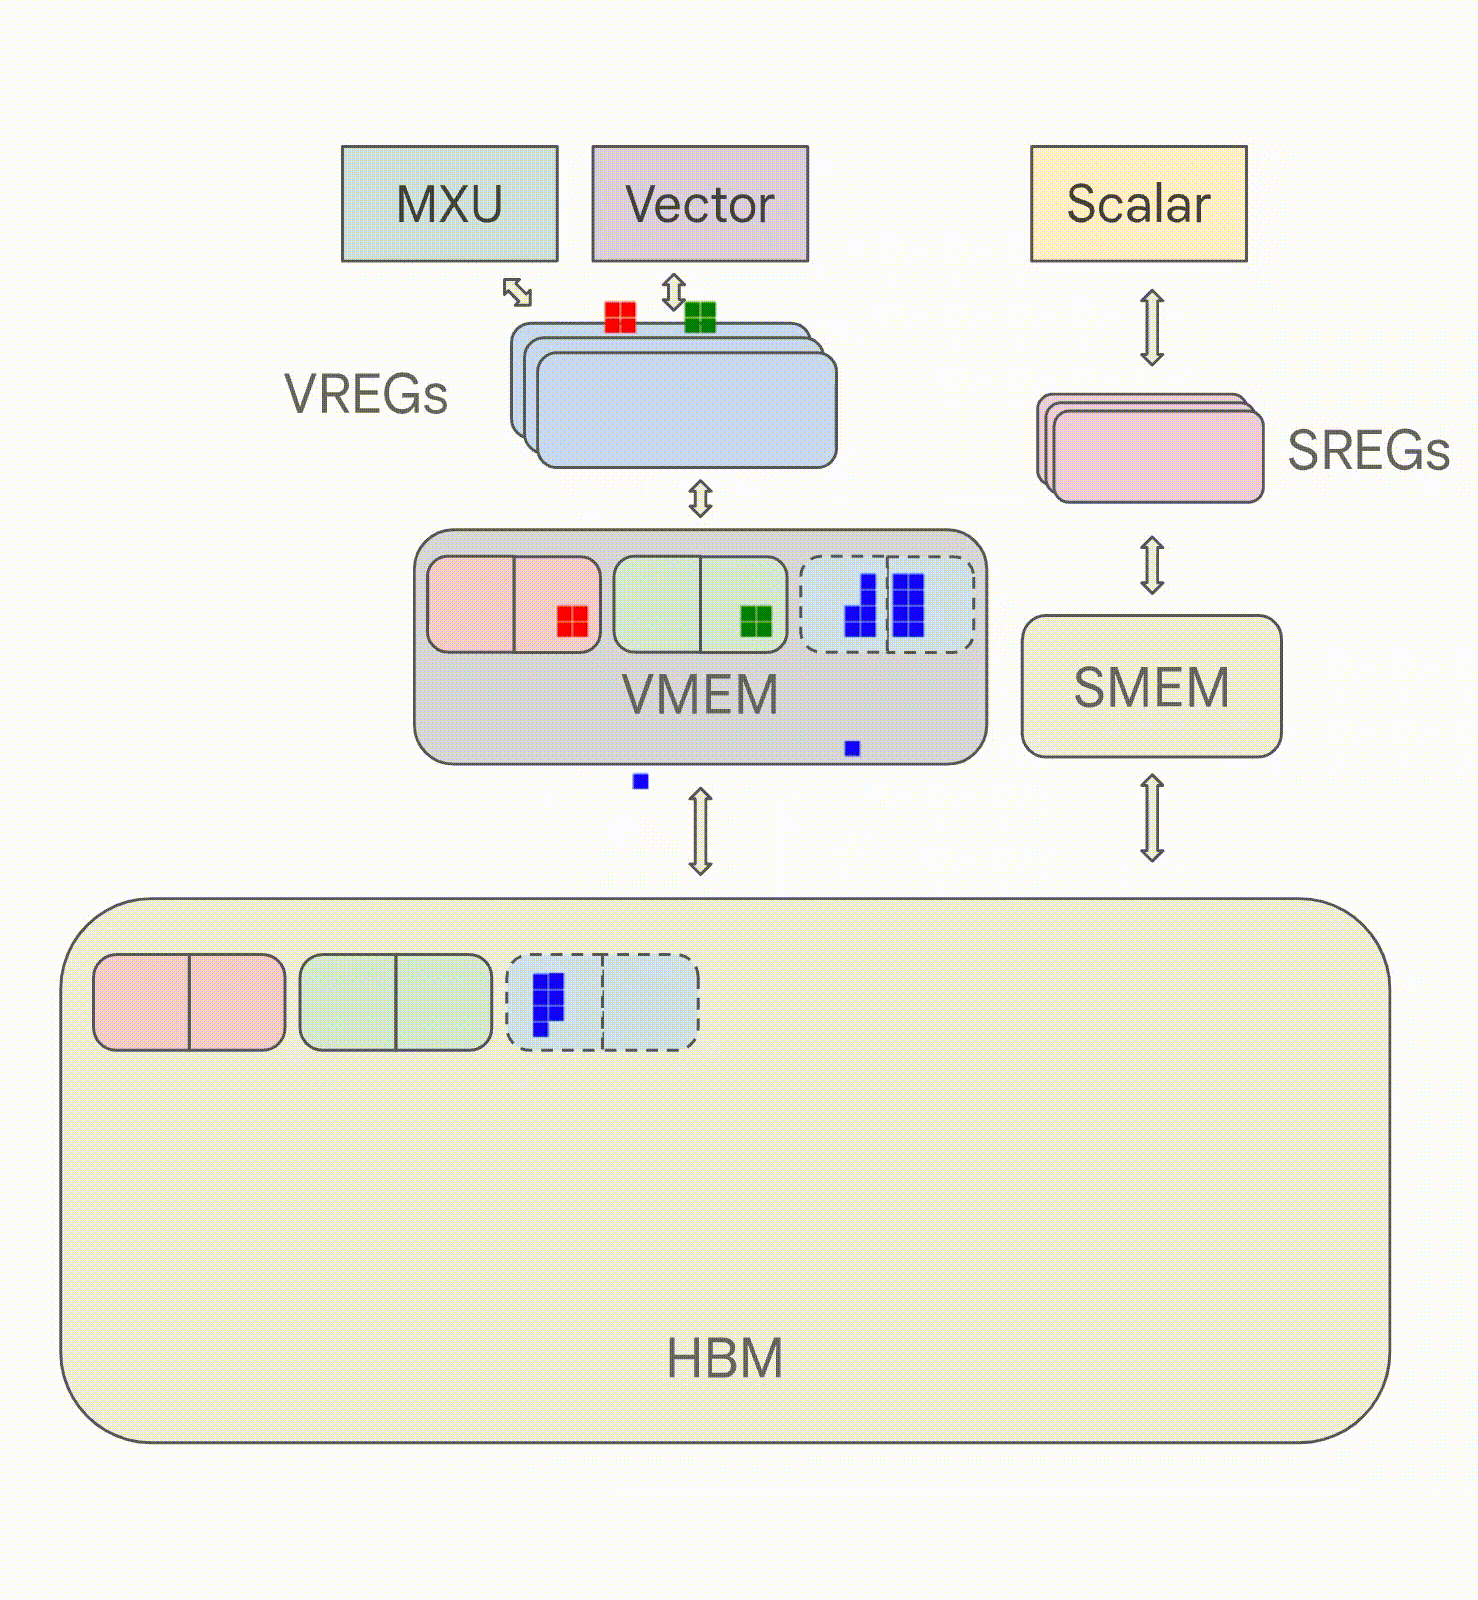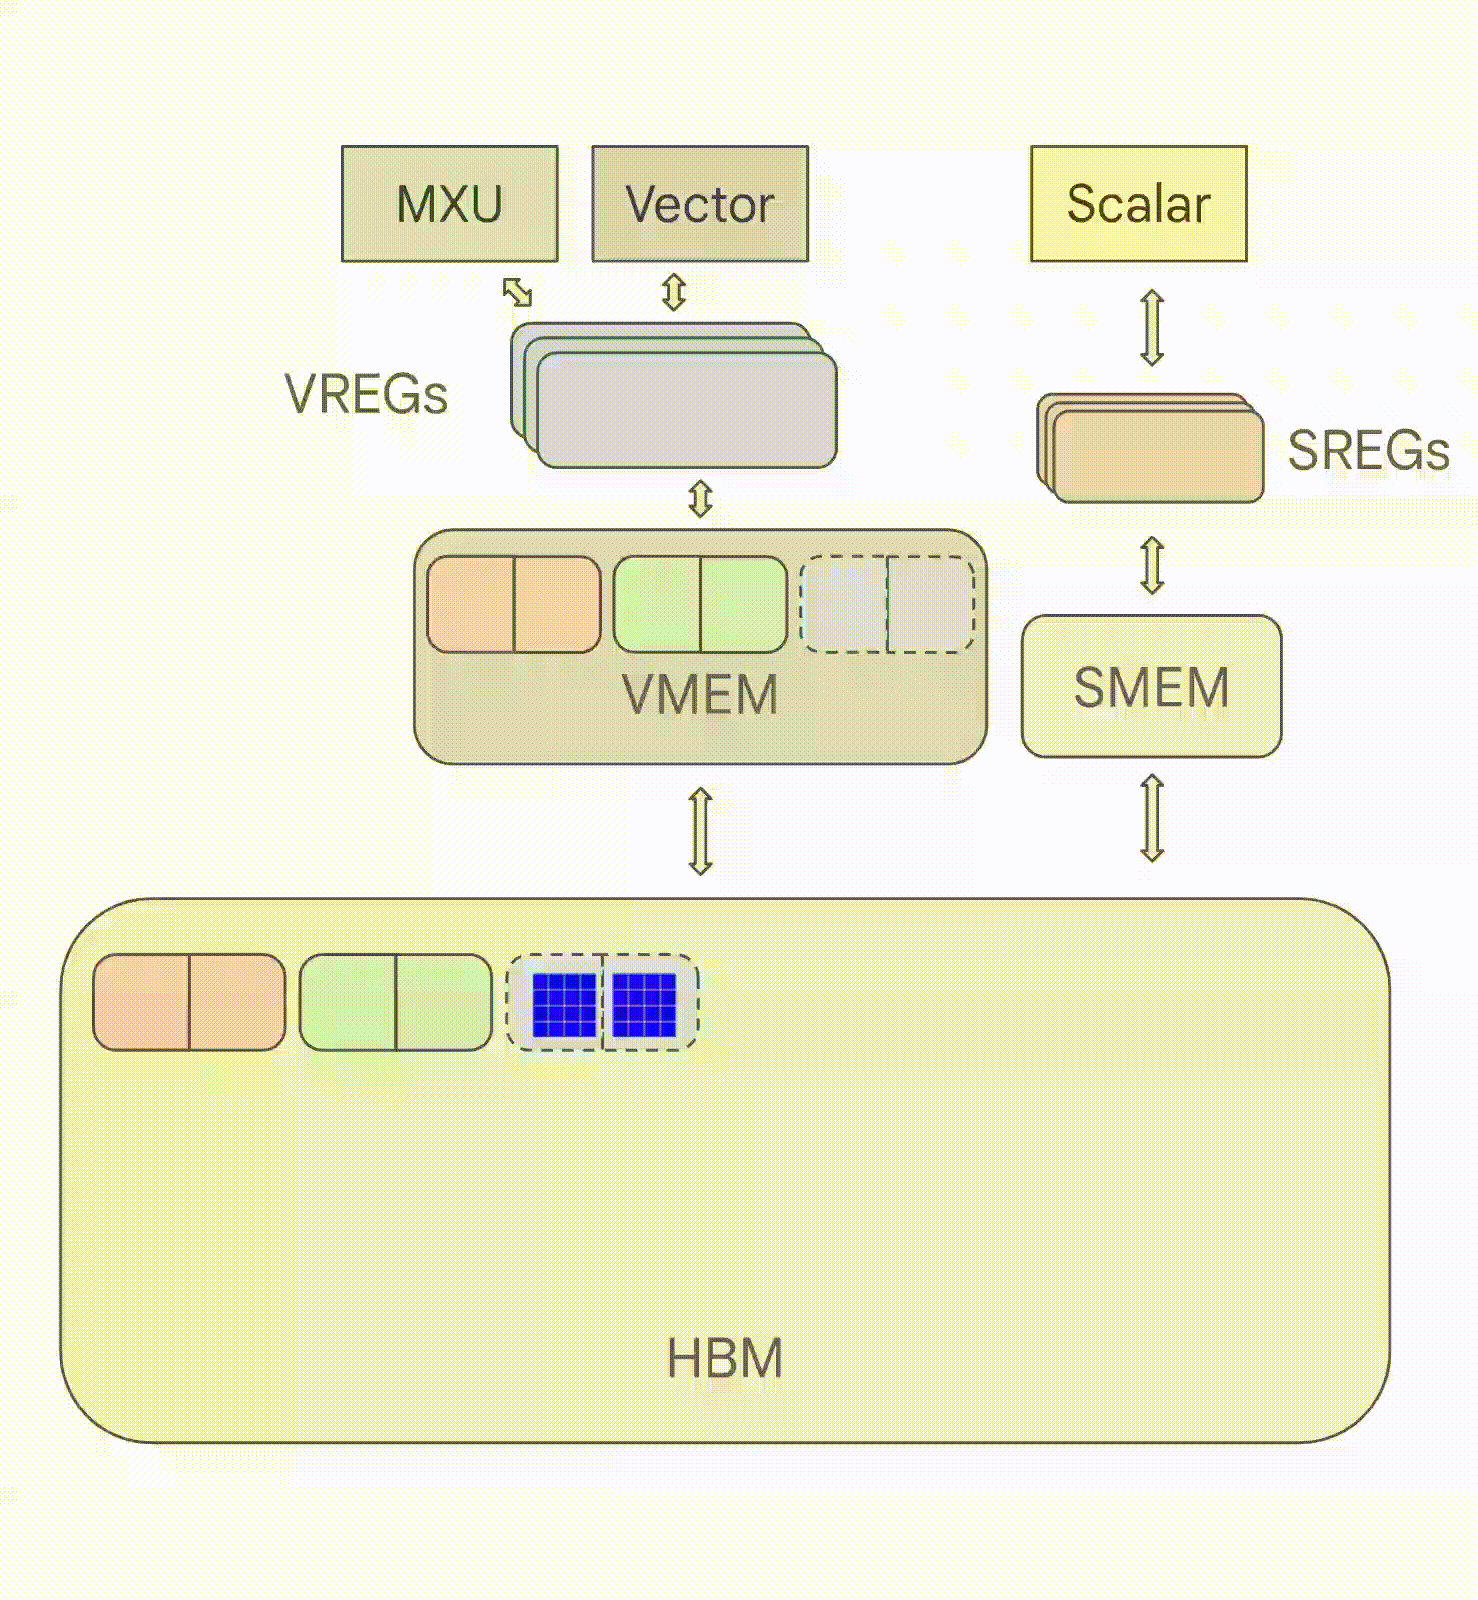
1부는 roofline 분석과, 스케일링 능력을 제한하는 요인들(통신, 연산, 메모리)을 설명한다. 2부와 3부는 TPU가 개별 칩으로서, 그리고 — 결정적으로 중요하게 — bandwidth와 latency가 제한된 칩 간 링크로 상호 연결된 시스템으로서 어떻게 동작하는지 자세히 다룬다. 다음과 같은 질문에 답할 것이다:
- 특정 크기의 행렬 곱셈은 얼마나 걸려야 하는가? 어느 지점부터 연산에, 혹은 메모리·통신 bandwidth에 발목을 잡히는가?
- TPU들은 어떻게 서로 연결되어 학습 클러스터를 이루는가? 시스템의 각 부분은 bandwidth를 얼마나 갖는가?
- 배열을 여러 TPU에 걸쳐 gather·scatter·재분배하는 데 시간이 얼마나 걸리는가?
- 디바이스마다 서로 다르게 분산되어 있는 행렬들을 어떻게 효율적으로 곱하는가?
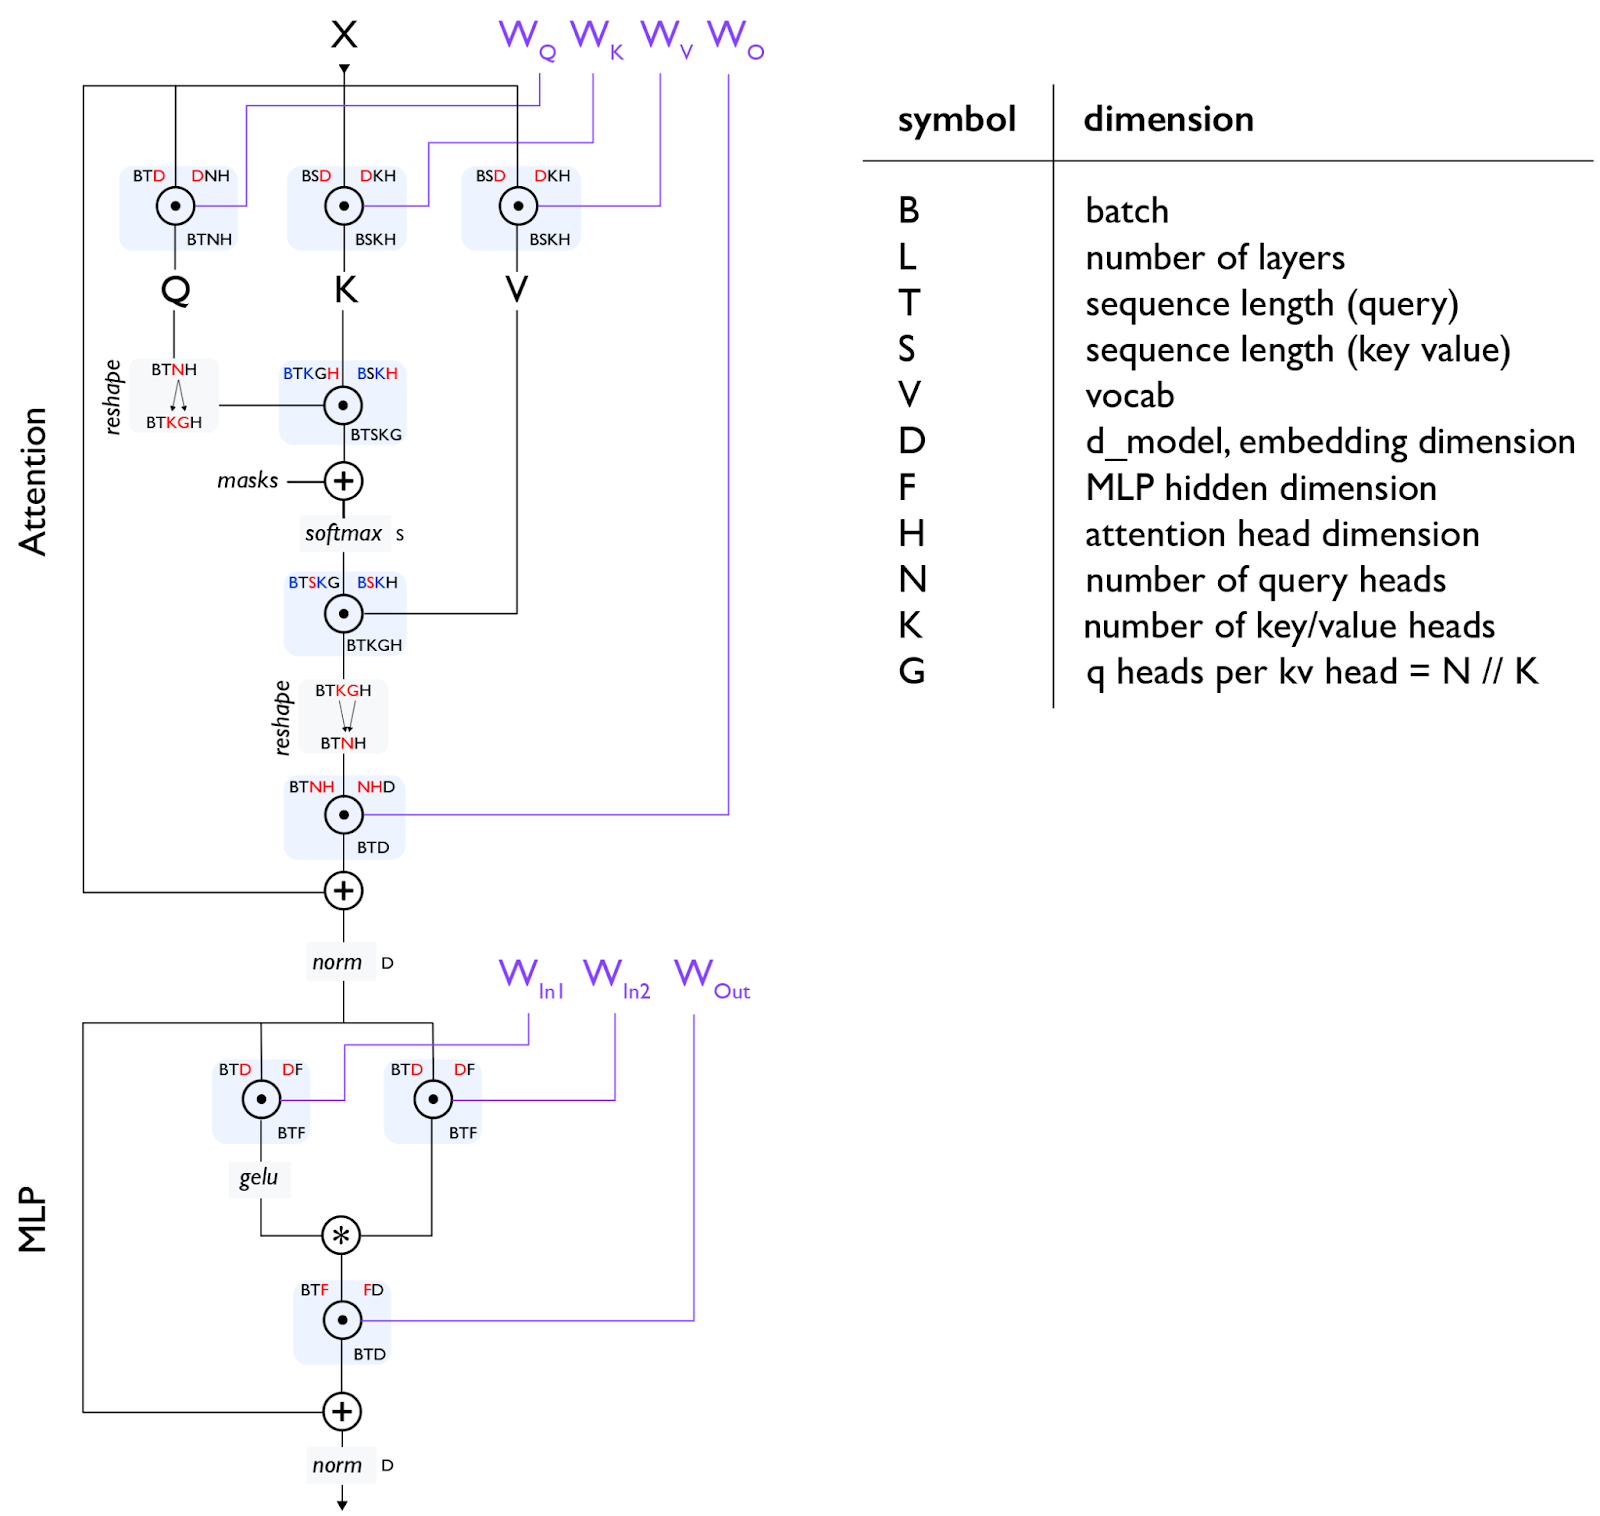
5년 전 ML에는 ConvNet, LSTM, MLP, Transformer 등 다채로운 아키텍처들의 지형이 있었지만, 지금은 대부분 Transformer만 남았다[Vaswani et al.]. 우리는 Transformer 아키텍처의 모든 조각을 이해할 가치가 충분하다고 굳게 믿는다: 모든 행렬의 정확한 크기, normalization이 일어나는 위치, 각 부분에 파라미터와 FLOPs4가 얼마나 들어 있는지. 4부는 이 “Transformer 수학”을 꼼꼼히 짚으며, 학습과 추론 모두에 대해 파라미터와 FLOPs를 세는 법을 보여준다. 이로부터 모델이 메모리를 얼마나 쓸지, 연산과 통신에 시간을 얼마나 쓰게 될지, 그리고 attention이 feed-forward 블록 대비 언제 중요해지는지를 알 수 있다.
5부: 학습과 7부: 추론은 이 책의 핵심으로, 근본적인 질문을 논한다: 어떤 크기의 모델과 어떤 수의 칩이 주어졌을 때, 어떻게 병렬화해야 “strong scaling” 영역에 머무를 수 있는가? 단순한 질문이지만 답은 놀랍도록 복잡하다. 크게 보면 모델을 여러 칩에 나누는 데 쓰이는 주요 병렬화 기법은 네 가지(data, tensor, pipeline, expert)이고, 메모리 요구량을 줄이는 여러 다른 기법(rematerialization, optimizer/model sharding(일명 ZeRO), host offload, gradient accumulation)이 있다. 이들 중 다수를 여기서 논의한다.
이 부분들을 다 읽고 나면 새로운 아키텍처나 새로운 설정에 맞는 기법을 스스로 골라낼 수 있기를 바란다. 6부와 8부는 이 개념들을 인기 있는 오픈소스 모델 LLaMA 3에 적용해 보는 실전 튜토리얼이다.
마지막으로 9부와 10부는 이 아이디어들 중 일부를 JAX로 구현하는 방법과, 뭔가 잘못됐을 때 코드를 프로파일링하고 디버깅하는 방법을 살펴본다. 12부는 GPU를 파고드는 새로 추가된 부다.
책 전반에 걸쳐 직접 풀어볼 수 있는 문제들을 담으려 했다. 모든 부를 다 읽어야 한다거나 순서대로 읽어야 한다는 부담은 갖지 말길 바란다. 그리고 피드백을 남겨 달라. 당분간 이 책은 초안 상태이며 계속 다듬어질 것이다. 고맙다!
이 책의 많은 아이디어를 이끌어낸 James Bradbury와 Blake Hechtman에게 감사를 전한다.
그럼 각설하고, TPU roofline을 다루는 1부는 여기에 있다.
각 부 링크
이 시리즈는 필요 이상으로 길지도 모르지만, 그렇다고 겁먹지는 않았으면 한다. 처음 세 장은 예비 지식이라 이미 익숙한 내용이라면 건너뛰어도 되지만, 뒤에서 쓰일 표기법을 소개하는 장들이기도 하다. 마지막 세 부는 실제 모델을 다루는 방법을 설명하므로 실용적으로는 가장 유용할 것이다.
Part 1: 예비 지식
-
1장: Roofline 분석 간단 소개. 알고리즘은 세 가지 — 연산, 통신, 메모리 — 의 제한을 받는다. 이를 이용해 알고리즘이 얼마나 빨리 돌지 어림할 수 있다.
-
2장: TPU에 대해 생각하는 법. TPU는 어떻게 동작하는가? 그 동작 방식이 학습시키고 서빙할 수 있는 모델에 어떤 영향을 주는가?
-
3장: Sharding된 행렬과 그 곱셈법. 여기서는 우리의 최애 연산인 (sharding된) 행렬 곱셈을 통해 모델 sharding과 멀티 TPU 병렬화를 설명한다.
Part 2: Transformer
-
4장: 알아야 할 모든 Transformer 수학. Transformer는 forward pass와 backward pass에서 FLOPs를 얼마나 쓰는가? 파라미터 수를 계산할 수 있는가? KV cache의 크기는? 여기서 그 수학을 차근차근 짚는다.
-
5장: 학습을 위해 Transformer를 병렬화하는 법. FSDP. Megatron sharding. Pipeline parallelism. 칩이 몇 개 주어졌을 때, 주어진 크기의 모델을 주어진 batch size로 최대한 효율적으로 학습시키려면 어떻게 해야 하는가?
-
6장: TPU에서 LLaMA 3 학습시키기. LLaMA 3를 TPU에서 학습시키려면 어떻게 해야 할까? 시간은 얼마나 걸릴까? 비용은 얼마나 들까?
-
7장: Transformer 추론의 모든 것. 모델을 학습시켰으면 이제 서빙해야 한다. 추론은 latency라는 새로운 고려 사항을 더하고 메모리 지형을 바꿔 놓는다. disaggregated serving이 어떻게 동작하는지, KV cache를 어떻게 생각해야 하는지 이야기한다.
-
8장: TPU에서 LLaMA 3 서빙하기. TPU v5e에서 LLaMA 3를 서빙하면 비용이 얼마나 들까? latency와 throughput의 트레이드오프는 어떤가?
Part 3: 실전 튜토리얼
-
9장: TPU 코드 프로파일링하는 법. 실제 LLM은 위의 이론처럼 단순한 법이 없다. 여기서는 JAX + XLA 스택을 설명하고, JAX/TensorBoard 프로파일러로 실제 문제를 디버깅하고 고치는 법을 다룬다.
-
10장: JAX로 TPU 프로그래밍하기. JAX는 연산을 병렬화하는 마법 같은 API를 여럿 제공하지만, 쓰는 법을 알아야 한다. 재미있는 예제와 연습 문제가 있다.
Part 4: 결론과 보너스
-
11장: 결론과 더 읽을거리. 맺음말과 TPU·LLM에 관한 더 읽을거리.
-
12장: GPU에 대해 생각하는 법. GPU에 관한 보너스 부. GPU는 어떻게 동작하고, 어떻게 네트워크로 연결되며, 그 roofline은 TPU와 어떻게 다른가.
Footnotes
-
역사적으로 ML 연구는 시스템 혁신과 소프트웨어 개선 사이를 오가는 일종의 틱톡(tick-tock) 사이클을 따라왔다. Alex Krizhevsky는 CNN을 빠르게 만들기 위해 끔찍한 CUDA 코드를 써야 했지만, 몇 년 지나지 않아 Theano나 TensorFlow 같은 라이브러리 덕분에 그럴 필요가 없어졌다. 여기서도 같은 일이 일어나 몇 년 뒤에는 이 책의 모든 내용이 추상화 뒤로 사라질지도 모른다. 하지만 scaling law는 우리 모델을 끊임없이 하드웨어의 최전선으로 밀어붙여 왔고, 가까운 미래에는 최첨단 연구를 하는 일이 모델을 큰 하드웨어 토폴로지로 효율적으로 스케일링하는 방법에 대한 이해와 떼려야 뗄 수 없이 얽혀 있을 가능성이 높다. ↩
-
연산 시간이 줄어들면 단일 칩 수준의 병목도 마주치게 되는 것이 보통이다. 새로 들인 반짝이는 TPU나 GPU는 초당 500조 회 연산이 가능하다고 적혀 있지만, 조심하지 않으면 파라미터를 메모리에서 이리저리 옮기느라 허우적대며 그 10분의 1밖에 못 낼 수도 있다. 칩당 연산, 메모리 bandwidth, 총 메모리 사이의 상호작용이 스케일링 이야기의 핵심이다. ↩
-
하드웨어 설계자는 정반대의 문제를 마주한다: 비용을 최소화하면서 우리 알고리즘에 딱 필요한 만큼의 연산·bandwidth·메모리를 제공하는 하드웨어를 만드는 것이다. 이 “co-design” 문제가 얼마나 스트레스가 심할지 상상해 보라. 첫 칩이 실제로 나오는 시점 — 보통 2~3년 뒤 — 에 알고리즘이 어떤 모습일지에 베팅해야 한다. TPU의 이야기는 이 게임에서 거둔 대단한 성공 사례다. 행렬 곱셈은 메모리 바이트당 FLOPs를 거의 어떤 알고리즘보다도 많이 쓴다는 점(바이트당 N FLOPs)에서 독특한 알고리즘이고, 초기 TPU와 그 systolic array 아키텍처는 만들어질 당시의 GPU보다 훨씬 나은 성능/달러를 달성했다. TPU는 ML 워크로드를 위해 설계되었고, GPU도 Tensor Core를 앞세워 이 틈새를 채우는 방향으로 빠르게 변하고 있다. 하지만 만약 신경망이 뜨지 않았거나, (GPU보다 본질적으로 유연성이 떨어지는) TPU가 감당할 수 없는 근본적인 변화가 일어났다면 그 비용이 얼마나 컸을지 상상해 보라. ↩
-
FLoating point OPs의 준말로, 사실상 필요한 덧셈과 곱셈의 총 횟수다. 많은 자료에서 FLOPs를 “초당 연산 횟수”의 의미로 쓰지만, 우리는 그 의미일 때는 FLOPs/s로 명시해서 쓴다. ↩